ثورة جديدة من (ميتا) (سام أوديو)!
تُرجم تلقائيًا
 مشرف
Meta AI, görüntü işleme dünyasında büyük yankı uyandıran "Segment Anything Model" (SAM) mimarisini ses dünyasına uyarlayarak, yapay zeka ekosisteminde yeni bir paradigmayı başlattı. SAM Audio, karmaşık akustik ortamlardaki ses objelerini tanımlama, ayrıştırma ve izole etme yeteneğiyle dijital ses işleme standartlarını kökten değiştirmeyi hedeflemektedir. Bu model, tıpkı görsel versiyonunun bir fotoğraftaki her nesneyi tek tek seçebilmesi gibi, bir ses kaydı içindeki her bir işitsel öğeyi bağımsız birer "obje" olarak ele almaktadır.
SAM Audio Nedir?
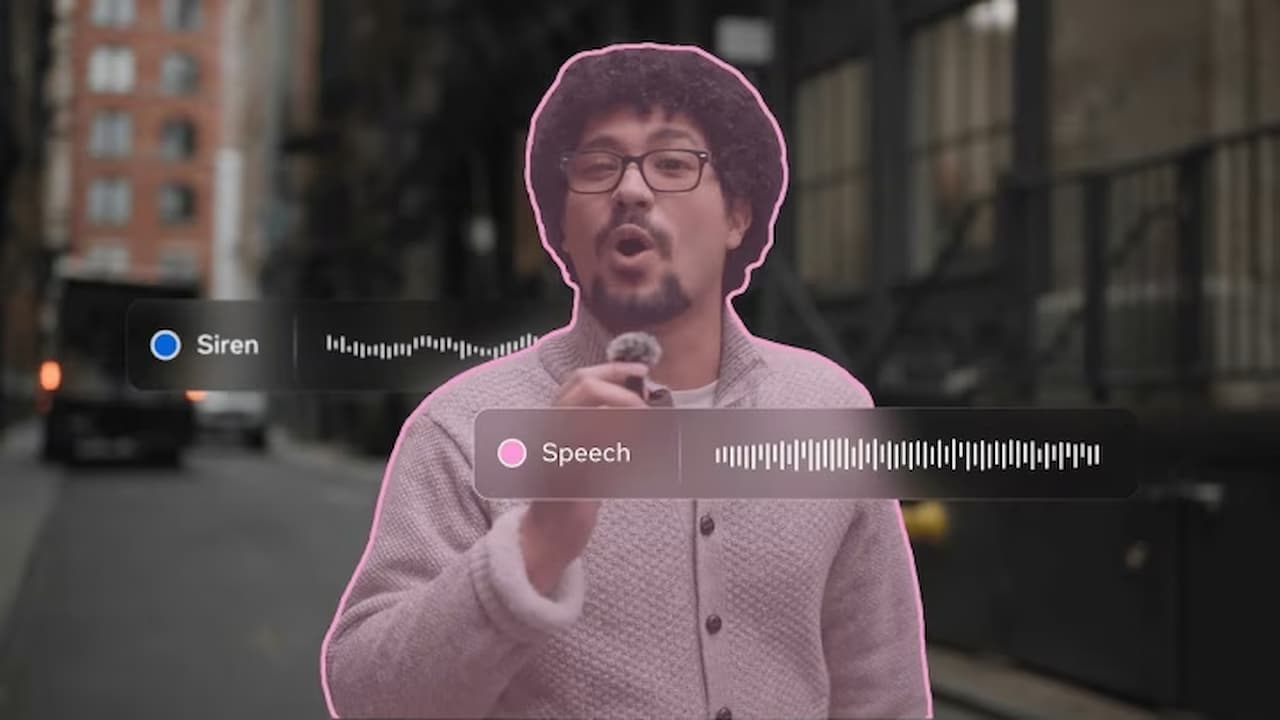
SAM Audio, karmaşık ve çok sesli ortamlarda bulunan her bir ses kaynağını (insan sesi, enstrüman, hayvan sesi, mekanik gürültü vb.) bağımsız birer "işitsel nesne" olarak tanımlayan ve bunları birbirinden kusursuzca ayıran bir yapay zeka temel modelidir. Geleneksel ses düzenleme yazılımlarının aksine, bu model sesi sadece bir dalga biçimi olarak değil, her biri farklı karakterlere sahip parçaların birleşimi olarak görür. Bu durum, kullanıcılara bir ses kaydı üzerinde sanki bir fotoğrafın parçalarını kesip yapıştırıyormuşçasına özgürlük tanır.
Teknik Kapasite ve Rekabet Analizi
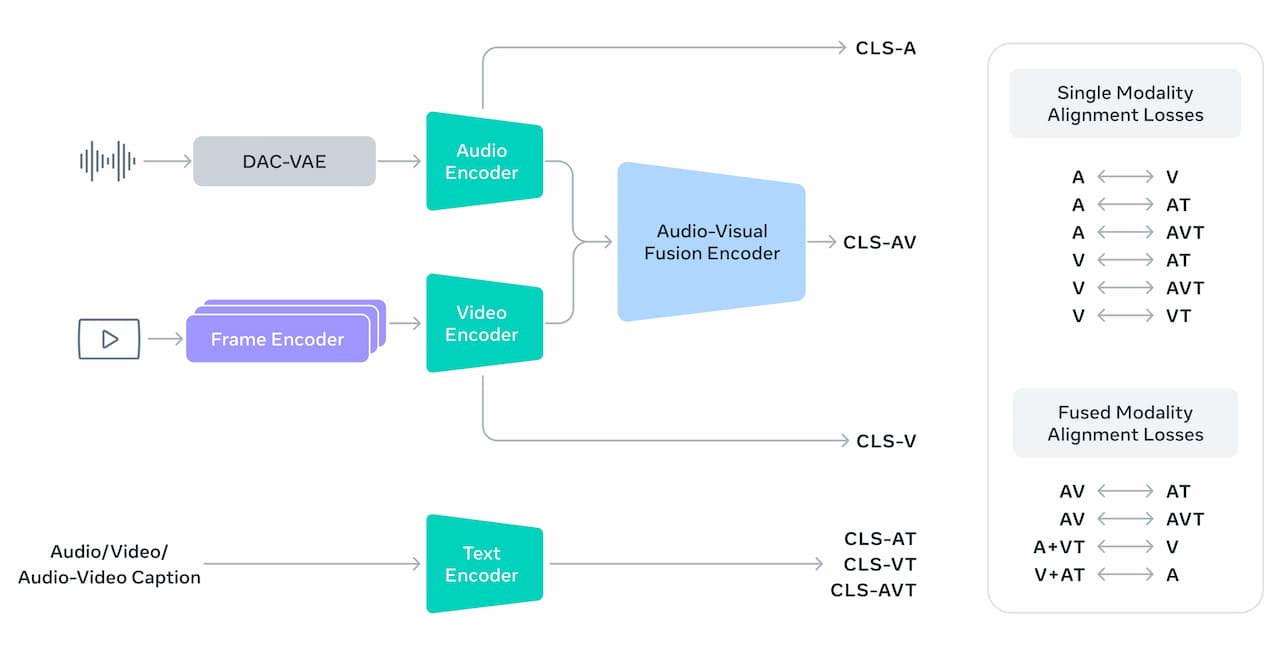
SAM Audio'nun başarısının arkasında, Meta'nın Transformer tabanlı mimarisi ve devasa bir ses kütüphanesi üzerinde gerçekleştirdiği eğitim yatmaktadır. Bilgisayarlar için ses normalde iç içe geçmiş karmaşık frekanslardan ibarettir. Ancak SAM Audio, bu karmaşayı şu yöntemlerle çözer:
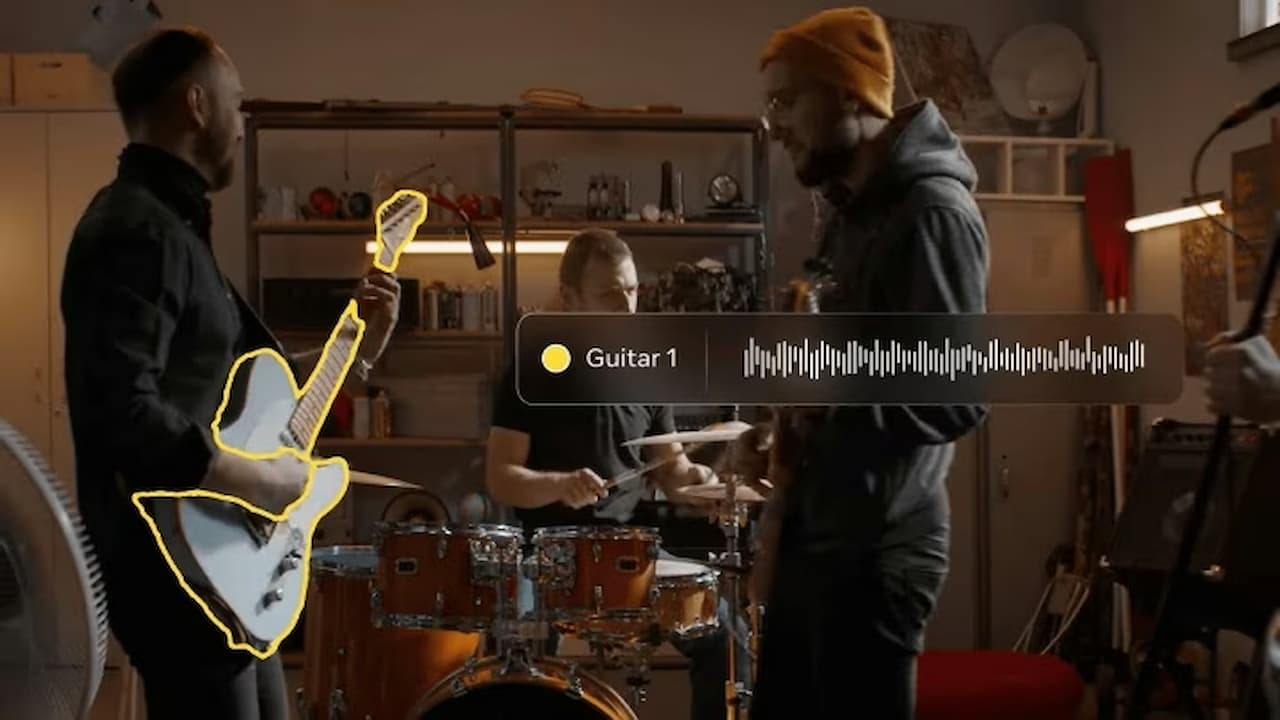
- Akustik İmza Analizi: Model, her sesin kendine has bir "parmak izi" olduğunu bilir. Bir kemanın teliyle bir gitarın telinden çıkan sesin dokusal farkını anlar ve bunları ayrı katmanlara yerleştirir.
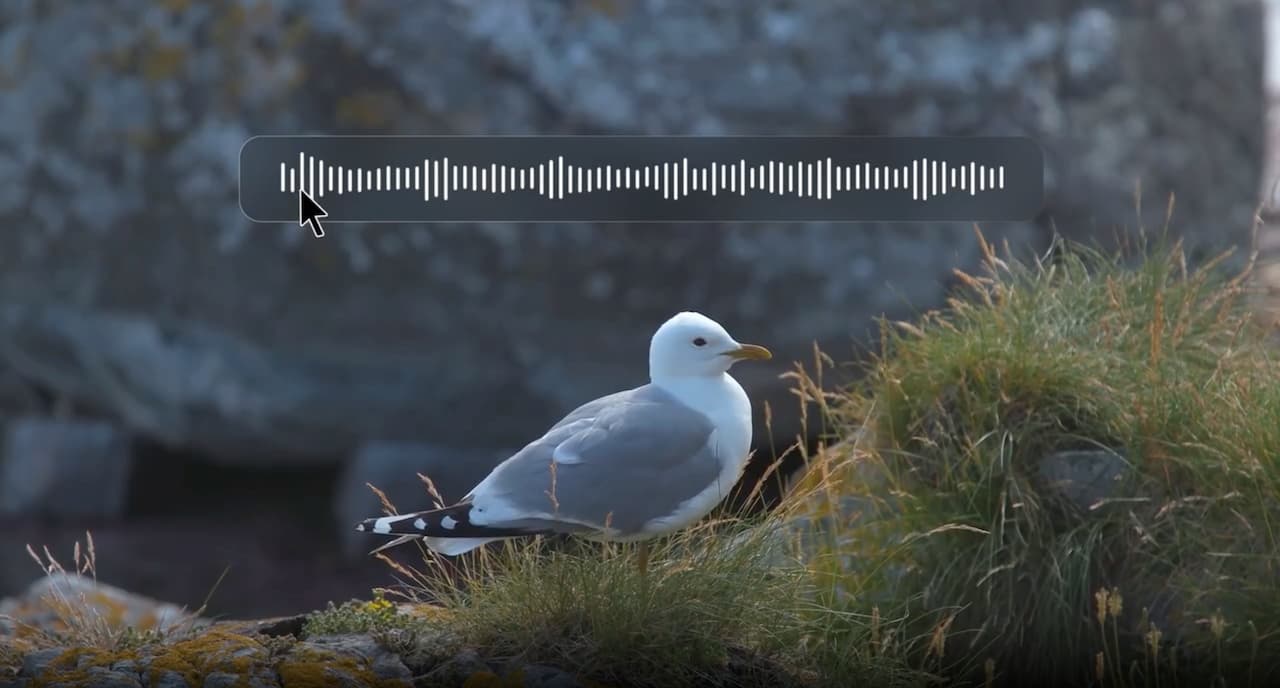
- Sıfır Örnekli Öğrenme: Bu terim, modelin daha önce hiç karşılaşmadığı bir sesi bile "yabancı ve ayrı bir ses" olarak algılayabilmesi anlamına gelir. Örneğin, yeni üretilen bir elektrikli süpürgenin sesini, eğitim setinde olmasa dahi arka plandaki televizyon sesinden ayırabilir.
- الطلب التفاعلي: عندما يَقُولُ المستعملُ "فقط يَحْملُ المتكلمَ" أَو "دعْ صوتَ الطيرَ على الخلفيةِ "، النموذج يُعزلُ الجزءَ الصوتيَ المقابلَ بتجهيز هذه أوامرِ اللغةِ الطبيعيةِ فوراً.
- القيود: ولا تزال الأصوات المشابهة لبعضها البعض (مثل صوتين متحدثين مماثلين) تجتذب صعوبة. وبالإضافة إلى ذلك، فإنها لا تحقق فصلا تلقائيا تماما؛ ومن المؤكد أنها تتوقع نصا أو تلميحا بصريا أو زمنيا.
- Adım 1: Meta AI'ın resmi "Segment Anything" web sayfasına gidin.
- Adım 2: Demo bölümünde bir ses dosyası yükleyin.
- Adım 3: Spektrogram (sesin görsel haritası) üzerinde ayırmak istediğiniz bölgeyi tıklayın veya metin kutusuna "sadece insan sesini bırak" gibi bir komut yazın.
- Adım 4: Modelin ayrıştırdığı ses katmanlarını tek tek dinleyin ve indirin.
- Kod Erişimi: Meta'nın GitHub sayfasından modelin ağırlıklarını ve kodlarını bilgisayarınıza indirebilirsiniz.
- Hugging Face: Bu modelin topluluk tarafından optimize edilmiş versiyonlarını Hugging Face üzerinden tarayıcı üzerinde doğrudan test edebilirsiniz.
- API Kullanımı: Kendi uygulamalarınızı geliştirmek için modelin kütüphanelerini projenize dahil edebilirsiniz.
- Erişilebilirlik: İşitme cihazlarında "Kokteyl Partisi Problemi"ni çözer. Kafe veya restoran gibi gürültülü ortamlarda; çatal-bıçak ve uğultu gibi "gürültü nesnelerini" silerek sadece hedeflenen konuşmacının sesini berraklaştırır.
- Prodüksiyon: Sinema ve içerik üretiminde çekim hatalarını minimize eder. Dış çekimlerde diyaloğu bozmadan arkadan geçen bir ambulans sirini veya rüzgar sesi kayıttan "cımbızla çekilir gibi" çıkarılabilir. Müzisyenler ise eski kayıtları vokal ve enstrümanlarına saniyeler içinde ayırabilir.
- Güvenlik ve Bilim: Şehir güvenliğinde cam kırılması veya çığlık gibi spesifik sesleri anında tespit eder. Doğa bilimlerinde ise karmaşık bir orman kaydı içinden tek bir canlı türünün sesini izole ederek ekolojik takibi kolaylaştırır.
الأجهزة السمعية البصرية الحاليةOpenAITags ElevenLabs وما إلى ذلك) "تقصد الكلام" وهو مركز؛ أي يأخذ نصا ويحوله إلى صوت بشري. لكن سام أوديو "الفصل والتلاعب" نموذج هذا يجلبه إلى موقع "ميمار" بدلاً من "المنتج" الذي يمكن أن يفصل ويعيد إدارة أجزاء الكون الصوتي
اعتراض على الصوت
وتنتج نماذج مثل ElevenLabs الصوت ككل واحد. SAM وتُعرِّف " أوديو " كل عنصر في ملف صوتي (مثل الضوضاء المكيفة جواً في الخلفية، وصوت النفس للمتكلم، وتردد الصوت في الغرفة) على أنه أجسام مستقلة.
الفرق: بينما العارضات الأخريات يحاولون طباعة الضوضاء، صوت (سام أوديو) وهذا لا يمكن أن يزيل سوى جزء غير مرغوب فيه بدقة جراحية دون المساس بالصوت الأصلي على الإطلاق.
الطبيعة والتوعية الصوتية
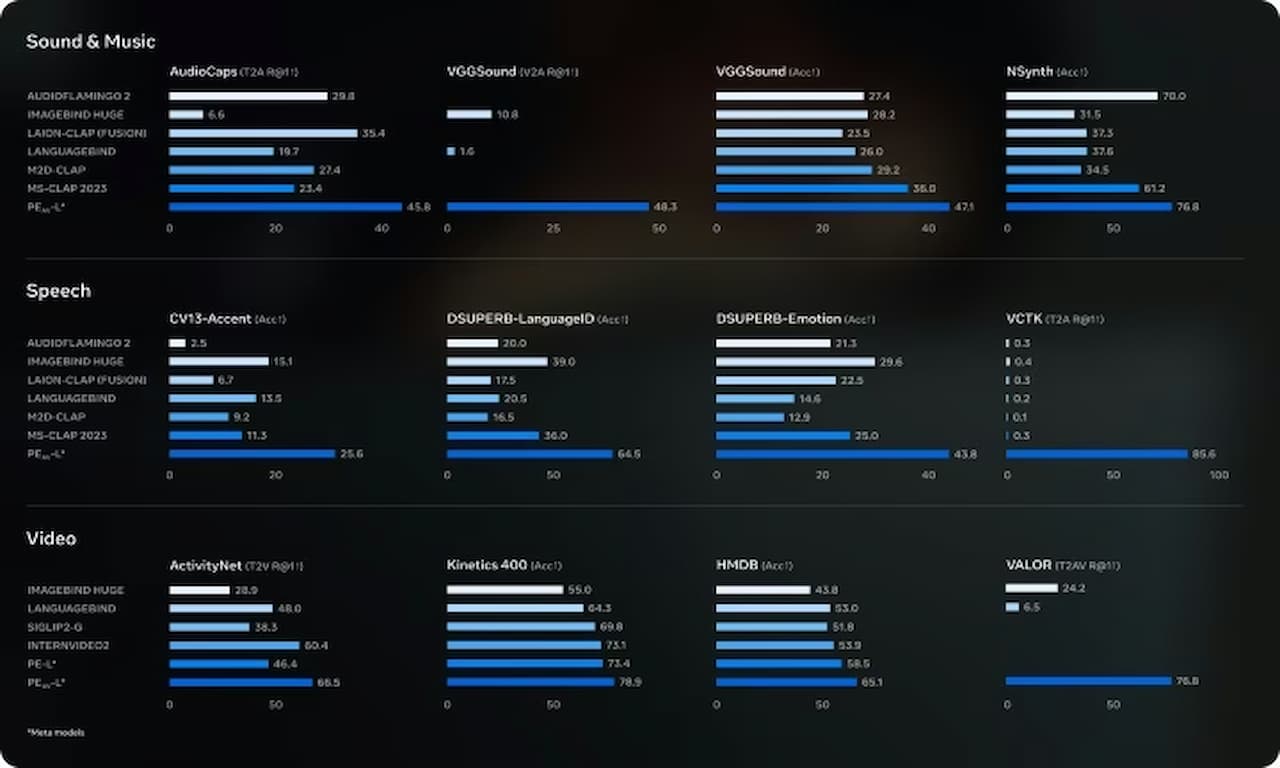
Although OpenAI وتقدم نماذج الصوت درجة عالية من الطبيعية، وغالبا ما تعطي أفضل النتائج في بيئات معقمة تشبه الاستوديو. التفوق التقني لسام أوديو مكان الإقامة مفهوم
Emo Toning: (سام أوديو) يحلل ليس فقط تردد الصوت، بلهجات عاطفية في الداخل، ويتوقف كـ(انلامسال) ولها القدرة على التجهيز عن طريق التمييز بين الصوت من الاهتزازات (الهيثام) بأن الصوت يخاف أو يهتف.
Düşük Gecikme Süresi ve Verimlilik
SAM Audio, Meta'nın "Efficient Segmenter" mimarisi üzerine kurulmuştur. Bu mimari, ses verisini işlerken tüm dosyayı okumak yerine, sesi küçük "token"lara ayırarak eş zamanlı işlem yapar.
Teknik Avantaj: Diğer modellerin karmaşık işlemleri (ses klonlama veya temizleme) bulut sunucularında uzun süreler alırken, SAM Audio optimize edilmiş yapısı sayesinde çok daha düşük gecikme süreleriyle çalışır. Bu da onu canlı yayınlar ve gerçek zamanlı çeviriler için rakiplerinden bir adım öne çıkarır.
Zero-Shot Kapasitesi ve Esneklik
OpenAI ve ElevenLabs modelleri genellikle belirli diller ve ses tonları üzerine yoğun bir eğitim gerektirir. SAM Audio ise "Zero-shot" kapasitesiyle, hayatında hiç duymadığı bir sesi (örneğin çok nadir bir müzik aleti) anında tanımlayıp diğer seslerden izole edebilir. Bu, modelin önceden tanımlanmış kategorilere hapsolmadığını kanıtlar.
Nasıl Kullanılır?
Meta, SAM Audio modelini (araştırma aşamasında olduğu için) henüz WhatsApp veya Instagram gibi uygulamalara son kullanıcı için bir "tuş" olarak eklemedi. Ancak bu teknolojiyi kullanmanın şu an için iki ana yolu bulunuyor:
Meta AI Demo ve Araştırma Sayfaları
Meta, yeni modellerini genellikle Meta AI Research web sitesi üzerinden etkileşimli demolarla sunar.
Geliştiriciler ve Teknik Kullanıcılar İçin
SAM Audio, açık kaynak kodlu bir temel modeldir. Eğer temel düzeyde Python bilginiz varsa veya bir yazılımcıysanız:
Kullanım Alanları ve Günlük Hayata Etkileri
SAM Audio, işitsel veriyi parçalarına ayırabilme yeteneğiyle teorik bir başarıdan öte, pratik ve güçlü bir araçtır:
Seslerin bu denli kusursuz manipüle edilebilmesi, dijital sahtecilik (deepfake) ve gizlilik ihlali risklerini de beraberinde getirmektedir. Ancak Meta, bu modeli daha çok yaratıcılık ve erişilebilirlik odaklı bir teknoloji olarak konumlandırmaktadır.
هذا النموذج في المستقبل القريب نظم تشغيل الهواتف الذكية متكامل وسيعني ذلك التحرير الفوري للضوضاء البيئية في المكالمات الهاتفية دون الحاجة إلى برمجيات مهنية من الطبقات السمعية في أشرطة الفيديو الملتقطة.
كيف تستخدم في المستقبل القريب؟
وعندما تصبح التكنولوجيا أحدث، فإنها ستدخل حياتنا بهذه الطريقة دون الحاجة إلى معرفة تقنية خاصة:
Meta سام أوديو فالتكنولوجيا تحول الصوت إلى أجسام رقمية يمكن التحكم بها من بيانات بسيطة. الهواتف الذكية على عكس الضوضاء القياسية، الصوت يجعل التدخل الجراحي من خلال الاعتراض. وفي مكالمة هاتفية، يفصل الطفل الذي يبكي على ظهره أو ضوضاء الشارع تماما عن المتكلم؛ وتدمر الأصوات الخارجية بدقة الاستوديو، ولا يُنقل سوى صوت واضح إلى الجانب الآخر.
وسائط الإعلام الاجتماعية وتحرير الفيديو النموذج يعطي المستعمل "ممسحة بصرية" بفصل القناة الصوتية إلى قطع مثل الجيغاسو. وفي مرحلة التحميل بالفيديو، يمكن حذف الأصوات غير المرغوبة من الأصوات الآلية المحددة مثل الرياح أو الطيور أو حركة المرور بنقرة واحدة. SAM (أوديو) يسمح لكِ بإنتاج محتوى ذو جودة مهنية بملء التجويف الصوتي المحذف بصمت طبيعي
أجهزة الاستماع في الحقل، "مشكلة حزب كوكتيل". شكراً لمستخدمي "الطريقة العنيفة" يمكن أن يكُونوا و يغاروا على الطاولة الجانبية وتحسن هذه التكنولوجيا التفاعل الاجتماعي من الجذر، مما يسمح للجهاز بأن ينقل فقط الأصوات المستهدفة في الكريستال.
مشرفHIX AI: Çok Yönlü İçerik Üretim Platformu Rehberi
Stream Ring: Yapay Zeka ile Güçlendirilmiş Akıllı Yüzük Satışa Açıldı!