



ما هو "ديب سيك ف-3-1" نموذج الإستخبارات الأثرية في الهواء الطلق؟?
تُرجم تلقائيًا
Çin merkezli yapay zeka girişimi DeepSeek, 21 Ağustos 2025’te yeni modeli DeepSeek V3.1’i duyurdu. Hibrit mimarisi, 128K bağlam kapasitesi ve düşük maliyetli API erişimiyle dikkat çeken bu açık kaynaklı yapay zeka modeli, yalnızca teknoloji alanında değil, küresel ekonomi ve inovasyon ortamında da dengeleri değiştirme potansiyeli taşıyor.
DeepSeek V3.1 Nedir?
DeepSeek V3.1 Çin’in yükselen yapay zeka girişimlerinden DeepSeek tarafından geliştirilen ve açık kaynaklı yapay zeka modeli olarak piyasaya sürülen en yeni dil modelidir. Burada “açık kaynak” ifadesi, modelin kodlarının, parametrelerinin ve kullanım yönergelerinin herkese açık olması demektir. Bu durum, yapay zeka geliştirme süreçlerini demokratikleştiriyor; yani yalnızca dev teknoloji şirketlerinin değil, üniversitelerin, bağımsız araştırmacıların ve küçük girişimlerin de bu teknolojiyi kullanabilmesini sağlıyor.
DeepSeek V3.1, 671 milyar parametreye sahip devasa bir yapay zeka modeli. Parametre, yapay zekanın öğrenme sürecinde ayarladığı değişkenlere verilen isimdir. Bir modelin parametre sayısı arttıkça, karmaşık ilişkileri daha iyi öğrenebilme kapasitesi artar. Ancak DeepSeek, bu parametrelerin tamamını aynı anda çalıştırmak yerine, yalnızca 37 milyarını aktif kullanıyor. Bu yöntem, yapay zeka literatüründe Mixture of Experts (MoE) yani uzman karışımı mimarisi olarak biliniyor.
MoE mimarisinde, farklı uzman ağlar belirli görevlerde devreye giriyor. Bu sayede model hem daha hızlı hem de daha verimli çalışıyor. Örneğin bir kullanıcı programlama sorusu sorduğunda, yalnızca kodlama uzmanı devreye giriyor; edebiyat sorusu geldiğinde ise dil ve yazın uzmanı çalışıyor. Bu yapı, DeepSeek V3.1’in rakiplerine göre daha düşük enerji tüketimi ile benzer hatta üstün performans göstermesini mümkün kılıyor.
DeepSeek V3.1 Özellikleri
ونقطة DeepSeek V3.1 ليست فقط مصدرا مفتوحا لأنها نموذج يجذب الانتباه في العالم من الذكاء الاصطناعي، وإنما له أيضا سمات تقنية مبتكرة. وقد صممت تفاصيل كثيرة من الهيكل النموذجي إلى نافذة السياق لتلبية مختلف الاحتياجات.
One of the most spoken features of DeepSeek V3.1, hybrid mode system. وللنموذج طريقة عمل مختلفة:
أسلوب التفكير (الطريقة النهائية): ويمر النموذج بعملية " التفكير الداخلي " قبل حل مسألة معقدة. وهذا يعني الخطوات المنطقية لتحفيز العقل قبل إصدار جواب AI. طريقة التفكير أبطأ، ولكنها تنتج استجابات أعمق وأكثر اتساقا.
أسلوب عدم التفكير (أسلوب الاستجابة المتوخى): وينتج النموذج استجابة سريعة مباشرة. ويفضل هذا الأسلوب في أسئلة سطحية أو محادثات يومية. وتوفر هذه السمة للمستعملين مرونة كبيرة. فعلى سبيل المثال، يمكن لمطور البرمجيات أن يختار طريقة " التفكير " في مشكلة معقدة من مشاكل التحلل، وهي شركة أنشأت جهازا لدعم العملاء يمكن أن تستجيب بسرعة باختيار أسلوب " غير مفكر " .
وثمة سمة أخرى من سمات النموذج هي طريقة " MoE - Mixture of Experts (Experts Mix) " . وفي هذا النظام، هناك العديد من النماذج الفرعية المتخصصة في مسائل مختلفة. عندما يعطي المُستخدم أمرًا، فإن النموذج لا يُفعّل إلاّ تلك اللازمة من هذه النماذج الفرعية. وينطوي هذا النهج على ميزتين هامتين:
ولا تُنفق أي طاقة معالجة غير ضرورية، لذا تخفض التكلفة.
وبفضل الجمع بين النماذج المتخصصة، يرتفع معدل دقة الردود.
DeepSeek V3.1, especially as a LLM (Great Language Model) NLP (Natural Language Processing) قوية في الميدان وهذا يعني أن للنموذج القدرة على فهم اللغة البشرية وإنتاجها وتحويلها. ويمكن للمستعملين استخدام DeepSeek في العديد من الميادين المختلفة، مثل خلاص النصوص، والترجمة، وطرح الأسئلة، وتحليل الشعور أو كتابة الرموز. ويشكل الدعم المتعدد اللغات بصفة خاصة ميزة هامة بالنسبة لمختلف فئات المستعملين على الصعيد العالمي.
DeepSeek V3.1, önceki versiyonlara göre çok daha büyük bir eğitim sürecinden geçti. 32K bağlam penceresi eğitimi: 630 milyar token (kelime parçacığı) üzerinde çalıştırıldı. Bu, V3 sürümünden 10 kat daha fazla eğitim verisi anlamına geliyor.
128K bağlam penceresi eğitimi: 209 milyar token ile eğitildi. Bu da önceki sürümlere göre 3,3 kat daha fazla. “Bağlam penceresi (context window)”, modelin aynı anda hatırlayabildiği metin uzunluğunu ifade ediyor. 128K bağlam desteği, yaklaşık 400 sayfalık bir kitabı aynı anda analiz etmesini sağlıyor. Bu, hukuk, akademi, tıp ve yazılım gibi çok uzun metinlerin işlendiği alanlarda ciddi bir avantaj.
DeepSeek V3.1, sahip olduğu hibrit yapı ve MoE sistemi sayesinde rakiplerine kıyasla çok daha düşük maliyetle çalışır. Çin merkezli bağımsız testlere göre model, bazı rakiplerine kıyasla 40 kata kadar daha ucuz işlem maliyetleri sunmaktadır. Bu durum, özellikle küçük ölçekli şirketler veya bireysel geliştiriciler için büyük bir erişilebilirlik avantajı yaratır.
DeepSeek V3.1 Güncellemesi: Terminus Versiyonu
DeepSeek, Eylül 2025’te V3.1 modelini “DeepSeek V3.1-Terminus” adıyla güncelleyerek modelin performansını ve stabilitesini artırmaya yönelik önemli iyileştirmeler sundu. Bu güncelleme, tamamen yeni bir modelden ziyade, mevcut V3.1 mimarisinin optimize edilmiş bir versiyonu olarak öne çıkmaktadır.
Terminus sürümü ile birlikte modelin özellikle dil işleme ve çıktı üretim kalitesinde dikkat çekici gelişmeler sağlanmıştır. Önceki sürümlerde zaman zaman karşılaşılan dil karışıklıkları ve tutarsız ifadeler büyük ölçüde giderilmiş, modelin daha akıcı ve doğru metinler üretmesi sağlanmıştır.
Güncellemenin bir diğer önemli yönü ise agent (ajan) yeteneklerindeki gelişmelerdir. Özellikle kod üretimi ve bilgi arama süreçlerinde kullanılan sistemlerde performans artışı gözlemlenmiştir. Bu durum, DeepSeek V3.1’in yalnızca bir metin üretim aracı değil, aynı zamanda daha gelişmiş görevleri yerine getirebilen bir yapay zeka sistemi haline geldiğini göstermektedir.
Ayrıca Terminus versiyonu ile birlikte modelin genel stabilitesi artırılmış, daha tutarlı ve güvenilir çıktılar üretmesi sağlanmıştır. Bu iyileştirmeler, özellikle kurumsal kullanım ve üretim ortamlarında DeepSeek’in tercih edilebilirliğini önemli ölçüde artırmaktadır.
Kısacası DeepSeek V3.1-Terminus güncellemesi, modelin teknik temelini değiştirmeden performans, doğruluk ve kullanım güvenilirliği açısından önemli bir gelişim sunmaktadır.
DeepSeek V3.1 Açık Kaynaklı Yapay Zeka Modelinin Kullanım Alanları
Yazılım Geliştirme: Kod yazma, hata ayıklama, algoritma açıklama. |
Akademik Çalışmalar: Makale özetleme, literatür taraması, tez hazırlığı. |
İçerik Üretimi: Haber yazımı, senaryo oluşturma, yaratıcı hikayeler. |
Kurumsal Entegrasyonlar: Müşteri destek chatbotları, iş süreçlerinin otomasyonu. |
Araştırma: Büyük veri analizleri, biyoinformatik, sosyal bilim araştırmaları. |
Kısacası DeepSeek V3.1, yalnızca teknoloji meraklıları için değil, endüstriyel çözümler ve akademik araştırmalar için de güçlü bir araç.
DeepSeek V3.1 Fiyatlandırma Ve Planları
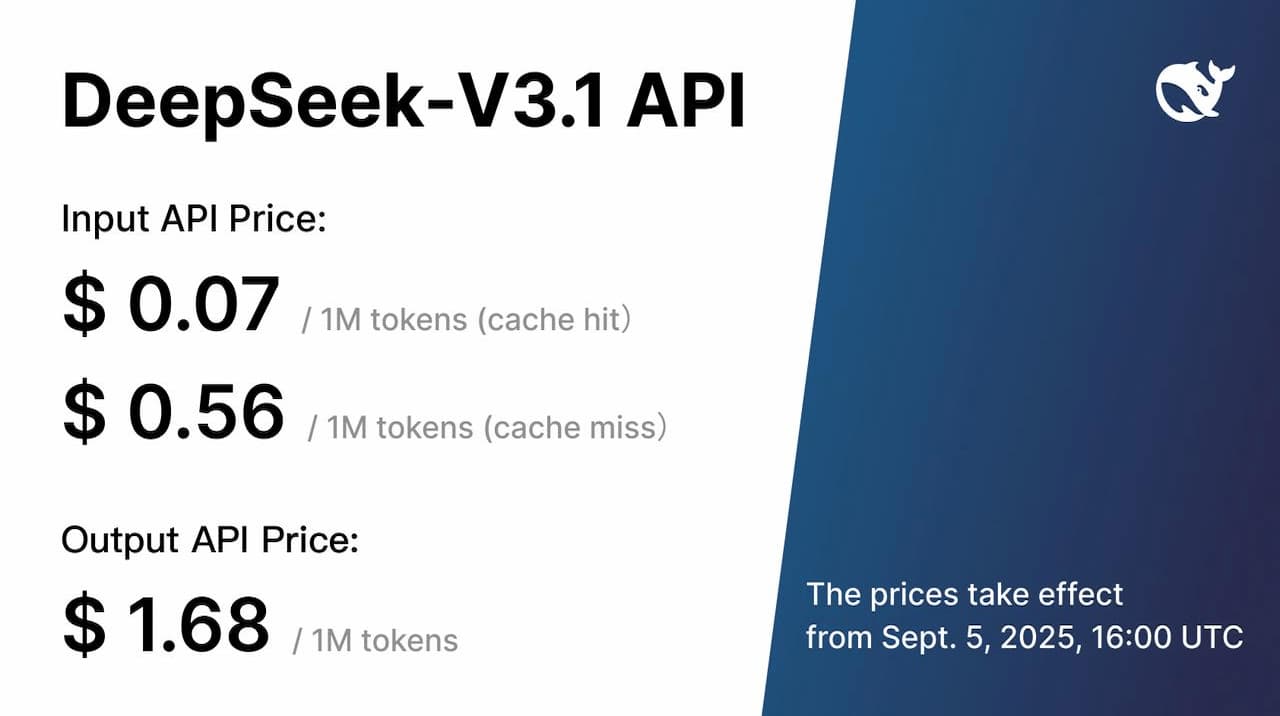
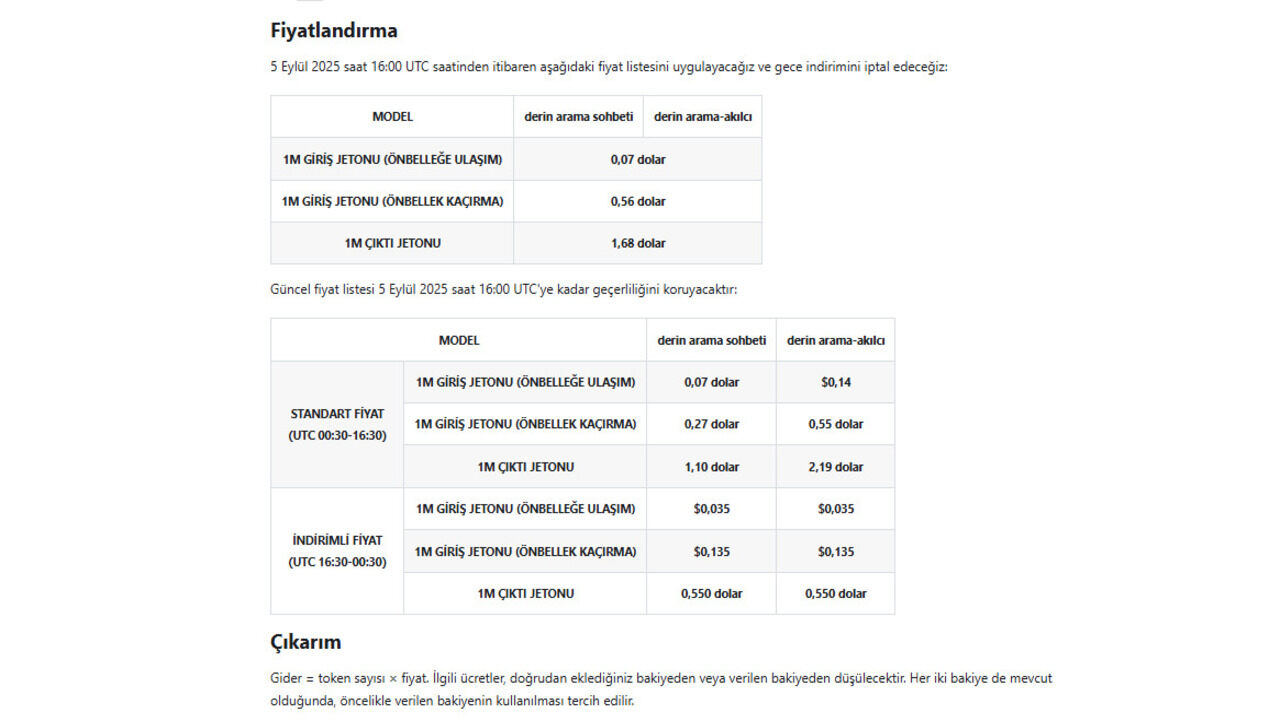
DeepSeek V3.1, kullanıcıların farklı ihtiyaçlarına göre tasarlanmış esnek ve şeffaf bir fiyatlandırma sistemi sunuyor. Modelin maliyeti, hem kullanıcı tarafından gönderilen metinler (giriş jetosu / input token) hem de modelin ürettiği yanıtlar (çıkış jetosu / output token) üzerinden hesaplanıyor.
Cache hit, daha önce işlenmiş bir sorgunun tekrar kullanılması anlamına gelir ve maliyeti düşürür. Cache miss ise her seferinde yeni işlem yapılmasını ifade eder ve maliyeti artırır.
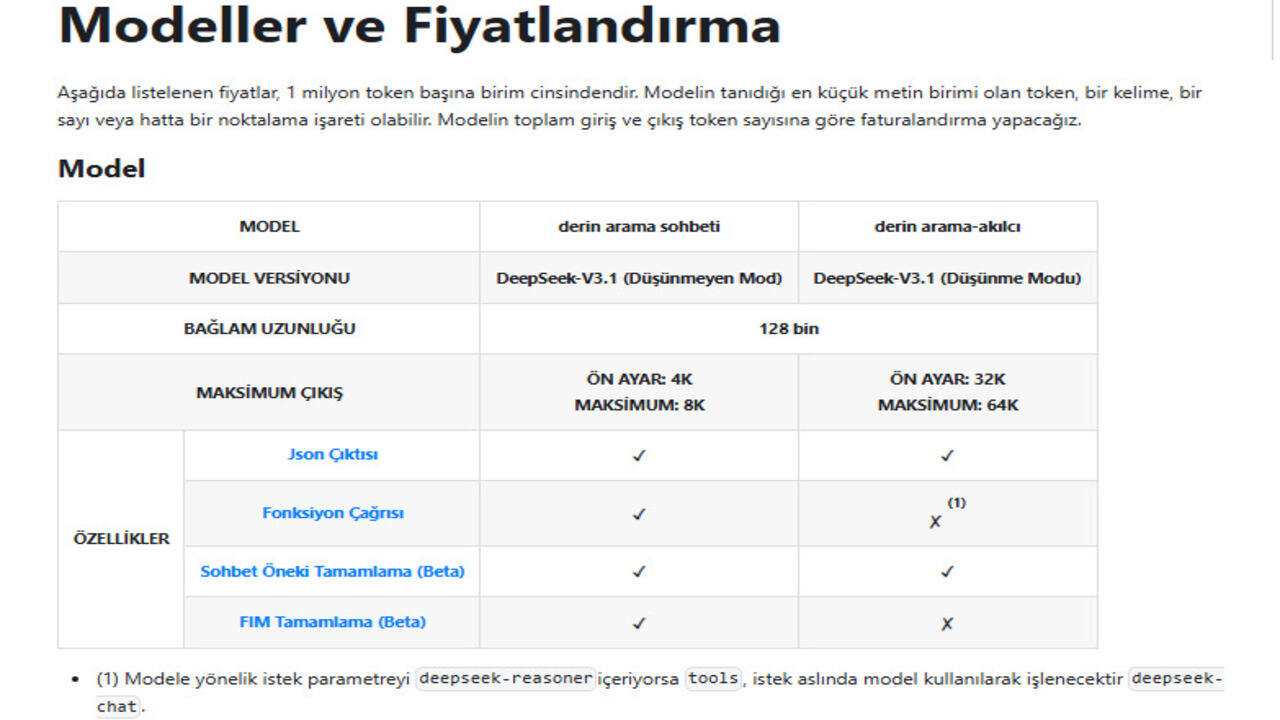
DeepSeek V3.1 Fiyatlandırma
Fiyatlandırmaya göre:
DeepSeek Chat:
Giriş jetosu (cache hit) = 0,07 $ / 1M token
Giriş jetosu (cache miss) = 0,56 $ / 1M token
Çıkış jetosu = 1,68 $ / 1M token
DeepSeek-Akıllı:
Henüz fiyat detayları açıklanmamıştır; kullanıcıların güncellemeleri takip etmesi önerilmektedir.
Önemli Kavramlar ve Maliyet Hesaplama
Giriş Jetosu (Input Token): Kullanıcının modele gönderdiği metin, soru veya komut.
Çıkış Jetosu (Output Token): Modelin ürettiği yanıt metni.
Önbelleğe Ulaşım (Cache Hit): Daha önce işlenmiş bir sorgunun tekrar kullanılması → maliyet avantajı sağlar.
Önbellek Kaçırma (Cache Miss): Yeni işlem yapılması → daha yüksek maliyet.
Maliyet Hesaplama Formülü: Toplam Maliyet = (Giriş Jetosu Sayısı × Giriş Jetosu Fiyatı) + (Çıkış Jetosu Sayısı × Çıkış Jetosu Fiyatı)
Ödeme Seçenekleri
DeepSeek, kullanıcıların ödemelerini kolayca yönetmesini sağlıyor:
Ücretler, kullanıcının eklenmiş veya promosyon bakiyesinden düşülür; promosyon bakiye varsa öncelikle bu kullanılır.
Ödeme yöntemleri arasında kredi kartı, banka havalesi ve PayPal yer alır.
Kurumsal müşteriler için fatura bazlı ödeme seçeneği mevcuttur.
Detaylı bilgi ve en güncel fiyatlandırma planları için DeepSeek’in resmi web sitesinin takip edilmesi önerilmektedir.
DeepSeek V3.1 Ve Rakipleri
DeepSeek V3.1, yalnızca kendi başına güçlü bir model olmakla kalmıyor; aynı zamanda mevcut büyük dil modelleri (LLM) ve yapay zeka sistemleriyle karşılaştırıldığında öne çıkan bazı avantajlar sunuyor. En bilinen rakipleri arasında OpenAI’nin GPT-4 serisi, Anthropic’in Claude modelleri ve Meta’nın LLaMA modelleri bulunuyor.
Kullanım Amaçları
DeepSeek V3.1: Akademik araştırma, uzun metin analizi, yaratıcı yazarlık, kodlama, kurumsal chatbotlar.
GPT-4 / Claude: Genel amaçlı sohbet, metin üretimi, kodlama, araştırma. Ancak uzun bağlamlarda ve düşük maliyetli yerel kullanımda DeepSeek daha avantajlı.
LLaMA: Daha çok araştırma ve deneysel kullanım odaklı, ticari API entegrasyonu sınırlı.
Performans Karşılaştırması
Aider Kodlama Benchmarkı: DeepSeek V3.1, Claude Opus 4’e göre %1 daha yüksek puan aldı. Bu, özellikle kodlama ve algoritma çözme yeteneklerinde üstünlük sağlıyor.
Uzun Metin İşleme: DeepSeek’in 128K token bağlam penceresi, GPT-4 ve Claude’un 32–64K token kapasitesine kıyasla çok daha uzun metinleri aynı anda işleyebilmesini sağlıyor. Bu, hukuk, akademi ve yazılım projeleri gibi uzun veri setleri için büyük avantaj.
Doğal Dil Anlama ve Üretme: NLP görevlerinde (metin özetleme, çeviri, duygu analizi) DeepSeek V3.1, rakipleri ile benzer doğruluk oranlarına sahip, ancak daha hızlı ve enerji verimli çalışıyor.
Maliyet Karşılaştırması
DeepSeek V3.1’in en güçlü avantajlarından biri maliyettir. API üzerinden yapılan kullanımlarda, OpenAI ve Anthropic modellerine kıyasla 20–40 kat daha düşük işlem maliyeti ortaya çıkıyor.
Think modu ve MoE mimarisi sayesinde, gereksiz parametre çalıştırılmadığı için enerji tüketimi azalıyor. Bu da işletmeler için önemli bir tasarruf avantajı sağlıyor.
Esneklik ve Özelleştirme
Açık kaynaklı olması, DeepSeek’i rakiplerinden ayrıştıran en büyük özelliklerden biri. Hugging Face ve GitHub üzerinden modelin kodlarına erişim mümkün, bu da özelleştirme ve yerelde kullanım imkanı sunuyor.
Rakip modeller ise genellikle kapalı kaynaklıdır ve yalnızca API üzerinden erişilebilir. Bu durum, bazı geliştiriciler ve araştırmacılar için sınırlayıcı olabilir.
Pozitif ve Negatif Yönleri
Pozitif Yönleri | Negatif Yönleri |
Açık Kaynaklı – Model, MIT lisansı altında herkese açık. Bu, geliştiricilerin şeffaf şekilde inceleme ve özelleştirme yapmasına olanak sağlıyor. | Güvenlik Riskleri – Açık kaynaklı modeller, kötü niyetli kişiler tarafından dezenformasyon ya da siber saldırılar için kullanılabilir. |
Maliyet Avantajı – Rakiplerine göre 20–40 kat daha ucuz, yerelde ise tamamen ücretsiz. | Donanım Gereksinimi – Yerelde çalıştırmak için güçlü GPU’lar ve büyük bellek ihtiyacı var. |
Hibrit Mimari – Think ve non-think modları ile farklı senaryolara uyarlanabiliyor. | Dil Desteği Sorunları – İngilizce dışındaki dillerde, özellikle Türkçe ve bölgesel dillerde, OpenAI modelleri kadar güçlü değil. |
Yüksek Performans – Benchmark testlerinde Claude ve GPT tabanlı rakiplerini geride bırakıyor. | Regülasyon Belirsizliği – Açık kaynaklı yapay zekaların kontrolü zor olduğu için, hükümetlerin regülasyon tartışmaları artabilir. |
Geniş Bağlam Kapasitesi – 128K token desteği ile 400 sayfaya eşdeğer metni aynı anda işleyebiliyor. | Think Modunun Yavaşlığı – Daha doğru yanıtlar üretse de, think modu gerçek zamanlı uygulamalarda gecikmeye sebep olabiliyor. |
Esnek Kullanım Alanı – Yazılım geliştirme, akademi, gazetecilik, müşteri hizmetleri gibi çok geniş bir yelpazede kullanılabiliyor. |
|
OpenAI: ChatGPT Erotik İçerik Sunmaya Hazırlanıyor
Tasarım Yapay Zeka ile Nasıl Kullanılır?


