MoE modellərində fəaliyyət təsviri
Avtomatik tərcümə edildi
 Admin
Böyük Dil Modelləri (BBD) hər gün daha kompleks olmaqla performans və effektivliyi qarşılamaq kritikdir. Mixture-of-Experts (MoE) memarlıqları bu balans təmin edir, model hər bir MoE qabının müxtəlif xüsusiyyəti ən yaxşı anlaşılmadı. Xüsusi model kompressiyası (model kompressiya) dərin analizinin olmaması idi. 2026 avqust ayında yeni bir araşdırma Qwen3.6-35B-A3B model haqqında əsaslı məlumatlar təklif edir və BBDs gənc optimallaşdırma üçün əsas bir addım alır.
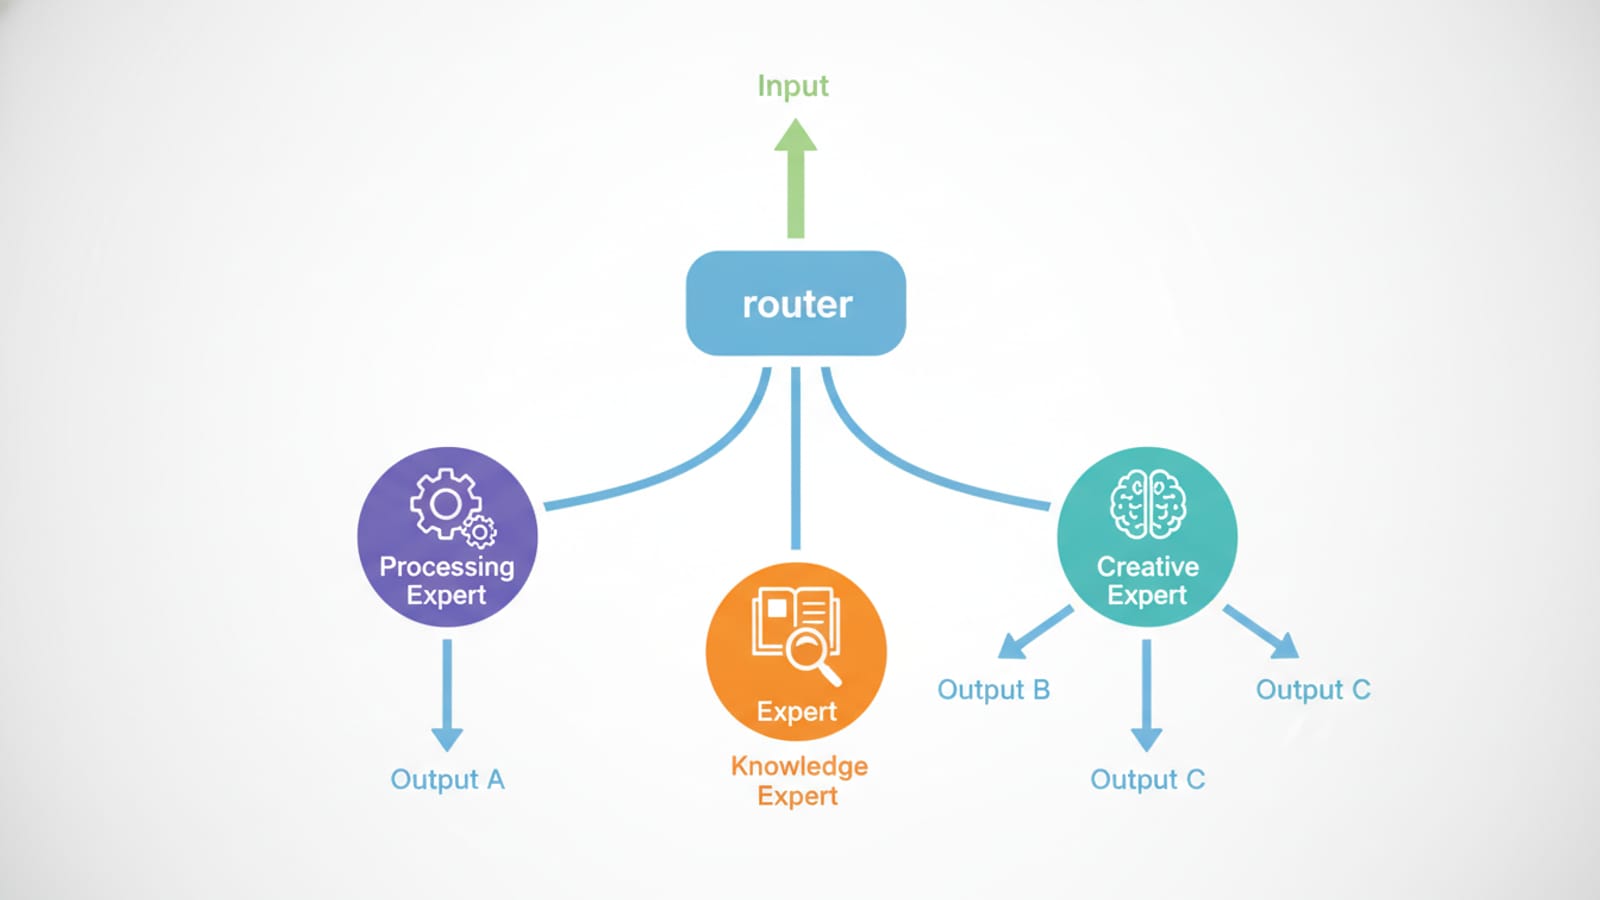
MoE modellərin dəyişiklik analizi necədir?
"Derinlik Oriented Precisionity Analysis, müxtəlif qadınların (MoE) modellərinin və mütəxəssislərinin müxtəlif qadınların təsirini sistematik birləşdirən bir metodolojidir. Bu məqsəd modelin hissələrinin daha effektiv olduğunu təsirləndirməklə daha kiçik və ya daha sürətli model yaratma yollarını araşdırmaqdır. Bu analiz Qwen3.6-35B-A3B kimi kompleks MoE strategiyaları üzrə dəstəyini ortaya çıxarır, hər kəs və mütəxəssislərin əsasən.
Mixture-of-Experts (MoE) Memarlıq və İş İlki
MoE bir çox kiçik, xüsusi sub-network (koman şəbəkələri) böyük səhifəli məlumat modelini bölmənin yenilikçi bir strukturudur. Hər bir giriş (e.g. bir məhsul parçası) yalnız ən müxtəlif müxtəlif mütəxəssisələrə yönəlir (router). Bu nadir aktivləşdirilməsinə (sparseaktivləşdirilməsi) modelinin ümumi parametrlərini artırır, hesab qiymətlə artırmır. Xüsusi (intentional) BBDs-dən 70%-dən aşağı hesab və daha sürətli təhlükəsizlik verir. Qwen3.6-35B-A3B modeli, 40 MoE kağızı, 256 kəs başına ekspert və ən yaxşı 8 ekspertlərin hər bir token üçün seçilən "top-8 routing" strukturuna malikdir. Ekspertlər dil prosesləri və ya xüsusi işlər kimi daha gözəl işlərində ixtisaslaşmışdır.
Böyük Dil Modellərinin kompressiyası (BBD)
Bu gün BBD xüsusiyyətlər milyard səviyyətlərinə çatdırılmaqla inanılmaz bacarıqlar göstərir. Lakin, bu ölçü yüksək hesab, enerji və yaxşı xüsusiyyətləri yaradılması real dünya applications. Model kompressiyaları bu problemləri azaltmaq və BBDs daha az resurs ilə daha effektiv işləyir. Böyük kompressiya metodları daxildir:
Klassiklik (Quantization): Parametrlərin aşağı dəqiq data növü (e.g. Model ölçüsü və sürəti FP16-dan INT-8-ə qarşılaşdırılır.
Budama (Pruning): Modeldə daha az əsas parametrlər və ya əlaqələr daimi silinir. Bu modelin komplekslik və qurğu istifadəsini azaldır.
İnformasiya Distillation (İnformasiya Distillation): Daha böyük "student" modelinin öyrənilməsi, daha kiçik "student" modelə qəbul olunub.
Xüsusi təhlükəsizlik Analizi və Magnitude-based Ekspert Maskin g
Maddə MoE kağızlarının və ya ekspertlərin kəsmi dəqiq analiz, model kompressiyası və performans optimallaşdırılması üçün model performansa ən böyük təsir ehtiyacları olduğunu təmin edir. Bu analiz növü modelin daxili işləməsini anlamaq və ən kritik komponentlərini algılamaq üçün vacibdir. "Magnitude-based Ekspert Masking" smearing və ya analiz texnologiyasına daxildir, ki, müştərilərin ölçüsü ilə ağır dəstək dəyişikliklərin dəstəkliyini dəstəkləyir. Bu yanaşma MoE modellərində və ya daha çox dilləşdirilməsi yaratmaq üçün mövcud xüsusiyyəti optimallaşdırma yoludur.
Sector: Qwen3.6-35B-A3B və MoE
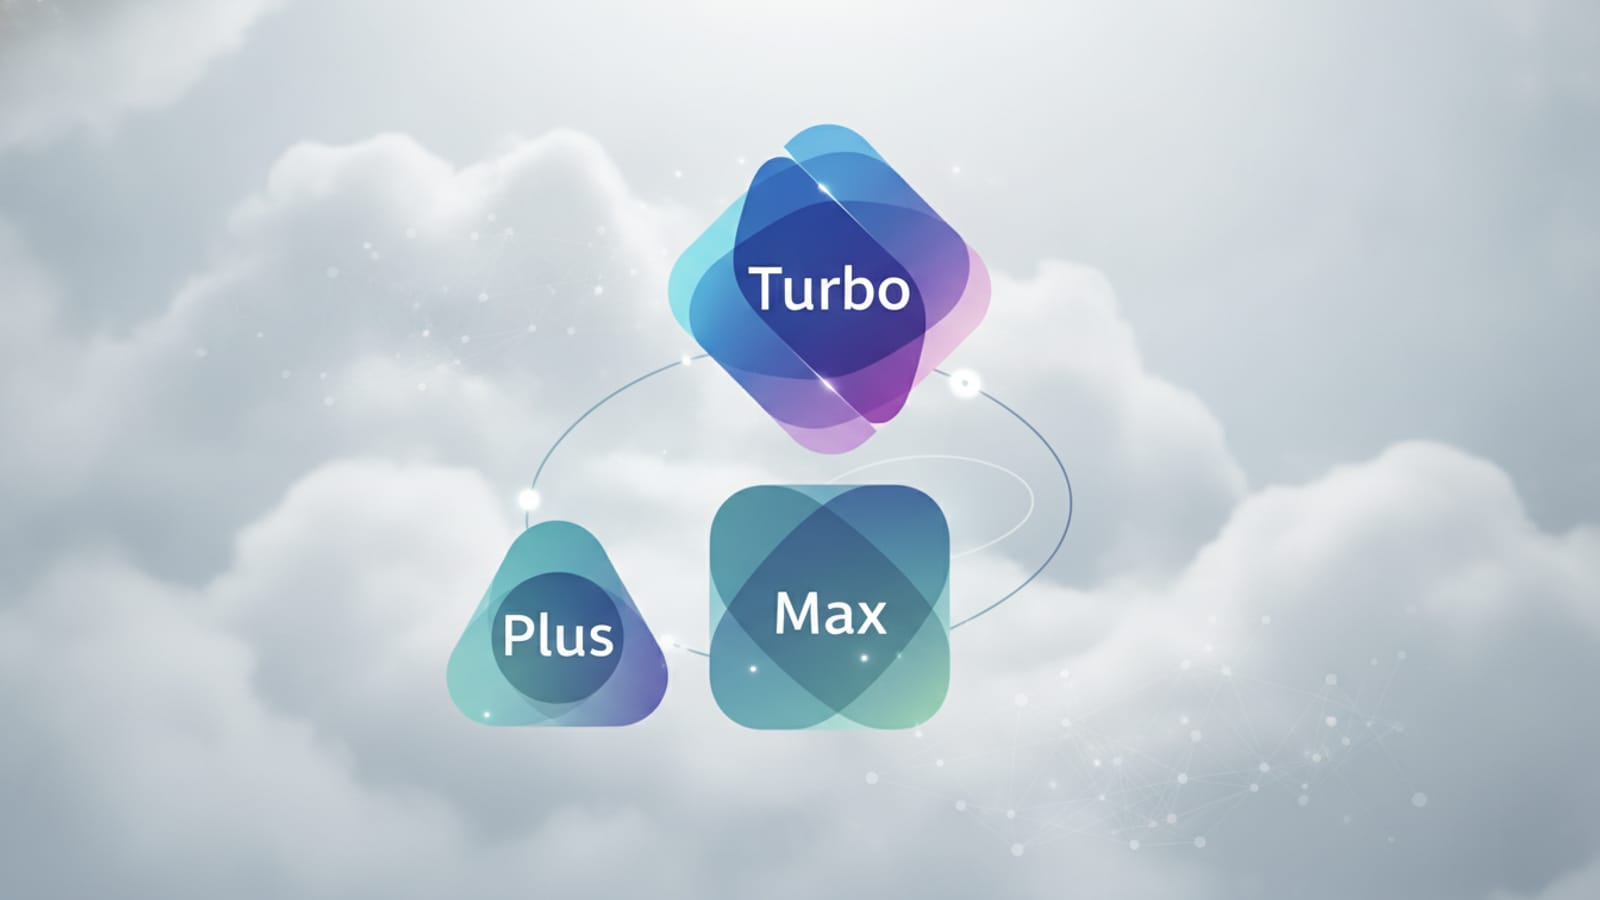
Alibaba Cloud tərəfindən hazırlanmış Qwen3.6-35B-A3B modeli Qwen (Tongyi Qianwen) Qwen tərəfindən hazırlanmış Qwen (Tongyi Qianwen) böyük dil model ailəsinin üzvüdür. Qwen ailə Transformer-based memarlıqlarda inşa edilir və xüsusiyyətləri ilə xüsusilə tanınır, xüsusilə Çin və İngilis dillərin güclü performansı ilə. Modelin 35 milyart parametrləri ilə bu variant 40 MoE qatları və 256 ekspert ehtiva edir. Qwen modelləri Max, Plus və Turbo kimi müxtəlif ölçüsü və performans səviyyələri var. MoE mimarisi İndi Mistral AI, Grok-1 xAI, DeepSeek-V3 və Databricks olan Mixtral 8x7B kimi lider modellərdə istifadə olunur.
Oxunub:
Support
qarışıq-of-Experts (MoE) dəstəkləyiciləri, bu strukturların müxtəlif modellərinə uyğunlaşdırılması effektivliyi və səmiyyətliyini göstərir. MoEs daha sürətli təhlükəsiz, daha sürətli təhlükəsizlik və istismar vasitəsi ilə modellər edir. Bu yolla, böyük və xüsusi BBDs istifadə daha geniş bir sıra açılır.
News
Xüsusi ekspertlər və səhifəçilər MoE modellərinin komplekslik və səvəlliklərinə baxırlar. Routing mexaniyasının düzgün məsləhəti (router) ekspertlərin inkişaf etdirilməsi və bütün modeli optimallaşdırmaq üçün mühüm mühüm mühüm mühüm mühüm mühüm mühüm mühüm mühüm mühüm mühümdisliyi problem yaradır. Ayrıca, MoE modellərinin nadir strukturu bir hardware memarlıqlarında tam səmiyyətə yol verə bilər.
Əgər sorğular
Niyə MoE modelləri ən populyar?
MoE modelləri, yüksək performans və hesablaşdırma şərtlərində böyük Dil Modelləri (BBD) sahəsində sənaye model yaratmaq imkanından ötürü mövcuddur. cross aktivləşdirilməsinə görə, onlar daha az resurs ilə işləyən milyard parametrləri təmin edir və sürətli aradan qaldırılır.
BBDs üçün model kompressiyası effektivdir?
Model kompressiya bu gün böyük BBDs yüksək hesab, yaxşı və enerji xidmətləri azaltmaq üçün kritikdir. Bu texnologiyalar daha kiçik cihazlar (e.g. mobil telefonlar) işləməyə imkan verir və sübut xüsusiyyətləri azaltmaqla daha geniş sənaye çatdırmalarına kömək edir.
Qwen3.6-35B-A3B xüsusiyyətləri?
Qwen3.6-35B-A3B Alibaba Cloud's Qwen ailəsinin böyük bir dil modelidir. 35 milyart parametrləri ilə bu variant, 40 Mixture-of-Experts (MoE) kağız, 256 kağız və "top-8 routing" kimi xüsusi səviyyəli və dilli işlərdə uğurla təmin edir.
Magnity-based Ekspert Maska necədir?
Magnitude-based Ekspert Maska daha az məhsul müəyyən müəyyən müəyyən və ya daimi texnologiyadır, MoE modelləri üzrə ekspertlərin xüsusiyyətlərinin xüsusiyyətlərinə uyğun olaraq əsaslanır. Bu üsul model kompressiya və optimallaşdırma proseslərinin komponentlərin əlavə edilə bilər və ya əsaslanır.
böyük dil modellərinin gənclərinin gənclərinin gənclərinin gəlir, lakin onları daha asan və effektiv etmək üçün onları formalaşdırır. MoE modellərdəki qarşılıqlı məsləhət analizi bu yolda mühüm bir yer ola bilər. Hər bir kağızı və mütəxəssisənin performansını anlamaq daha çevik, daha güclü və daha davamlı AI sistemləri yaratmaq üçün developers üçün yeni qapılar axtarır. Bu araşdırma gündəlik texnologiyaların inteqrasiyasını artırmaq üçün kritik məlumat verir.
AdminABD Özel Şirketlere Siber Operasyon Yetkisi Verdi
Yapay Zeka Mühendisliği Olan Üniversiteler 2026