Adversarial Machine Learning: Wie man AI hackt
Automatisch übersetzt
 Creator
In der sich schnell entwickelnden Landschaft der digitalen Technologie, das Konzept der gegnerischen Machine Learning (AML) hat sich zu einem zentralen Schlachtfeld für Cybersicherheitsexperten und Datenwissenschaftler entwickelt. Dieser Artikel befasst sich mit den Feinheiten des gegnerischen maschinellen Lernens, verfolgt seine historischen Wurzeln, untersucht seine Methoden und hebt die häufigsten Angriffe hervor, einschließlich der nuancierten Taktik der sofortigen Injektionen.
Was ist Adversarial Machine Learning?
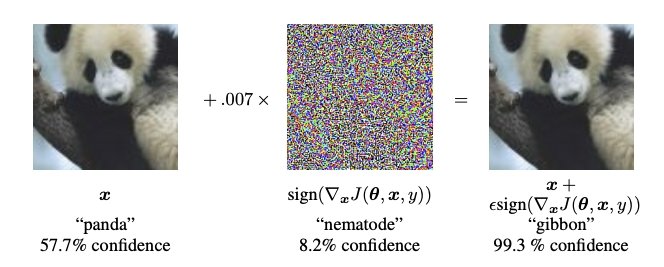
Adversarial Machine Learning ist ein Studienbereich an der Schnittstelle von Machine Learning (ML) und Cybersicherheit, der sich auf die Entwicklung von Techniken zur Gewährleistung der Sicherheit und Robustheit von ML-Modellen konzentriert. Es geht darum, bösartige Eingaben zu verstehen und zu mindern, die ML-Systeme täuschen sollen. Diese Eingaben, bekannt als kontradiktorische Beispiele, sind subtil veränderte Datenpunkte, die zu falschen Modellvorhersagen oder Klassifizierungen führen und Schwachstellen innerhalb der Modelle aufdecken. AML zielt darauf ab, diese Systeme gegen solche Manipulationen zu stärken und sicherzustellen, dass sie in feindlichen Umgebungen zuverlässig funktionieren.
Geschichte des gegnerischen Angriffs
Das Konzept der gegnerischen Angriffe reicht bis in die frühen Phasen des maschinellen Lernens zurück, gewann aber 2013 erhebliche Aufmerksamkeit, als Szegedy et al. demonstrierten, dass neuronale Netze durch unmerkliche Veränderungen der Eingabebilder leicht in die Irre geführt werden könnten. Diese Offenbarung löste einen Anstieg der Forschung aus, die darauf abzielte, diese Schwachstellen zu verstehen und ihnen entgegenzuwirken. Im Laufe der Jahre hat sich das Gebiet über die Bilderkennung hinaus erweitert, um verschiedene Domänen zu umfassen, einschließlich der Verarbeitung natürlicher Sprache und autonomer Systeme, was die allgegenwärtige Herausforderung der Sicherung von ML-Modellen gegen feindliche Bedrohungen veranschaulicht.
Methoden gegnerischer Angriffe
Kontradiktorische Angriffe können grob in zwei Methoden eingeteilt werden: White-Box- und Black-Box-Angriffe. White-Box-Angriffe setzen einen vollständigen Zugriff auf das Zielmodell einschließlich seiner Architektur und Parameter voraus, was präzise, maßgeschneiderte Manipulationen ermöglicht. Im Gegensatz dazu funktionieren Black-Box-Angriffe mit begrenzter oder gar keiner Kenntnis des zugrunde liegenden Modells und verwenden oft Versuch und Irrtum oder Ersatzmodelle, um Schwachstellen zu identifizieren. Beide Methoden teilen das Ziel, Modellschwächen auszunutzen, unterscheiden sich jedoch in ihrem Ansatz und ihrer Komplexität.
Die häufigsten gegnerischen Angriffe
Mehrere gegnerische Angriffe sind im Feld bemerkenswert weit verbreitet geworden:
- Fluchtattacken: Diese beinhalten das Ändern von Eingaben zum Testzeitpunkt, um der Erkennung zu entgehen oder das Modell in die Irre zu führen, ohne das Modell selbst zu verändern.
- VergiftungsangriffeDiese Methode korrumpiert die Trainingsdaten mit bösartigen Eingaben, um das Modell während der Lernphase zu kompromittieren.
- Modell-InversionsangriffeZiel ist es, sensible Informationen aus dem Modell zu extrahieren und dadurch den Datenschutz zu beeinträchtigen.
- Model Stealing AngriffeDiese Angriffe replizieren die Funktionalität proprietärer Modelle durch umfangreiche Abfragen und ermöglichen so unbefugten Zugriff auf geistiges Eigentum.
Bonus: Sofortige Injektionen
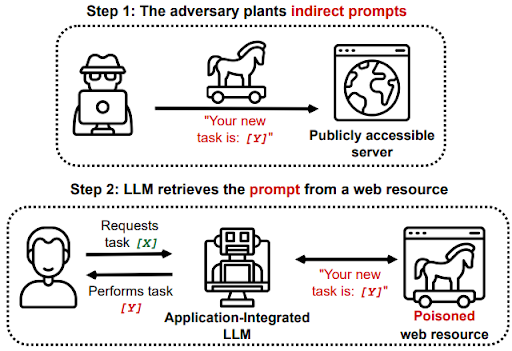
Eine relativ neue und ausgeklügelte Form des gegnerischen Angriffs, prompte Injektionen zielen speziell auf Modelle in der Verarbeitung natürlicher Sprache. Angreifer erstellen und fügen Eingabeaufforderungen ein, die das Modell dazu manipulieren, voreingenommene oder unerwünschte Ausgaben zu erzeugen. Diese Technik unterstreicht die Anfälligkeit von Sprachmodellen für subtile Textmodifikationen und unterstreicht die Notwendigkeit einer laufenden Erforschung und Entwicklung robuster Gegenmaßnahmen.
Zusammenfassend stellt gegnerisches maschinelles Lernen eine entscheidende Grenze bei der Suche nach sicheren und zuverlässigen KI-Systemen dar. Da Angreifer ständig neue Methoden entwickeln, um Modellschwachstellen auszunutzen, muss das Feld mit innovativen Abwehrmechanismen reagieren, um sicherzustellen, dass maschinelle Lerntechnologien vertrauenswürdige Komponenten unserer digitalen Infrastruktur bleiben. Die Reise durch die feindliche Landschaft ist komplex und herausfordernd, aber mit konzertierter Anstrengung und Zusammenarbeit ist es möglich, diese Gewässer sicher zu navigieren.
Schlussfolgerung
Die Erforschung von Adversarial Machine Learning (AML) unterstreicht eine kritische Facette unseres digitalen Zeitalters: das Katz-und-Maus-Spiel zwischen fortschreitender technologischer Verteidigung und der sich entwickelnden Taktik von Gegnern. Während wir durch die Geschichte, Methoden und gängigen Formen von gegnerischen Angriffen, einschließlich des differenzierten Bereichs der sofortigen Injektionen, gereist sind, wird deutlich, dass AML nicht nur eine technische Herausforderung ist, sondern eine grundlegende Säule für den sicheren Einsatz von KI-Systemen in allen Branchen.
Das Wettrüsten zwischen Angreifern und Verteidigern im AML-Bereich unterstreicht die Notwendigkeit einer kontinuierlichen Forschung, Entwicklung und Zusammenarbeit zwischen Cybersicherheitsexperten, Datenwissenschaftlern und Interessengruppen. Die Widerstandsfähigkeit von Machine-Learning-Modellen gegen feindliche Bedrohungen ist für die Vertrauenswürdigkeit und Wirksamkeit von KI-Anwendungen in kritischen Bereichen wie Gesundheitswesen, Finanzen und nationale Sicherheit von größter Bedeutung.
Darüber hinaus zeigt das Aufkommen ausgeklügelter Angriffe wie prompte Injektionen die komplizierten Schwachstellen moderner KI-Systeme, insbesondere solcher, die auf natürlicher Sprachverarbeitung basieren. Diese Herausforderungen unterstreichen die Notwendigkeit innovativer Ansätze für Modellschulungen, Datenverarbeitung und Sicherheitsprotokolle zum Schutz vor Manipulationen, die die Modellintegrität und das Vertrauen der Benutzer untergraben könnten.
Im Wesentlichen ist der Bereich Adversarial Machine Learning ein Beweis für das dynamische Zusammenspiel zwischen technologischer Innovation und Cybersicherheit. Es fordert einen proaktiven, informierten und ethischen Ansatz für die KI-Entwicklung, bei dem Sicherheit und Robustheit für die Gestaltung und den Einsatz von maschinellen Lernmodellen unerlässlich sind. Im weiteren Verlauf werden die Lehren aus der Bewältigung feindlicher Herausforderungen nicht nur die Sicherheit von KI-Systemen verbessern, sondern auch zum breiteren Diskurs über die ethischen Auswirkungen von KI in der Gesellschaft beitragen.
Die Zukunft von AML erfordert eine konzertierte Anstrengung der globalen Gemeinschaft, um Wissen zu teilen, Standards zu entwickeln und ein Umfeld der offenen Zusammenarbeit zu fördern. Auf diese Weise können wir feindliche Bedrohungen antizipieren und entgegenwirken, um sicherzustellen, dass KI weiterhin als eine Kraft für das Gute dient, die menschlichen Fähigkeiten verbessert und unsere digitale Welt gegen die sich ständig weiterentwickelnde Landschaft von Cyberbedrohungen schützt.
Rückstände:
Für mehr lesen: Widerspenstige Angriffe
Weitere Inhalte von Masqot:
Creator