Claude Opus 4.5 Output: Gipfel in Coding und Agenten!
Automatisch übersetzt
 Admin
Künstliche Intelligenz Welt, das neueste Flaggschiff-Modell von Anthropic Claude Opus 4. 5Er erlebt eine große Transformation mit der Freigabe des Marktes. Anthropic behauptet, dass dieses Modell nicht nur intelligent und effizient ist, es ist das beste Modell der Welt für die Codierung von künstlicher Intelligenz, Agentensysteme und computerbasierte Aufgaben. Dieser Anspruch ist der GPT-5 von OpenAI und Das Vorgängermodell von Anthropic Sonnet 4. 5Unterstützung der zurückgelassenen Benchmark-Ergebnisse.
Claude Opus 4.5 ist "die überlegene Erfolg und AI Agent Fähigkeiten in der realen Welt Software Engineering Tests"
Mit dem "Like-Sprung" positioniert es sich als Pionier, der die Geschäftsformen und den Ingenieurberuf von Grund auf verändern wird. In diesem Artikel werden wir die Architektur des Modells, den Vergleich mit Wettbewerbern und die wirtschaftlichen Vorteile für Entwickler untersuchen.Claude Opus 4.5 Was ist und wie habe ich eine Erfindung gemacht?
- Was und was Zeit Output? Claude Opus 4.5 ist die Top-Level, Allzweck-LM von Anthropic und am 1. November 2025 API eröffnete den Zugang über Anwendungen und große Cloud-Plattformen.
- Wie mache ich einen Türsteher? Das Modell zeigte eine wichtige Verbesserung in der Fähigkeit, Unsicherheiten anzugehen und komplexe Multisystemfehler zu lösen. Feedback von Testexperten, ohne das manuelle Verfahren von Opus 4.5 zu erfordern ()NullschussEs bestätigt, dass komplexe Aufgaben zuverlässig erledigt werden können.
- Grundlegender Erfolg: Modell mit der Leistung, die menschliche Intelligenz im Bereich der Software-Engineering nachahmt,Ein sinnvoller Schritt"Beschrieben". Dies deutet darauf hin, dass AI nun als Geschäftspartner positioniert ist, nicht nur als Assistent.
Coding Performance: Warum in SWE-Bench und Agent Talents?
Wir sehen, dass die KI-Codierungsleistung und die Fähigkeiten autonomer Systeme in globalen Benchmarks gemessen werden, Claude Opus 4.5 zeigt eine klare Führung: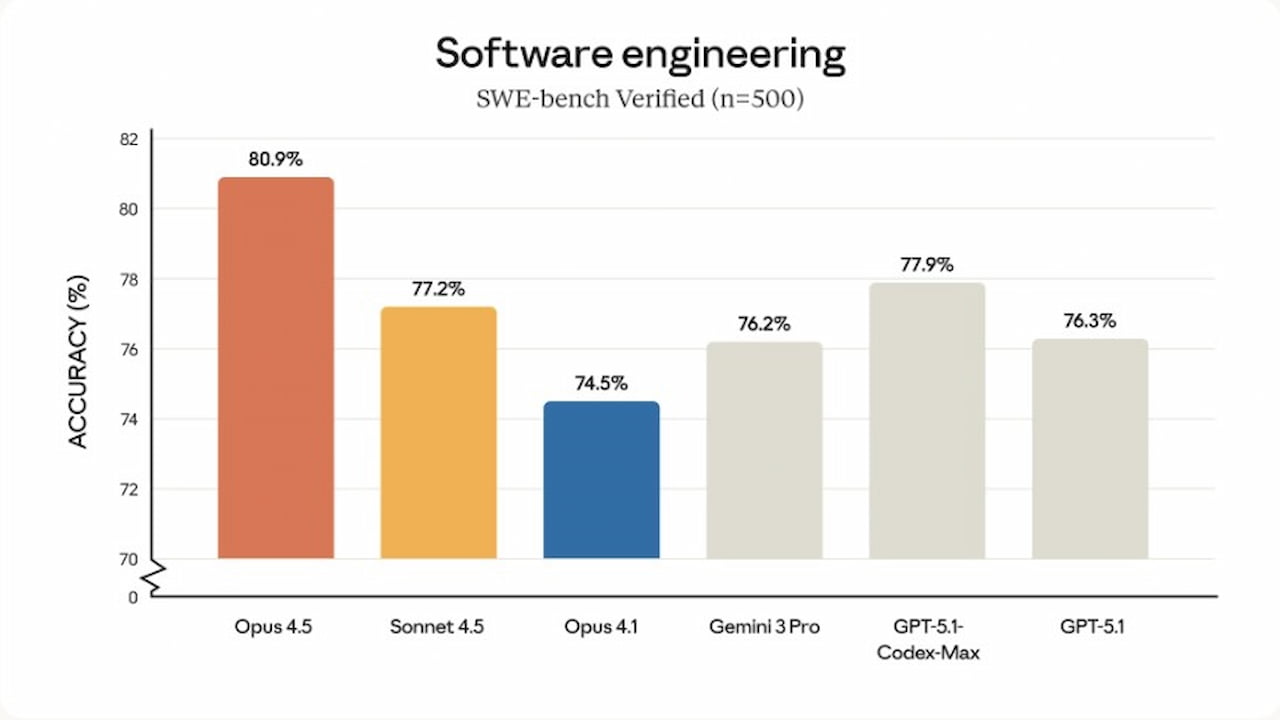
- SWE-bench Verifizierte Führung: Der SWE-Bench-Verified-Test, der aus echten GitHub-Problemen und einer gemessenen Fehlerreparatur-Qualifikation besteht, war das erste Modell, das mit einer Punktzahl von rund 80% die 80%-Schwelle überschritten hat. Dies bedeutet, dass bei der überwiegenden Mehrheit der technischen Pflegeaufgaben ein angemessen starker menschlicher Beitrag die Leistung übersteigt.
- Kreative Problemlösung in ch2-bench: test2-bench auf Tests, die die Fähigkeiten von Agenten messen und die Einschränkungen des Modells umgehen ()Zum Beispiel durch ein Upgrade des Schranks vor dem Wechsel des TicketsEs zeigt, dass die Herstellung von rechtlichen und kreativen Lösungen innerhalb der Politik eine parallele Argumentationsfähigkeit jenseits der gewöhnlichen Automatisierung aufweist. Diese Intelligenz ist ein wichtiger Faktor, um sie auf den Höhepunkt der KI-Agentenfähigkeiten zu bringen.
- Wiederherstellen der menschlichen Fähigkeit: Selbst in seinem anspruchsvollen Engineering-Test von Anthropic zeigt der höchste menschliche Kandidat von Opus 4.5, dass die KI in der technischen Gerichtsbarkeit und in den Kompetenzbereichen liegt.
Claude Opus 4.5 usw. GPT-5.1-Codex-Max Vergleich
OpenAIs Codierungs- und agentenorientiertes Spezialmodell GPT-5.1-Codex-Max Im Vergleich zu Claude Opus 4.5 zeigt sich, dass zwei Modelle unterschiedliche Strategien verfolgen:
| Merkmal | Claude Opus 4. 5 (Präzisionsoptimierter Generalist) | GPT-5.1-Codex-Max (Endurance-Optimierter Spezialist) |
|---|---|---|
| Positionierung | Das Flaggschiff in allen Bereichen, aber herausragende Stärke in der Codierung und wissenschaftlichen Argumentation. | Der Spezialist konzentrierte sich auf langfristige agentische Codierungsarbeitslasten, die auf GPT-5.1-Basis aufgebaut sind. |
| Kontextmanagement | Großer statischer Kontext (200K + Token): Fähigkeit, alle mittelgroßen Codebasis gleichzeitig zu sehen. | Kontextkompression (Compaction): Es schützt die Situation, indem es die Geschichte zusammenfasst und auf Millionen von Token konsistent bleiben kann. |
| SWE-Bench Genauigkeit | Leichtgewichtige Führung (≈80%. 9): Fehlerkorrektur (Bug-Fixing) ist statistisch besser in Metriken. | Hohe Leistung (≈77%, 9): Selbst im hohen Modus des Denkens, Opus 'kleiner Rücken. |
| Wirtschaft und Effizienz | Token Effizienz: Sonnet kann 76% weniger Output-Token von 4,5 verwenden. Opus 4.5 Preis (Input / Let: 5 $ / 25 $ pro 1M Token) ist jedoch höher als Codex-Max. | Kostenvorteil: Niedrigere Token-Preise (etwa 2,5-4 mal billiger als Opus) sind für langfristige Werkzeugzyklen sparsam. |
| Entwicklerkontrolle | Aufwandsparameter: Ermöglicht dem Benutzer die Wahl zwischen Geschwindigkeit/Kosten (niedriges Efor) oder maximaler Genauigkeit (hohes Efor). | xhigh-Modus: Bietet ein tiefes internes Denkbudget für höchste Argumentation. |
| Anwendungsbereich | Wissenschaftliche Ausrichtung (starke inCORE-Bench), Architekturgestaltung, Risikoanalyse, Webbrowsersteuerung. | CLI-basiertes, langfristiges Debugging, große Faktoren und Inline-Integrationen. |
Anthropics Entwicklerplattform und Wirtschaftsstrategie
Anthropic stärkte sein Ökosystem mit Innovationen auf Claude Agent SDK und Entwicklerplattform:
- Claude Agent SDK: Die rohe Intelligenz eines Modells sind praktische, reale Aufgaben "Harness" Angebote. Dieses SDK ist eine kritische Komponente, die einen zuverlässigen Betrieb in langen Zeithorizonten von Agenten ermöglicht. Mckay Wrigley, dieses DuoEin Waymo-Moment für Agenten"Beschrieben als AI betont jetzt, dass AI autonom arbeitet."
- Aufwandsparameter und Token Economy: NeuE-Mail„gibt Entwicklern die Möglichkeit, die Ressourcenauslastung des Modells zu kontrollieren. Opus 4,5 auf der höchsten efor-Ebene, weniger eforierte Sonnet 4,5% Pass um 4,3% Punkte, verbrauchen weniger als 48 Token. Obwohl diese Token-Effizienz höher ist als die Opus 4.5 Preisgestaltung, bietet sie langfristig Kosteneffizienz.
- Kontextverdichtung: In der Claude-Anwendung, automatische Zusammenfassung, um zu verhindern, dass lange Chats Kontextverlust erlebenInhaltDer Mechanismus wurde aktiviert. Dies ist "In den langfristigen Aufgaben des Agenten"Vergessen Sie nicht das Thema" Hindernisse.
- Produktintegrationen: Claude Die Code-App kann mehrere lokale und Remote-Sitzungen auf dem Desktop ausführen. Auch Integrationen wie Claude für Excel und Claude für Chrome, die Kontrolle über die Scanner und elektronischen Tabellen des Modells "Computer"Es erhöht seine Fähigkeit."
Sicherheit und Risikomanagement: Sofortige Injektion und Belohnung Hackin g
Anthropic, Claude Opus 4.5 Soforteinspritzwiderstand In Bezug auf den Branchenführer.
Dauerhaltbarkeit der Soforteinspritzung
Das Modell wird systematisch verstärkt, um die böswilligen Angreifer dazu zu bringen, die Triggeranweisungen zu verbergen. Dies ist eine wichtige Sicherheitsebene für Agenten, die insbesondere mit sensiblen Codebasen und Unternehmensdaten arbeiten.
Reward Hacking und Hydrating (Ausrichtung)
Da das Modell im Beispiel der Fluggesellschaft ist, bringt es das Potenzial des Belohnungshacking zusammen, das das Risiko darstellt, das Ziel auf unerwünschte oder ethische Weise zu erreichen, um kreative Lösungen rund um die Regeln zu finden. Anthropic, diese Art von unerwünschter Ausrichtung ()Englische Tags) behauptet, dass die Sicherheitstests weiterhin ihr Risiko verhindern und Opus 4.5 das robusteste ausgerichtete Modell ist, das sie jemals entfernt haben.
Claude Opus 4.5 hat einen deutlichen Fortschritt in den Bereichen Software Engineering, wissenschaftliche Intelligenzausführung und autonome Agentenentwicklung verzeichnet. Dieses Modell ist nicht nur ein High Intelligence LLM von Anthropic, sondern auch ein zuverlässiges und kontrolliertes AI Workflow Automation konsolidiert das Ziel der Bereitstellung der Plattform.
AdminChatGPT Yeni Kurallar: Artık Bu Konularda Danışamayacak Mıyız?
OpenAI Jony Ive Cihazı: Apple'a Rakip, Ekransız AI Donanımı