Dateninfrastrukturprognosen: Was erwartet Sie im Jahr 2026?
Automatisch übersetzt
 Autor:in
Die Dateninfrastruktur ist aus dem Hintergrund Systeme, die die Notwendigkeit für die Datenspeicherung und Berichterstattung im Jahr 2026 erfüllen. Auf diese Weise ist künstliche Intelligenz zur grundlegenden Determinante autonomer Entscheidungsmechanismen und Analyseprozesse in Echtzeit geworden. Heute, da welche Daten gemacht wurden, kam es direkt auf die relevante Situation, wie die Daten modelliert und wie sie verstanden werden. Diese Umwandlung; traditionelle Data Warehouses, feste ETL-Pipelines und stellen direkt die analytisch-operationelle Trennung in Frage. Laut Prognosen von 2026 werden offenere, modularere und KI-kompatiblere Architekturen in der Dateninfrastruktur auffallen.
Kommt das Ende der analytischen und operativen Systeme?
Das Konzept der klassischen Datenarchitektur wurde jahrelang auf zwei getrennten Welten aufgebaut. Sie führen tägliche Operationen durch Betriebssysteme (OLTP) Berichterstattung und Entscheidungsunterstützung Analytische Systeme (OLAP) sortierbar. Dieser Ansatz war für Verzögerungen und komplexe Integrationsschichten bei der Datenreplikation unvermeidlich. Aber mit modernen digitalen Produkten wurde es bis zum Ende dieser Trennung angegangen.
Warum bedeutet das diskret?
- Echtzeit-Berichterstattung und Dashboard-Prognose
- KI-Modelle brauchen Live-Produktionsdaten
- Streaming und Eventgesteuerter ArchitektVereinheitlichung von
- Fragen ohne Kopieren von Daten (Zero-Copy Analytics)
In der Vision der Dateninfrastruktur von 2026 werden Daten nun über eine einzige zuverlässige Quelle für mehrere Zwecke verwendet, ohne als "operationell" oder "analytisch" bezeichnet zu werden. Dies macht Datenformate strategisch, um Schichten und Abfrage-Engines zu verbinden.
Apache Arrow und ADBC: Neue Standards in der Datenverbindung
Das Rückgrat der modernen Datenarchitektur Apache-Pfeil 2026 Dateninfrastrukturprognosenist die Grundlage dafür. Arrow eliminiert Konvertierungskosten zwischen verschiedenen Systemen und ermöglicht die Darstellung von Daten in einer spaltenbasierten und standardisierten Form im Speicher.
Warum ist Apache Arrow wichtig?
- Hohe analytische Leistung dank spaltenbasiertem Speicherlayout
- Python, Java, C++, Rust
- Teilen ohne Kopieren von Daten (Null-Kopie)
- Geeignete Struktur für CPU, GPU und vektorisierte Prozesse
- Das Datenökosystem als gemeinsame Sprache betrachten
Was ändert sich ADBC mit Arrow Database Connectivity?
ADBCist eine moderne Alternative zu ODBC und JDBC. Mit diesem auf Arrow basierenden Anschlussstandard kommen die Daten nicht in die Praxis, die Anwendung nähert sich Daten, die Integration zwischen analytischen Motoren wird vereinfacht und vor allem die Barrieren zwischen Data Science und Produktionssystemen beseitigt.
Offene Tischformate: Apache Iceberg Warum 2026 Gewinner?
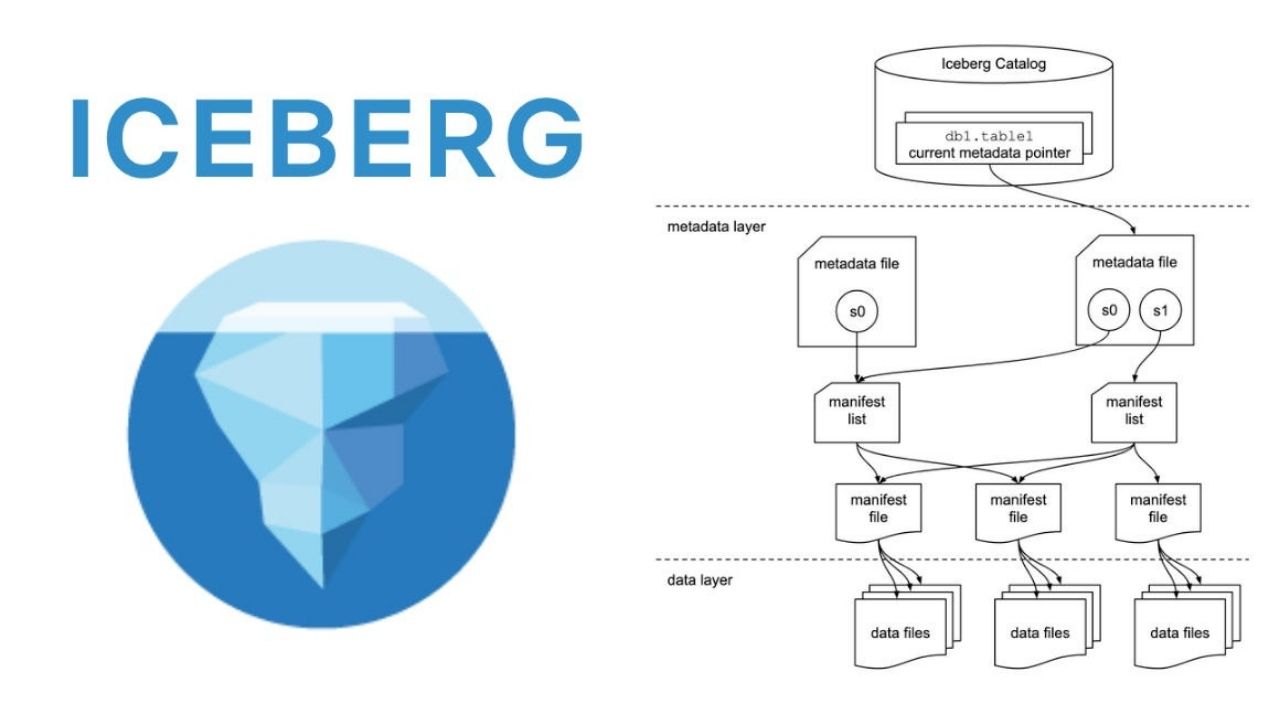
Apache-Eisberg Nicht nur technische Teams heute; auch CTO und Datenmanager stehen auf der Agenda. Iceberg zeichnet sich als offenes Tischformat aus, das Data Lake (Data Lack) Flexibilität, Data Warehouse-Disziplinen kombiniert.
Grundlegende Kompetenzen enthüllten Eisberg
- ACID-kompatible Tabellenoperationen Home
- Snapshot und Zeitreiseunterstützung
- Evolutionsentwicklung und retrospektive Kompatibilität
- Machen Sie die Dateiebene, aber im Tabellenverhalten
- Erstellen Sie Verwaltung und zuverlässige Tabellen in Dateiformaten wie Parquet
Der Händler ist ohne Sucht skalierbar; Multimotorische Unterstützung wie Spark, Trino, Flink, DuckDB; Durch die Zusammenführung von Echtzeit- und Batch-Analysen auf derselben Etage im Jahr 2026 wird Iceberg nun unter den offenen Tischformaten eingestuft.
DuckDB und DataFusion: Ende von Monolytic Data Warehouses
Traditionelle Data Warehouses waren teure und oft flexible Systeme. Doch neue Trends im Data Warehouse zeigen, wie wichtig skalierte Lösungen je nach Bedarf sind.
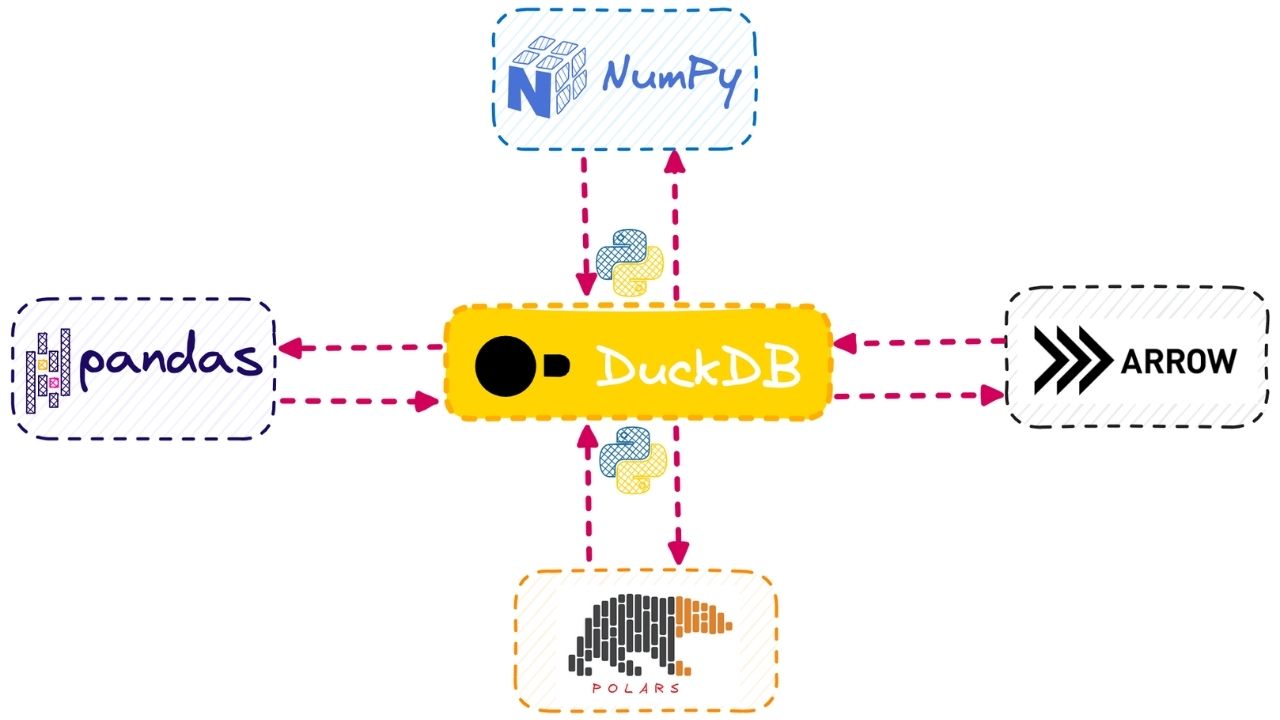
ZuhauseDie analytischen Abfragen sind eine Server-Abfrage-Engine, die direkt auf Dateien ausgeführt werden kann:
- Funktioniert ohne Installation.
- Direkte Abfragen von Parkett- und Iceberg-Tischen.
- Python ist natürlich kompatibel mit R- und Data Science-Tools.
- Bietet skalierbare Analysen für kleine Magie.
- Es macht Data Warehouse zu einer Non-Service-Komponente.
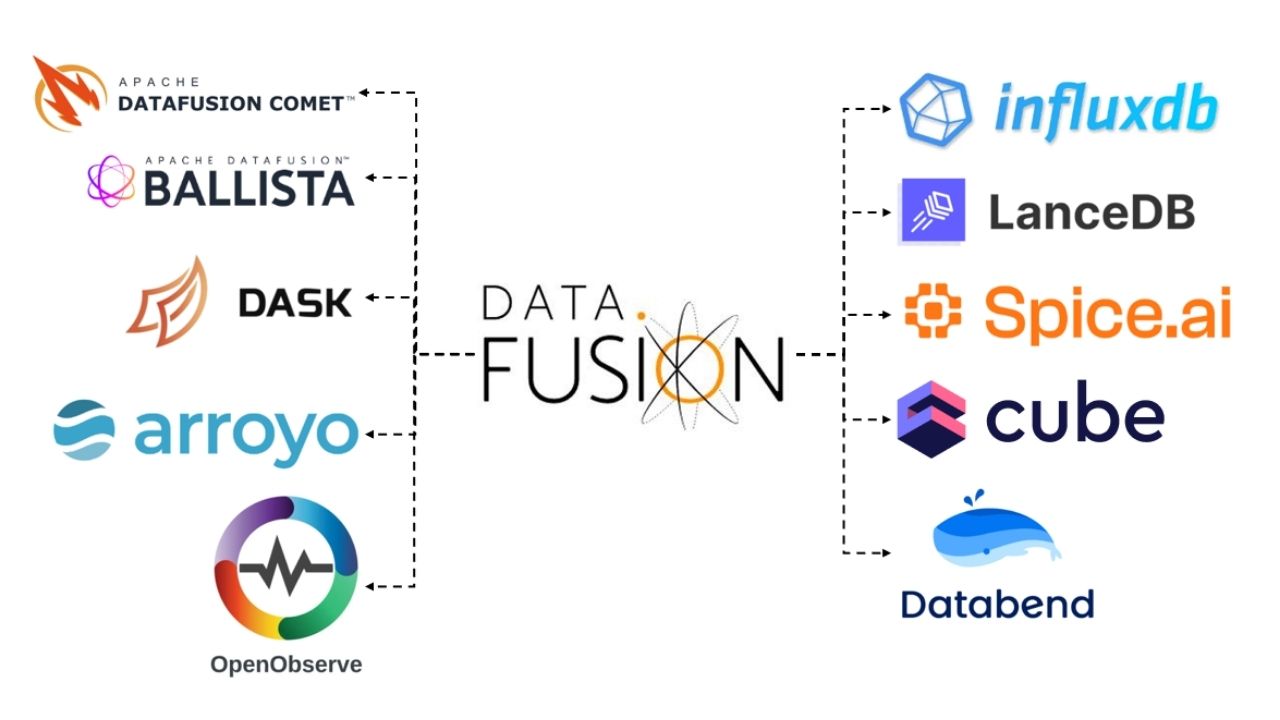
Apache DataFusion ist eine leistungsstarke Abfrage-Engine, die auf dem Arrow-Ökosystem basiert:
- Rust basiert und bietet Speichersicherheit
- Kann in eingebetteten oder verteilten Architekturen arbeiten
- Kompatibel mit Streaming und AI Workloads
DuckDB und DataFusion Bei der Betrachtung des Standorts monolithischer Data Warehouses Composable Analytics Ansatz gesehen wird.
Warum kritisches Denken an Tabellendaten für KI-Agenten?
Künstliche Intelligenzsysteme im Jahr 2026 werden nicht nur Text produzieren; Interaktion mit Daten, Entscheidungs- und Handlungsbereich KI-Agenten wird in den Vordergrund treten. Der Erfolg dieser Agenten wird direkt mit der Qualität der Dateninfrastruktur verbunden sein. Die Datenarchitektur der künstlichen Intelligenz ist auf Iceberg-Tabellen und Arrow-Speicherformaten installiert. Das zukünftige prompt Engineering wird im Data Engineering keine entscheidende Rolle spielen. Auch offene Standards werden weiterhin die Voraussetzung für KI-Skalierbarkeit sein. Im Jahr 2026 ist die Dateninfrastruktur geschlossen und nicht monolithisch, offen und modular, tischbasiert, sondern lacknativ, künstlich intelligent und gleichzeitig analysierend.
| 2026 Datentrends | Hauptfokuspunkt | Erwartete Wirkung |
| Apache-Eisberg | Offene Tischformate | Standardisierung und Produktionserfolg |
| Mehrmotorenstapel | Speichern und Computieren Separation | Kosteneinsparung und Flexibilität |
| AI Agent Integration u | Konfigurierte (Tabular-)Daten | Schneller und sicherer Datenzugriff nach Hause |
| ADBC-Standard | Datenverbindungsschicht | Wechsel des alten ODBC/JDBC Systems Home |
Autor:inApple Creator Studio: Tek Platformda Yaratıcılık Ekosistemi
Yazılım Mühendisliğinde 2026 AI Trendleri