DeepSeek R2 kommt: Effizienzrevolution in der KI ohne Nvidia
Automatisch übersetzt
 Autor:in
DeepSeek R2, das voraussichtlich in den nächsten Monaten verwendet wird, ist eines der stärksten Beispiele für Architekturen der neuen Generation, die darauf abzielen, die Hardwareabhängigkeit im KI-Bereich im Jahr 2026 zu reduzieren. Mit DeepSeek R1 stellt dieser Ansatz einen taktischen Wandel im Zentrum der KI-Trainingsmethoden, der Effizienz künstlicher Intelligenz und der Kostenoptimierung dar.
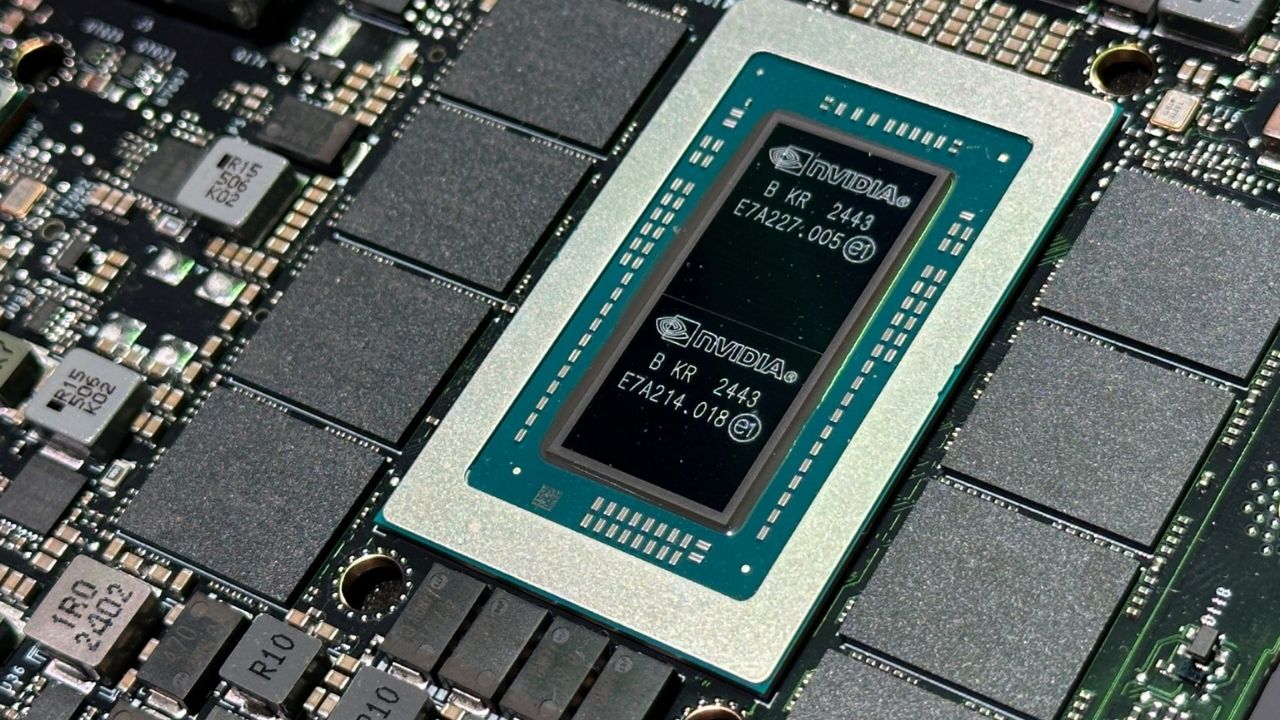
Der Nvidia-Chipangriff verursachte einen ernsthaften Versorgungsdruck im KI-Ökosystem, DeepSeek R2 erschien nicht nur aus technischer Sicht als strategische Lösung für einen Leistungswettbewerb mit weniger Hardwareanforderungen.
Kostengünstige KI-Formel: Manifold-Constrained Hyper-Connections
Als markantes Element der DeepSeek R2-Architektur sticht Manifold-Constrained Hyper-Connections hervor. Dieser Ansatz, der im Vergleich zu klassisch verbundenen Strukturen eine selektivere und kontextbewusstere Parameterinteraktion bietet, reduziert die Materialbelastung, indem er die Beziehung zwischen nur verknüpftem Probenraum ermöglicht. Effizienz künstlicher Intelligenz mit DeepSeek R2 nur dank dieser Struktur Inferenz nicht in der Bühne, es ist die Grundlage der Bildungsarchitektur. Der Beitrag dieser Struktur im Allgemeinen zur Effizienz künstlicher Intelligenz kann wie folgt dargestellt werden:
- Blockieren Sie unnötigen Informationsfluss
- Niedriger GPU-Speicherverbrauch Home
- Stabilerer und berechenbarerer Trainingsprozess
DeepSeek R2, Chat GPT und Google Gemini Rennsport
DeepSeek R2 ist ein Top-Level-LM, das mit der Mixture-of-Experts-Architektur des vorherigen DeepSeek R1 entwickelt wurde. Gerade bei der Lösung technischer und logischer Probleme werden ambitionierte Ergebnisse gepredigt. In China lokale Benchmarks wie C-Eval Es wird darauf hingewiesen, dass die Genauigkeitswerte in 90% erreicht werden. Dies zeigt auch, dass sich das Modell theoretisch auf GPT-Benzeri-Ebene befindet. Aber diese Zahlen sind noch nicht von unabhängigen Benchmark-Sets genehmigt.
Modelle wie ChatGPT-4 liefern zuverlässige Ergebnisse in akademischen Kenntnissen und NLP-Gesamttests. Zum Beispiel ist im Vergleich zu DeepSeek in der Metaanalyse die Gesamtinformationsgenauigkeit von ChatGPT bei mathematischen Problemen etwas höher und stabiler. Die aktuellen Nachrichten und die Genauigkeit der aktuellen Informationen von ChatGPT wurden jedoch als schwerwiegende Fehler und falsche Informationen eingestuft. Google Gemini bietet dank seiner multifunktionalen Funktionen und seines breiten Kontexts genaue Antworten auf visuelle und Textanfragen. Versionen wie Gemini Ultra in Benchmarks Allgemeine Informationen und Genauigkeitsprüfungen ist der führende Ort. Es bietet auch eine hohe Genauigkeit dank des Zugriffs auf aktuelle Ereignisse mit Echtzeit-Internet-Informationsintegration.
Auf der anderen Seite hat DeepSeek in einigen Audits Berichte, insbesondere in Richtung Nachrichtengenauigkeit und geringe Leistung in realen Inhalten. Diese Art von Ergebnissen zeigt, dass DeepSeek auf originelle Wissens- und Zuverlässigkeitsprobleme stoßen kann.
Zusammenfassend verspricht DeepSeek R2 theoretisch eine starke technische und domänenspezifische Genauigkeit, und insbesondere wenn die Benchmark-Tests auffallen, bietet ChatGPT eine ausgewogene Genauigkeit in Bezug auf allgemeine Informationen und konsistenten Sprachfluss. Google Gemini ist eine Zahl, die im aktuellen Kontext mit Echtzeitinformationen geworden ist.
Jetzt zeigt die Zuverlässigkeit von DeepSeek Variabilität gemäß Testsatz und Bindung. Es wäre falsch, eine präzise Bewertung ohne weitere und unabhängige Bewertungen vorzunehmen.
Was ist Infrastrukturoptimierung? Behebe ich ein Stabilitätsproblem?
Zu Beginn der Probleme, die in 27 Milliarden Parametern auftreten, treten Stabilitätsprobleme bei Bildung und Inferenz auf. DeepSeek R2 hat die Infrastrukturoptimierung direkt in die Architekturgestaltung für diese Lösung integriert. Layer-basiert für gesunde Integration AGC (adaptive grade clipping) Mit dynamischen Rescale-Mechanismen und Hardware-Awareness-Design wird Optimierung bereitgestellt. Dank dieser Optimierungen bietet DeepSeek R2 eine hohe Stabilität in der Produktion mit geringeren Hardwareanforderungen im Vergleich zu Hochparametermodellen.
KI-Wirtschaft im Jahr 2026: Kann Software Power Hardware-Mangel schließen?
2026 wird ein Jahr in der Optimierung nicht nur derjenigen sein, die über die leistungsstärkste Hardware in der KI-Wirtschaft verfügen, sondern auch über erfolgreiche Software- und Architekturinvestitionen. DeepSeek R2 wird als eines der Ergebnisse dieser Umwandlung angesehen. In diesem Zusammenhang ist DeepSeek R2 die Natur einer nachhaltigen KI-Wirtschaft, nicht nur ein technischer Erfolg.
Wirtschaftliche und technische Ergebnisse
- KI-Trainingsmethoden sind modularer geworden.
- Effiziente Architekturen werden anstelle von großen Parametermodellen bevorzugt.
- Die Nvidia-Chipkrise verwandelte die Softwareoptimierung in einen strategischen Vorteil im KI-Markt.
Nvidia Überleben unter Ambargosu: Chinas KI-Strategie
Der Nvidia-Chipangriff ist eine ernsthafte Einschränkung, insbesondere für chinesische Initiativen im KI-Bereich. Aber Liang Wenfeng und sein Team, bekannt als auch hinter Deepseek, haben die Gelegenheit für architektonische Innovationen genutzt, anstatt diese Einschränkungen als Mangel an Hardware zu sehen. Diese Strategie zeigt, dass Chinas KI-Ökosystem sein nachhaltiges Wachstumsmodell stärkt, anstatt zu versuchen, den Import von Hardware aufrechtzuerhalten. Grundlegende Komponenten der neuen Strategie; kleinere Chargengröße Stabiles Training kann als adaptive Lernraten sortiert werden, was unabhängige skalierbare Softwareschichten und Trainingszeit von Hardware verkürzt.
DeepSeek R2, Der mit DeepSeek R1 gestartete effizienzorientierte Ansatz zeigt konkret, dass die Softwarearchitektur im Ökosystem der künstlichen Intelligenz 2026 die Hardware passieren kann. Mehrsprachige Unterstützung ist auch ein neues Modell von DeepSeek R1. Manifold-beschränkte HyperverbindungenDiese Strategie, die aufgrund optimierter KI-Trainingsmethoden und Chip-Angriffen angewendet wird; dieser neue Modellschritt des in China ansässigen Unternehmens macht DeepSeek R2 zu einem fortschrittlichen Modell, das in den USA und Nvidia basiert.
| Merkmal | DeepSeek R1 (Alt) | DeepSeek R2 (Neu/Tahmin) |
| Haupttechnologie | Low Cost Reason g | Hyper-Verbindung / Manifold eingeschränkt |
| Hardware benötigt | Hohe Effizienz | Ultra Low Energy / Optimierung |
| Startdatum | 2025 | 2026 Februar (Frühlingsfest) |
| Rangziel | Top 15 (LiveBench) | Top 5 Ziele |
Autor:inGüney Kore Yapay Zeka Yasası Yürürlüğe Girdi: İşte Detaylar
AId Core Solutions: Yerli Sağlık Teknolojilerinde Yeni Dönem