



DeepSeek V3.1 Was ist Open Welded Artificial Intelligence Modell?
Automatisch übersetzt
Chinas Initiative für künstliche Intelligenz DeepSeekDas neue Modell am 21. August 2025 angekündigt DeepSeek V3.1. Dieses Open-Source-Modell für künstliche Intelligenz, das mit seiner hybriden Architektur, seiner 128K-Kontextkapazität und seinem kostengünstigen API-Zugang auf sich aufmerksam macht, ist nicht nur im Technologiebereich, sondern auch im globalen Wirtschafts- und Innovationsumfeld vertreten.
DeepSeek V3.1 Was?
DeepSeek V3.1 Es ist das neueste Sprachmodell, das von DeepSeek aus steigenden Initiativen für künstliche Intelligenz in China entwickelt und als Open-Source-Modell für künstliche Intelligenz veröffentlicht wurde. Der Ausdruck „Open Source bedeutet hier, dass der Code, die Parameter und die Nutzungsrichtlinien des Modells für alle offen sind. Diese Situation demokratisiert die Prozesse der Entwicklung künstlicher Intelligenz; das heißt, nicht nur riesige Technologieunternehmen, Universitäten, unabhängige Forscher und kleine Initiativen können diese Technologie auch nutzen.
DeepSeek V3.1 ist ein riesiges künstliches Intelligenzmodell mit 671 Milliarden Parametern. Parameter ist die Bezeichnung für Variablen, die im Lernprozess der künstlichen Intelligenz festgelegt werden. Da die Anzahl der Parameter eines Modells die Fähigkeit erhöht, komplexere Beziehungen zu lernen. DeepSeek verwendet jedoch nur 37 Milliarden aktive, anstatt alle diese Parameter gleichzeitig auszuführen. Diese Methode ist als Mixture of Experts (MoE) in der Literatur der künstlichen Intelligenz bekannt.
In der MoE-Architektur werden bei bestimmten Aufgaben unterschiedliche Fachnetzwerke aktiviert. Dieses Modell arbeitet sowohl schneller als auch effizienter. Zum Beispiel, wenn ein Benutzer nach Programmierfrage fragt, wird nur der Programmierspezialist aktiviert; Sprach- und Sommerspezialist arbeitet, wenn Literaturfrage kommt. Diese Struktur ist möglich, eine ähnliche oder überlegene Leistung bei geringerem Energieverbrauch als die Konkurrenz von DeepSeek V3.1 zu erbringen.
DeepSeek V3.1 Merkmale
DeepSeek V3.1 ist nicht nur Open Source, weil es ein Modell ist, das in der Welt der künstlichen Intelligenz Aufmerksamkeit erregt, sondern auch innovative technische Features hat. Viele Details von der Modellarchitektur bis zum Kontextfenster sind so konzipiert, dass sie auf unterschiedliche Bedürfnisse reagieren.
Eine der am häufigsten gesprochenen Funktionen von DeepSeek V3.1, Hybrid-Modus-System. Model hat zwei verschiedene Arbeitsmodi:
Denkmodus (Fallmodus): Das Modell durchläuft den Prozess des "inneren Denkens", bevor es eine komplexe Frage löst. Dies bedeutet die logischen Schritte, um den Geist zu simulieren, bevor die Antwort von AI erzeugt wird. Der Denkmodus ist langsamer, erzeugt aber tiefere und konsistente Reaktionen.
Nicht-Denken-Modus (geplanter Antwortmodus): Das Modell erzeugt eine schnelle Reaktion direkt. Dieser modus wird in oberflächlicheren fragen oder täglichen chats bevorzugt. Diese Funktion bietet Benutzern eine große Flexibilität. Zum Beispiel kann ein Softwareentwickler den "Denken" -Modus für ein komplexes Debugging-Problem wählen, ein Unternehmen, das den Kundensupport-Chatbot eingerichtet hat, kann schnell reagieren, indem es den "Nicht-Denken" -Modus wählt.
Ein weiteres Merkmal des Modells ist die MoE – Mixture of Experts (Experts Mix) Methode. In diesem System gibt es zahlreiche Submodelle, die auf verschiedene Angelegenheiten spezialisiert sind. Wenn der Benutzer einen Befehl gibt, aktiviert das Modell nur die notwendigen aus diesen Submodellen. Dieser Ansatz hat zwei wichtige Vorteile:
Es wird keine unnötige Rechenleistung aufgewendet, so dass die Kosten reduziert werden.
Dank der Kombination von spezialisierten Modellen steigt die Genauigkeitsrate der Antworten.
DeepSeek V3.1, insbesondere als LLM (Great Language Model) NLP (Natural Language Processing) Stark im Feld. Dies bedeutet, dass das Modell die Fähigkeit hat, die menschliche Sprache zu verstehen, zu produzieren und umzuwandeln. Benutzer können DeepSeek in vielen verschiedenen Bereichen verwenden, z. B. Textabstraktion, Übersetzung, Frage-Cevap, Gefühlsanalyse oder Codeschreiben. Besonders mehrsprachige Unterstützung ist ein wichtiger Vorteil für verschiedene Nutzergruppen auf globaler Ebene.
DeepSeek V3.1 hat einen viel größeren Trainingsprozess als frühere Versionen durchlaufen. 32K Kontextfenstertraining: Laufen auf 630 Milliarden Token (Balsamfaden). Dies bedeutet 10-mal mehr Trainingsdaten aus der V3-Version.
128K Kontextfenstertraining: trainiert mit 209 Milliarden Token. Das ist 3,3 mal mehr als in früheren Versionen. „Bağlam-Fenster (Kontextfenster) bezieht sich auf die Textlänge, an die sich das Modell gleichzeitig erinnern kann. 128K Kontextunterstützung ermöglicht es, ein Buch von etwa 400 Seiten gleichzeitig zu analysieren. Dies ist ein großer Vorteil in Bereichen, in denen sehr lange Texte wie Recht, Wissenschaft, Medizin und Software verarbeitet werden.
DeepSeek V3.1 arbeitet zu viel geringeren Kosten im Vergleich zu seinen Mitbewerbern dank seiner Hybridstruktur und MoE-System. Laut unabhängigen Tests mit Sitz in China bietet das Modell im Vergleich zu einigen Wettbewerbern mehr als 40-mal günstigere Handelskosten. Diese Situation schafft einen großen Vorteil der Zugänglichkeit vor allem für kleine Unternehmen oder einzelne Entwickler.
DeepSeek V3.1 Update: Terminus Version u
DeepSeek hat das V3.1-Modell „DeepSeek V3.1-Therminus im September 2025 aktualisiert und signifikante Verbesserungen zur Verbesserung der Leistung und Stabilität des Modells vorgestellt. Dieses Update zeichnet sich als optimierte Version der bestehenden V3.1-Architektur und nicht als völlig neues Modell aus.
In Verbindung mit der Terminus-Version hat das Modell bemerkenswerte Verbesserungen in der Qualität der Sprachverarbeitung und Output-Produktion gebracht. Rechtzeitig aufgetretene Sprachverwirrung und unkonsistente Ausdrücke in früheren Versionen sind weitgehend entfernt, das Modell wurde fließender und genauer Texte produziert.
Ein weiterer wichtiger Aspekt des Updates sind die Entwicklungen in ihren Agenten (Ajan) Fähigkeiten. Insbesondere wird ein Leistungszuwachs bei Systemen beobachtet, die bei der Codeproduktion und bei der Informationssuche eingesetzt werden. Dies zeigt, dass DeepSeek V3.1 nicht nur ein Textproduktionswerkzeug ist, sondern auch ein System der künstlichen Intelligenz, das erweiterte Aufgaben ausführen kann.
Auch mit der Terminusversion wird die Gesamtstabilität des Modells erhöht, konsistentere und zuverlässigere Ausgänge werden erzeugt. Diese Verbesserungen erhöhen die Präferenzen von DeepSeek in Unternehmensnutzungs- und Produktionsumgebungen erheblich.
Kurz gesagt, das Update DeepSeek V3.1-Therminus bietet eine wichtige Entwicklung in Bezug auf Leistung, Genauigkeit und Nutzungszuverlässigkeit, ohne die technische Basis des Modells zu ändern.
DeepSeek V3.1 Einsatz von Open Source Künstliche Intelligenz Modell
Softwareentwicklung: Codeschreiben, Debuggen, Algorithmusbeschreibung. |
Academic Studies: Der Artikel fasst zusammen, Literatur-Scan, Abschlussarbeit Vorbereitung. |
Content Production: News Writing, Szenario-Erstellung, kreative Geschichten. |
Unternehmensintegrationen: Kundensupport-Chatbots, Automatisierung von Geschäftsprozessen. |
Forschung: Große Datenanalyse, Bioinformatik, sozialwissenschaftliche Forschung. |
Kurz gesagt, DeepSeek V3.1 ist nicht nur für Tech-Enthusiasten, sondern auch ein leistungsstarkes Werkzeug für industrielle Lösungen und akademische Forschung.
DeepSeek V3.1 Preise und Pläne
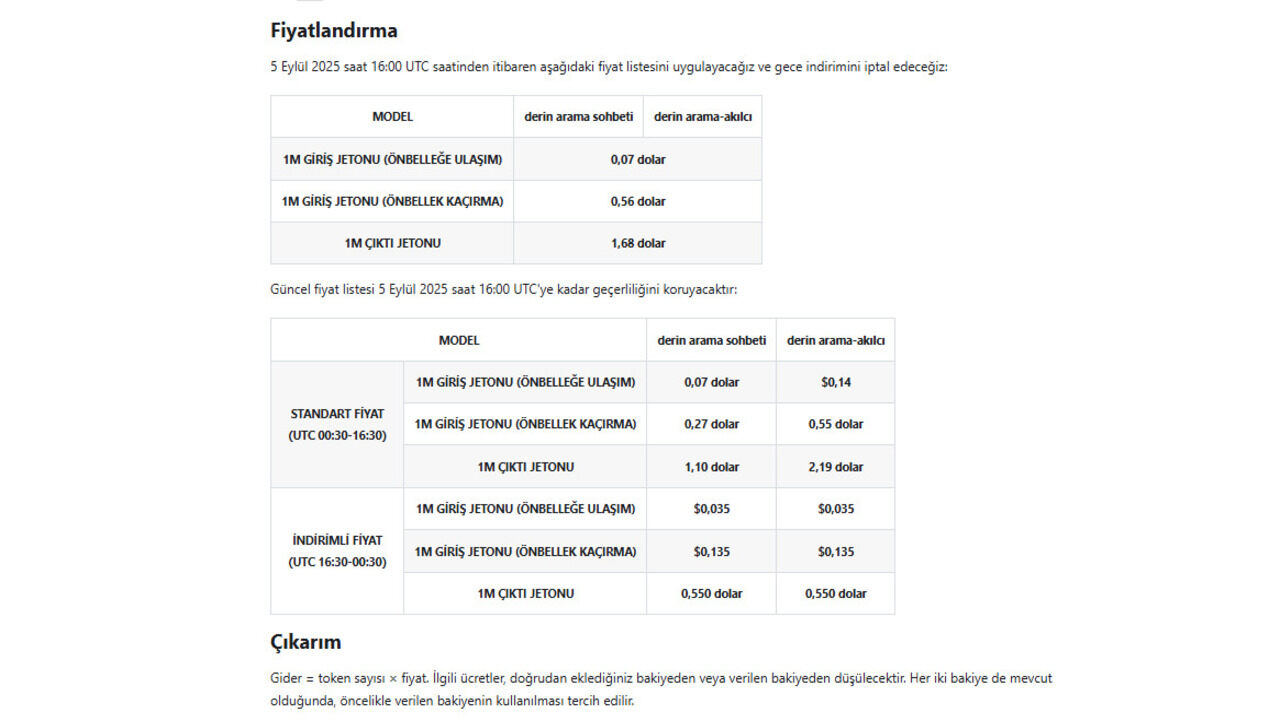
DeepSeek V3.1 bietet ein flexibles und transparentes Preissystem, das auf die unterschiedlichen Bedürfnisse der Benutzer abgestimmt ist. Die Kosten des Modells werden sowohl für den vom Benutzer gesendeten Text (Input Jet / Input Token) als auch für die vom Modell generierten Antworten (Out Jet / Output Token) berechnet.
Cache-Hit bedeutet eine Wiederverwendung einer zuvor verarbeiteten Abfrage und reduziert die Kosten. Cache miss bezieht sich jedes Mal auf neue Transaktionen und erhöht die Kosten.
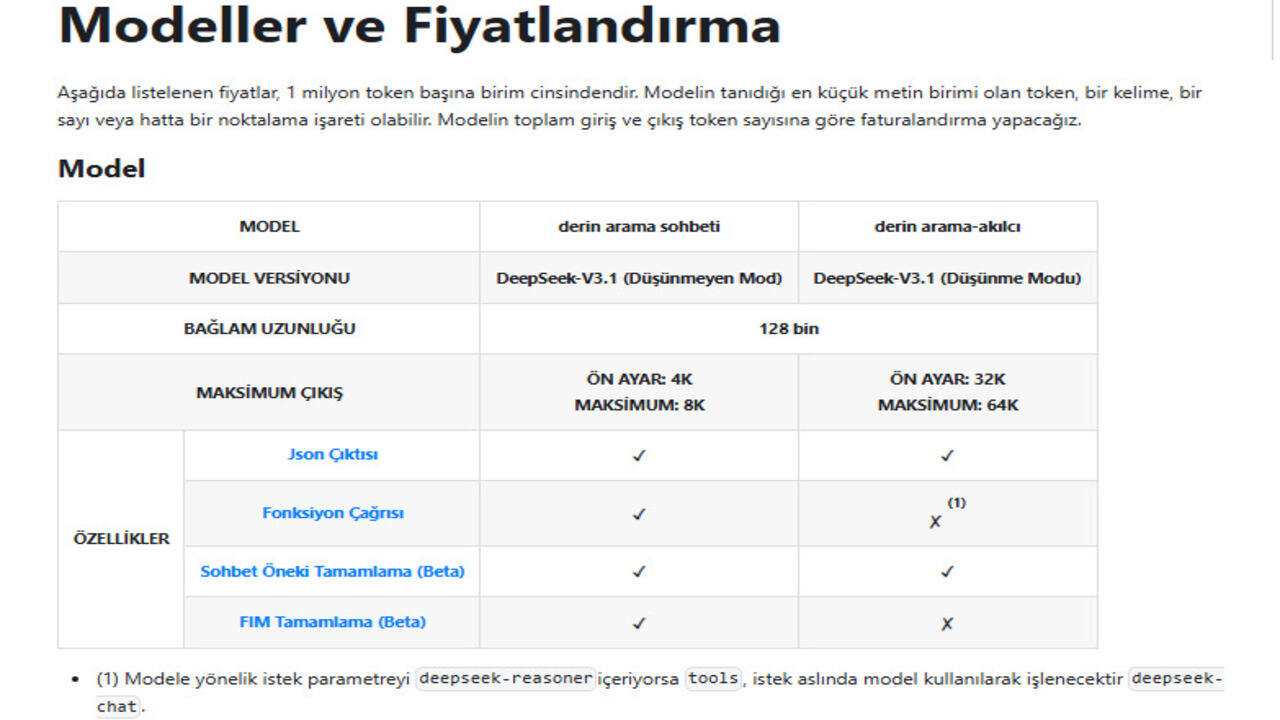
DeepSeek V3.1 Preise
Preisgestaltung:
DeepSeek Chat:
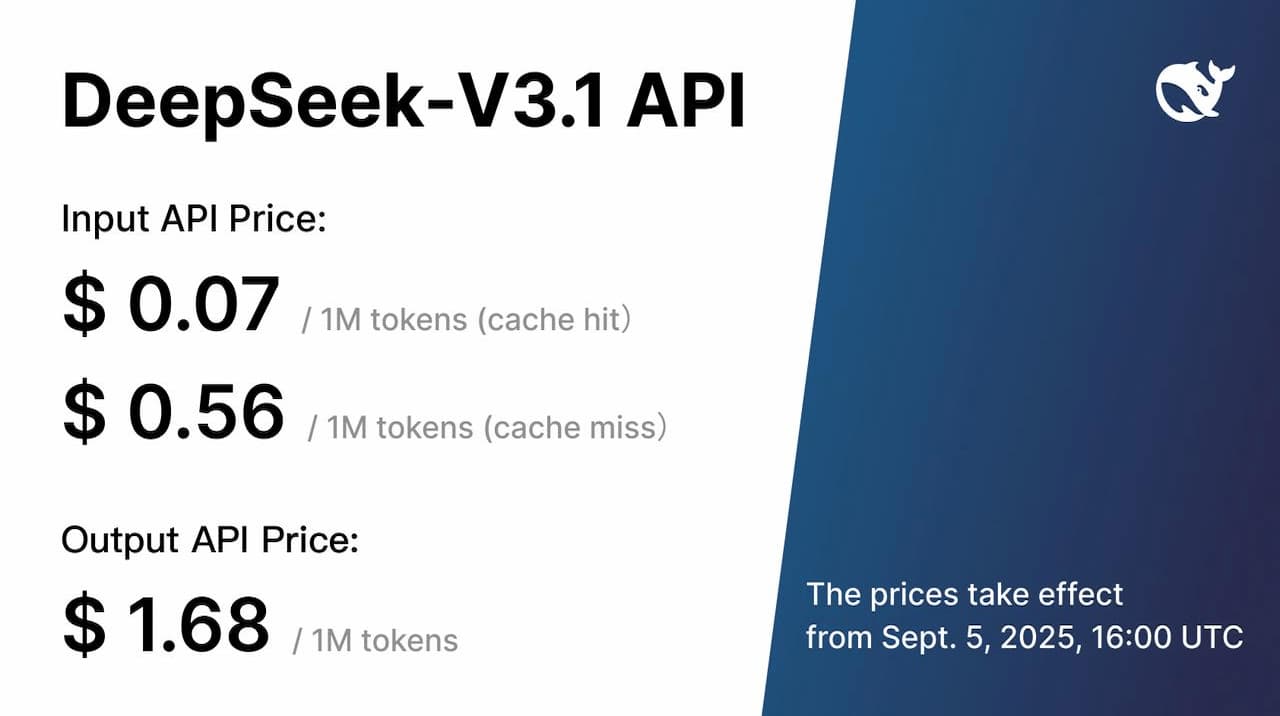
Input Jet (Cache-Hit) = 0,07 $ / 1M Token
Input Jet (Cache Miss) = 0,56 $ / 1M Token
Ausgabe Jet = 1,68 $ / 1M Token
DeepSeek-Smart:
Die Preisdetails werden noch nicht bekannt gegeben; Benutzern wird empfohlen, den Updates zu folgen.
Wichtige Konzepte und Kostenkalkulation
Eingabe-Token (Input-Token): Text, Frage oder Befehl, den der Benutzer an das Modell sendet.
Output Token (Output Token): Der vom Modell erzeugte Antworttext.
Transport zum Cache (Cache Hit): Wiederverwendung einer zuvor bearbeiteten Abfrage → bieten Kostenvorteil.
Cache Miss (Cache Miss): Neue Transaktion → höhere Kosten.
Kostenberechnungsformel: Gesamtkosten = (Anzahl der Eintritts-Token × Eintritts-Token-Preis) + (Anzahl der Token × Ausgabe-Token-Preis)
Zahlungsoptionen
DeepSeek ermöglicht es Benutzern, ihre Zahlungen einfach zu verwalten:
Die Gebühren werden vom zusätzlichen oder Werbeguthaben des Benutzers abgezogen; dies wird in erster Linie verwendet, wenn ein Werbeguthaben vorhanden ist.
Zahlungsmethoden umfassen Kreditkarte, Banküberweisung und PayPal.
Die abrechnungsbasierte Zahlungsoption ist für Firmenkunden verfügbar.
Für detaillierte Informationen und aktuelle Preispläne wird DeepSeek empfohlen, der offiziellen Website zu folgen.
DeepSeek V3.1 und Rivalen
DeepSeek V3.1 hat nicht nur ein starkes Modell für sich, sondern bietet auch einige Vorteile, die sich von bestehenden Large Language Models (LLM) und Systemen der künstlichen Intelligenz abheben. Zu den bekanntesten Wettbewerbern zählen die GPT-4-Serie von OpenAI, die Claude-Modelle von Anthropic und die LLaMA-Modelle von Meta.
Nutzungszwecke
DeepSeek V3.1: Akademische Forschung, lange Textanalyse, kreatives Schreiben, Codieren, Corporate Chatbots.
GPT-4/Claude: Allgemeiner chat, textproduktion, codierung, forschung. DeepSeek ist jedoch vorteilhafter in langen Kontexten und kostengünstiger lokaler Nutzung.
LLAMA: Mehr Forschung und experimentelle Nutzung orientierte, kommerzielle API-Integration begrenzt.
Leistungsvergleich
Aider Coding Benchmark: DeepSeek V3.1 ist 1% höher als Claude Opus 4. Dies bietet Überlegenheit, insbesondere bei der Codierung und Algorithmuslösung.
Lange Textverarbeitung: Das 128K-Token-Kontextfenster von DeepSeek, die 32-64K-Tokenkapazität von GPT-4 und Claude ermöglichen es Ihnen, viel längere Texte gleichzeitig zu verarbeiten. Dies ist ein großer Vorteil für lange Datensätze wie Rechts-, Hochschul- und Softwareprojekte.
Natürliche Sprache verstehen und produzieren: DeepSeek V3.1 in NLP-Aufgaben (Text skizziert, Übersetzung, Gefühlsanalyse) hat ähnliche Genauigkeitsraten wie seine Konkurrenten, aber es arbeitet schneller und energieeffizient.
Kostenvergleich
Einer der größten Vorteile von DeepSeek V3.1 sind die Kosten. Im Einsatz über die API erscheinen die Kosten 20-40 mal niedriger als bei OpenAI und Anthropic Modellen.
Dank Think-Modus und MoE-Architektur wird der Energieverbrauch minimiert, da keine unnötigen Parameter ausgeführt werden. Dies bietet auch einen wichtigen Sparvorteil für Unternehmen.
Flexibilität und Customization
Die Open Source ist eine der größten Eigenschaften, die DeepSeek von seinen Mitbewerbern unterscheidet. Mit Hugging Face und GitHub ist es möglich, auf die Modellcodes zuzugreifen, die eine Anpassung und lokale Nutzung ermöglichen.
Die Konkurrenzmodelle sind in der Regel eingeschlossen und nur über die API zugänglich. Dies kann für einige Entwickler und Forscher einschränkend sein.
Positive und negative Richtungen
Positive Richtungen | Negativrichtungen |
Open Welded - Modell ist offen für alle unter MIT-Lizenz. Dies ermöglicht es Entwicklern, transparent zu überprüfen und anzupassen. | Sicherheitsrisiken - Open-Source-Modelle können für Dezenformationen oder Cyberangriffe von böswilligen Personen verwendet werden. |
Kostenvorteil - 20-40 mal billiger als mitbewerber, völlig kostenlos, wenn sie vor ort sind.
Hardware-Anforderungen – Es gibt starke GPUs und großes Gedächtnis muss lokal laufen.
Hybridarchitektur – Es kann sich an verschiedene Szenarien mit Denk- und Nicht-Denkmodi anpassen.
Sprachunterstützungsprobleme - Nicht so stark wie OpenAI-Modelle, insbesondere in türkischen und regionalen Sprachen.
Hochleistung – Claude und GPT-basierte Wettbewerber in Benchmark-Tests.
Regulierungsspezifität – Da die Kontrolle von Open Source künstlicher Intelligenz schwierig ist, können die Regulierungsdiskussionen der Regierung zunehmen.
Wide Bond Capacity – Mit 128K-Token-Unterstützung kann der entsprechende Text zu 400 Seiten gleichzeitig verarbeitet werden.
Langsamkeit des Denkmodus - Obwohl er genauere Antworten erzeugt, kann der Denkmodus zu Verzögerungen bei Echtzeitanwendungen führen.
Flexibler Nutzungsbereich – Softwareentwicklung, Wissenschaft, Journalismus, Kundenservice.
OpenAI: ChatGPT Erotik İçerik Sunmaya Hazırlanıyor
Tasarım Yapay Zeka ile Nasıl Kullanılır?


