



DeepSeek V4 vorgestellt: 1 Million Token und 1.6T Parameter!
Automatisch übersetzt
China basiert auf DeepSeekMit dem V4-Modell, 1 Million Token-Kontexten und 1,6 Billionen Parametern wurden Skalierung, Effizienz und Kostenbalance in der künstlichen Intelligenz neu definiert.
Was ist DeepSeek V4 und warum wichtig?
Der Wettbewerb im Bereich der künstlichen Intelligenz ist nicht nur durch die Modellgenauigkeit gegeben; während die Kontextlänge durch Parameter wie Bearbeitungskosten und Skalierbarkeit neu definiert wird, wird das von DeepSeek eingeführte DeepSeek V4-Modell als eines der konkretesten Beispiele für diese Umwandlung positioniert. Die Frage „Was ist DeepSeek V4? beschränkt sich nicht nur auf eine neue Modelldefinition, sondern bezieht sich auch auf den Bruch der Technikarchitektur großer Sprachmodelle (LLM). Die 1 Million Token-Kontextkapazität des Modells, die lange Textverarbeitung, die Codeanalyse und eine radikale Erweiterung der mehrstufigen Argumentationsaufgaben, die 1,6 Billionen Parameterskala stellen die neue Schwelle dar, die künstliche Intelligenz in der Rechenleistung erreicht.
Diese Entwicklung ist möglich, mehr Informationen in einer einzigen Sitzung in den Bereichen Finanzen, Recht, Software Engineering und akademische Forschung, insbesondere in datenintensiven Branchen, zu verarbeiten. Analyseprozesse, die in traditionellen Modellen an die Kontextgrenze angehängt werden, können nun kontinuierlich auf viel breiteren Datenclustern durchgeführt werden. Das bedeutet nicht nur Leistungssteigerung, sondern auch eine Neugestaltung von Workflows.
Die DeepSeek V4-Serie bedeutet nicht nur Skalierungswachstum, sondern auch architektonische Neugestaltung. Die von DeepSeek entwickelte Modellfamilie wird mit zwei verschiedenen Strukturen präsentiert, darunter DeepSeek-V4-Pro und DeepSeek-V4-Flash. Open Source in der offiziellen Hugging Face Sammlung Das als 1M-Kontextstandard veröffentlichte Modell zielt darauf ab, die Branche zu einer neuen Norm zu machen.
1 Million Token Künstliche Intelligenz: Grant Limits
Die 1 Million Token-Kontextkapazität, eine der bemerkenswertesten Innovationen von DeepSeek V4, gilt als einer der größten technischen Sprünge, die jemals in künstlichen Intelligenzmodellen aufgetreten sind. Während das Token als eine der kleinsten Einheiten definiert ist, die aus einem Text verarbeitet werden können, bedeutet dies, dass die Kapazität 1 Million erreicht; Hunderte von Seitendokumenten können gleichzeitig mit großen Codebasen oder mehrschichtigen Datensätzen analysiert werden.
Diese Entwicklung schafft einen ernsthaften Vorteil, insbesondere bei Aufgaben, die einen langen Kontext erfordern. Zum Beispiel; Die Analyse des gesamten Gesetzestextes, Prozesse wie Debugging in großen Softwareprojekten oder ein umfassender Vergleich von akademischen Artikeln können jetzt auf die gesamte Weise durchgeführt werden, nicht auf Teile. Dies beseitigt das Problem des Modells "Lichtkontinuität" erheblich.
DeepSeek V4 Hybride Aufmerksamkeitsarchitektur Dank seiner langen Kontextverarbeitung bietet es erhebliche Effizienzgewinne. Das Modell mit der Kombination von Compressed Sparse Attention (CSA) und Heavily Attention Compressed (HCA) kann mit viel niedrigeren Berechnungskosten arbeiten als frühere Generationen. Insbesondere wird die Verwendung von KV-Cache im 1M-Token-Szenario als deutlich reduziert angezeigt.
Mixture of Experts Architecture: Skalierbarer Intelligenzansatz
Mixture of Experts (MoE)-Architektur, die sich im technischen Rückgrat von DeepSeek V4 befindet, zeichnet sich als grundlegender Mechanismus aus, der es dem Modell ermöglicht, trotz der hohen Anzahl von Parametern effizient zu arbeiten. Diese Architektur ermöglicht es, das gesamte Modell nur verwandte "spezielle" Subnetzwerke für bestimmte Aufgaben zu aktivieren, anstatt gleichzeitig zu laufen.
Dieser Ansatz bietet einen erheblichen Berechnungsvorteil gegenüber klassischen Intensivmodellen. Anstatt das gesamte Modell mit 1,6 Billionen Parametern zu verwenden, werden nur die notwendigen Teile aktiviert; sowohl die Kosten für die Verarbeitung reduzieren als auch die Reaktionszeit optimieren. Diese Situation zeichnet sich insbesondere als kritischer Faktor aus, der sich direkt auf die Kosten-Leistungs-Balance bei der API-Nutzung auswirkt.
Die MoE-Architektur bietet auch höhere Genauigkeitsraten, so dass das Modell Experten für verschiedene Arten von Aufgaben sein kann. Das macht DeepSeek V4 nicht nur groß, sondern auch ein „Smart-Scale-Modell.
Die Pro- und Flash-Modelle in der DeepSeek V4-Architektur sind in verschiedene aktive Parameterebenen unterteilt. DeepSeek-V4-Pro 1.6T arbeitet mit 13B aktiven Parameter in Gesamtparameter von 49B, DeepSeek-V4-Flash 284B. Diese Struktur ist der Hauptvorteil der MoE Architektur.Berechnung so viel wie nötig„Wir setzen das Prinzip direkt um.
Die mHC-Struktur (Manifold-Constrained Hyper-Connections) in der Architektur von DeepSeek V4 ermöglicht es dem Modell, die Ausdrucksleistung zu schützen und gleichzeitig den Informationsfluss zwischen den Schichten zu stabilisieren. Darüber hinaus bietet die Verwendung von Muon-Optimierung eine schnellere Konvergenz und eine stabilere Lerndynamik im Bildungsprozess.
KV Cache Effizienz: Geheime Stärke von Long Connect
Ein weiteres Element, das für die praktische Nutzung von langer Kontextkapazität entscheidend ist, ist die KV-Cache-Optimierung (Key-Value Cache). KV Die in DeepSeek V4 entwickelte Cache-Effizienz reduziert die Verarbeitungslast erheblich, indem das Modell frühere Token ohne Neuberechnung verwenden kann.
Diese technische Verbesserung wirkt sich direkt auf die Leistung in Anwendungen aus, die lange Dialoge und einen kontinuierlichen Datenfluss erfordern. Zum Beispiel kann ein System der künstlichen Intelligenz mit langfristiger Interaktion mit einem Benutzer schnelle und konsistente Antworten erzeugen, ohne die gesamte Geschichte in jedem neuen Eintrag neu verarbeiten zu müssen.
Die KV-Cache-Optimierung spielt auch im Hinblick auf die Energieeffizienz eine entscheidende Rolle. Weniger Berechnungsaufwand bedeutet geringeren Energieverbrauch, was sich direkt auf die Betriebskosten in großen Rechenzentren auswirkt.
DeepSeek V4-Pro arbeitet mit etwa 10% KV-Cache-Nutzung im 1M-Kontextszenario im Vergleich zu DeepSeek-V3.2, Inferenz FLOPs Seite bietet auch eine effizientere Struktur bei 27%. Diese Optimierung sorgt für eine deutliche Leistungssteigerung, insbesondere in Long-Chat- und Agenten-basierten Anwendungen.
DeepSeek V4 Pro Features: Leistung auf Unternehmensebene
DeepSeek V4 Pro ist als stärkste Version der Modellfamilie positioniert und konzentriert sich vor allem auf Unternehmensnutzungsszenarien. Erweiterte Denkfähigkeiten, langes Kontextmanagement und hohe Genauigkeitsraten machen diese Version ideal für Projekte, die eine große Datenverarbeitung erfordern.
Eine der wichtigsten Funktionen der Pro-Version kann bei komplexen Aufgaben konsistentere Ergebnisse liefern. Sehr schrittweise Problemlösung, fortgeschrittene Codeproduktion und analytische Aufgaben, die Leistung des Modells ist prominent. Darüber hinaus können Unternehmen dank der flexiblen Struktur, die über die API angeboten wird, das Modell nach ihren Bedürfnissen integrieren.
DeepSeek V4 Flash vs Pro: Leistung und Kostenausgleich
Flash- und Pro-Versionen, die in der DeepSeek V4-Familie enthalten sind, sind für verschiedene Nutzungsszenarien geeignet. Flash-Version, mit geringerer Latenz und Kostenvorteil; Pro-Version arbeitet mit maximaler Leistung und Genauigkeit.
Das Flash-Modell ist für Echtzeit-Apps wie Chatbots, Kundenservice und schnelle Content-Produktion optimiert. Das entsprechende Pro-Modell wird bei schwereren und komplexen Aufgaben bevorzugt. Diese Unterscheidung ermöglicht es Entwicklern, das richtige Modell nach ihren Bedürfnissen zu wählen.
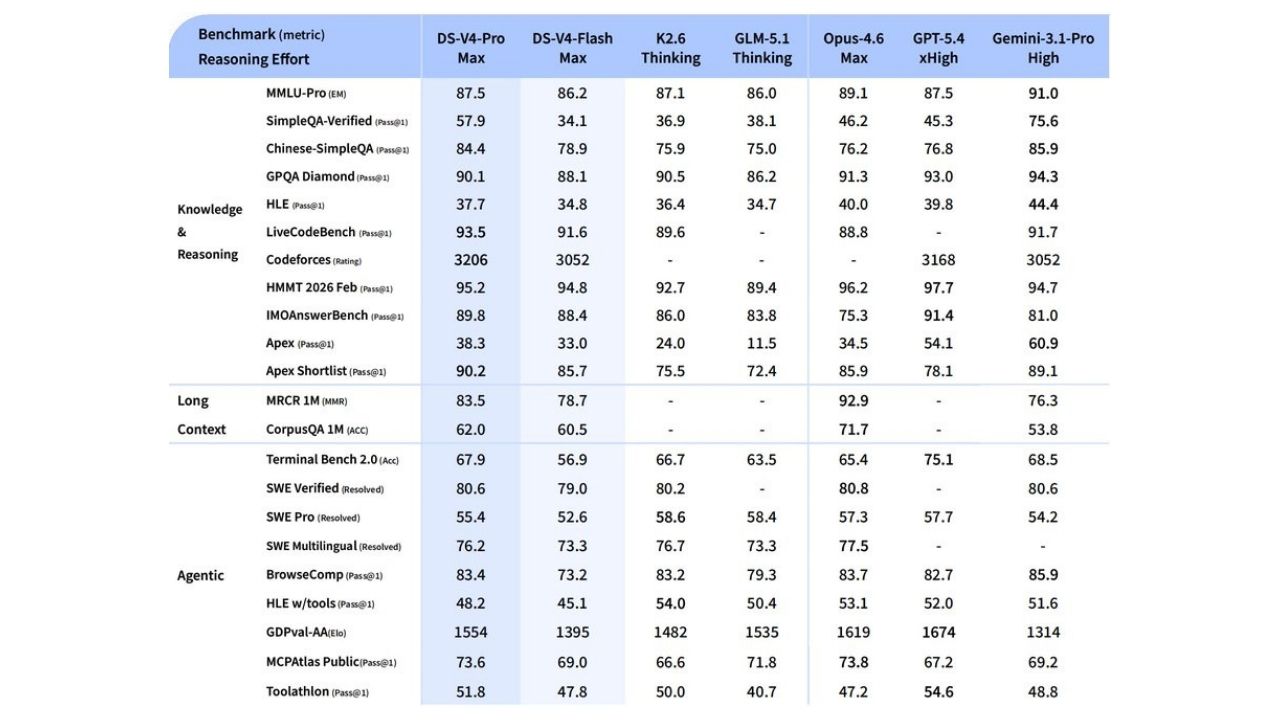
Das Flash-Modell bietet eine geringere Latenz dank seiner kleineren aktiven Parameterstruktur im Vergleich zur Pro-Version, während einfache Agentenaufgaben in der Nähe des Pro-Levels ausgeführt werden können. Das entgegengesetzte Pro-Modell ist besonders komplexes Denken, klare Suche nach Codierung und wissenschaftliche Problemlösungsaufgaben stärkere Ergebnisse produzieren.
DeepSeek V4 API-Preisgestaltung: Wettbewerbsstrategie
Die DeepSeek V4 API-Preisgestaltung wird als aggressive Wettbewerbsstrategie unter Berücksichtigung der technischen Kapazität des Modells bewertet. Aufgrund seiner MoE-Architektur spiegeln sich die reduzierten Verarbeitungskosten als erschwinglichere API-Erfahrung für den Benutzer wider.
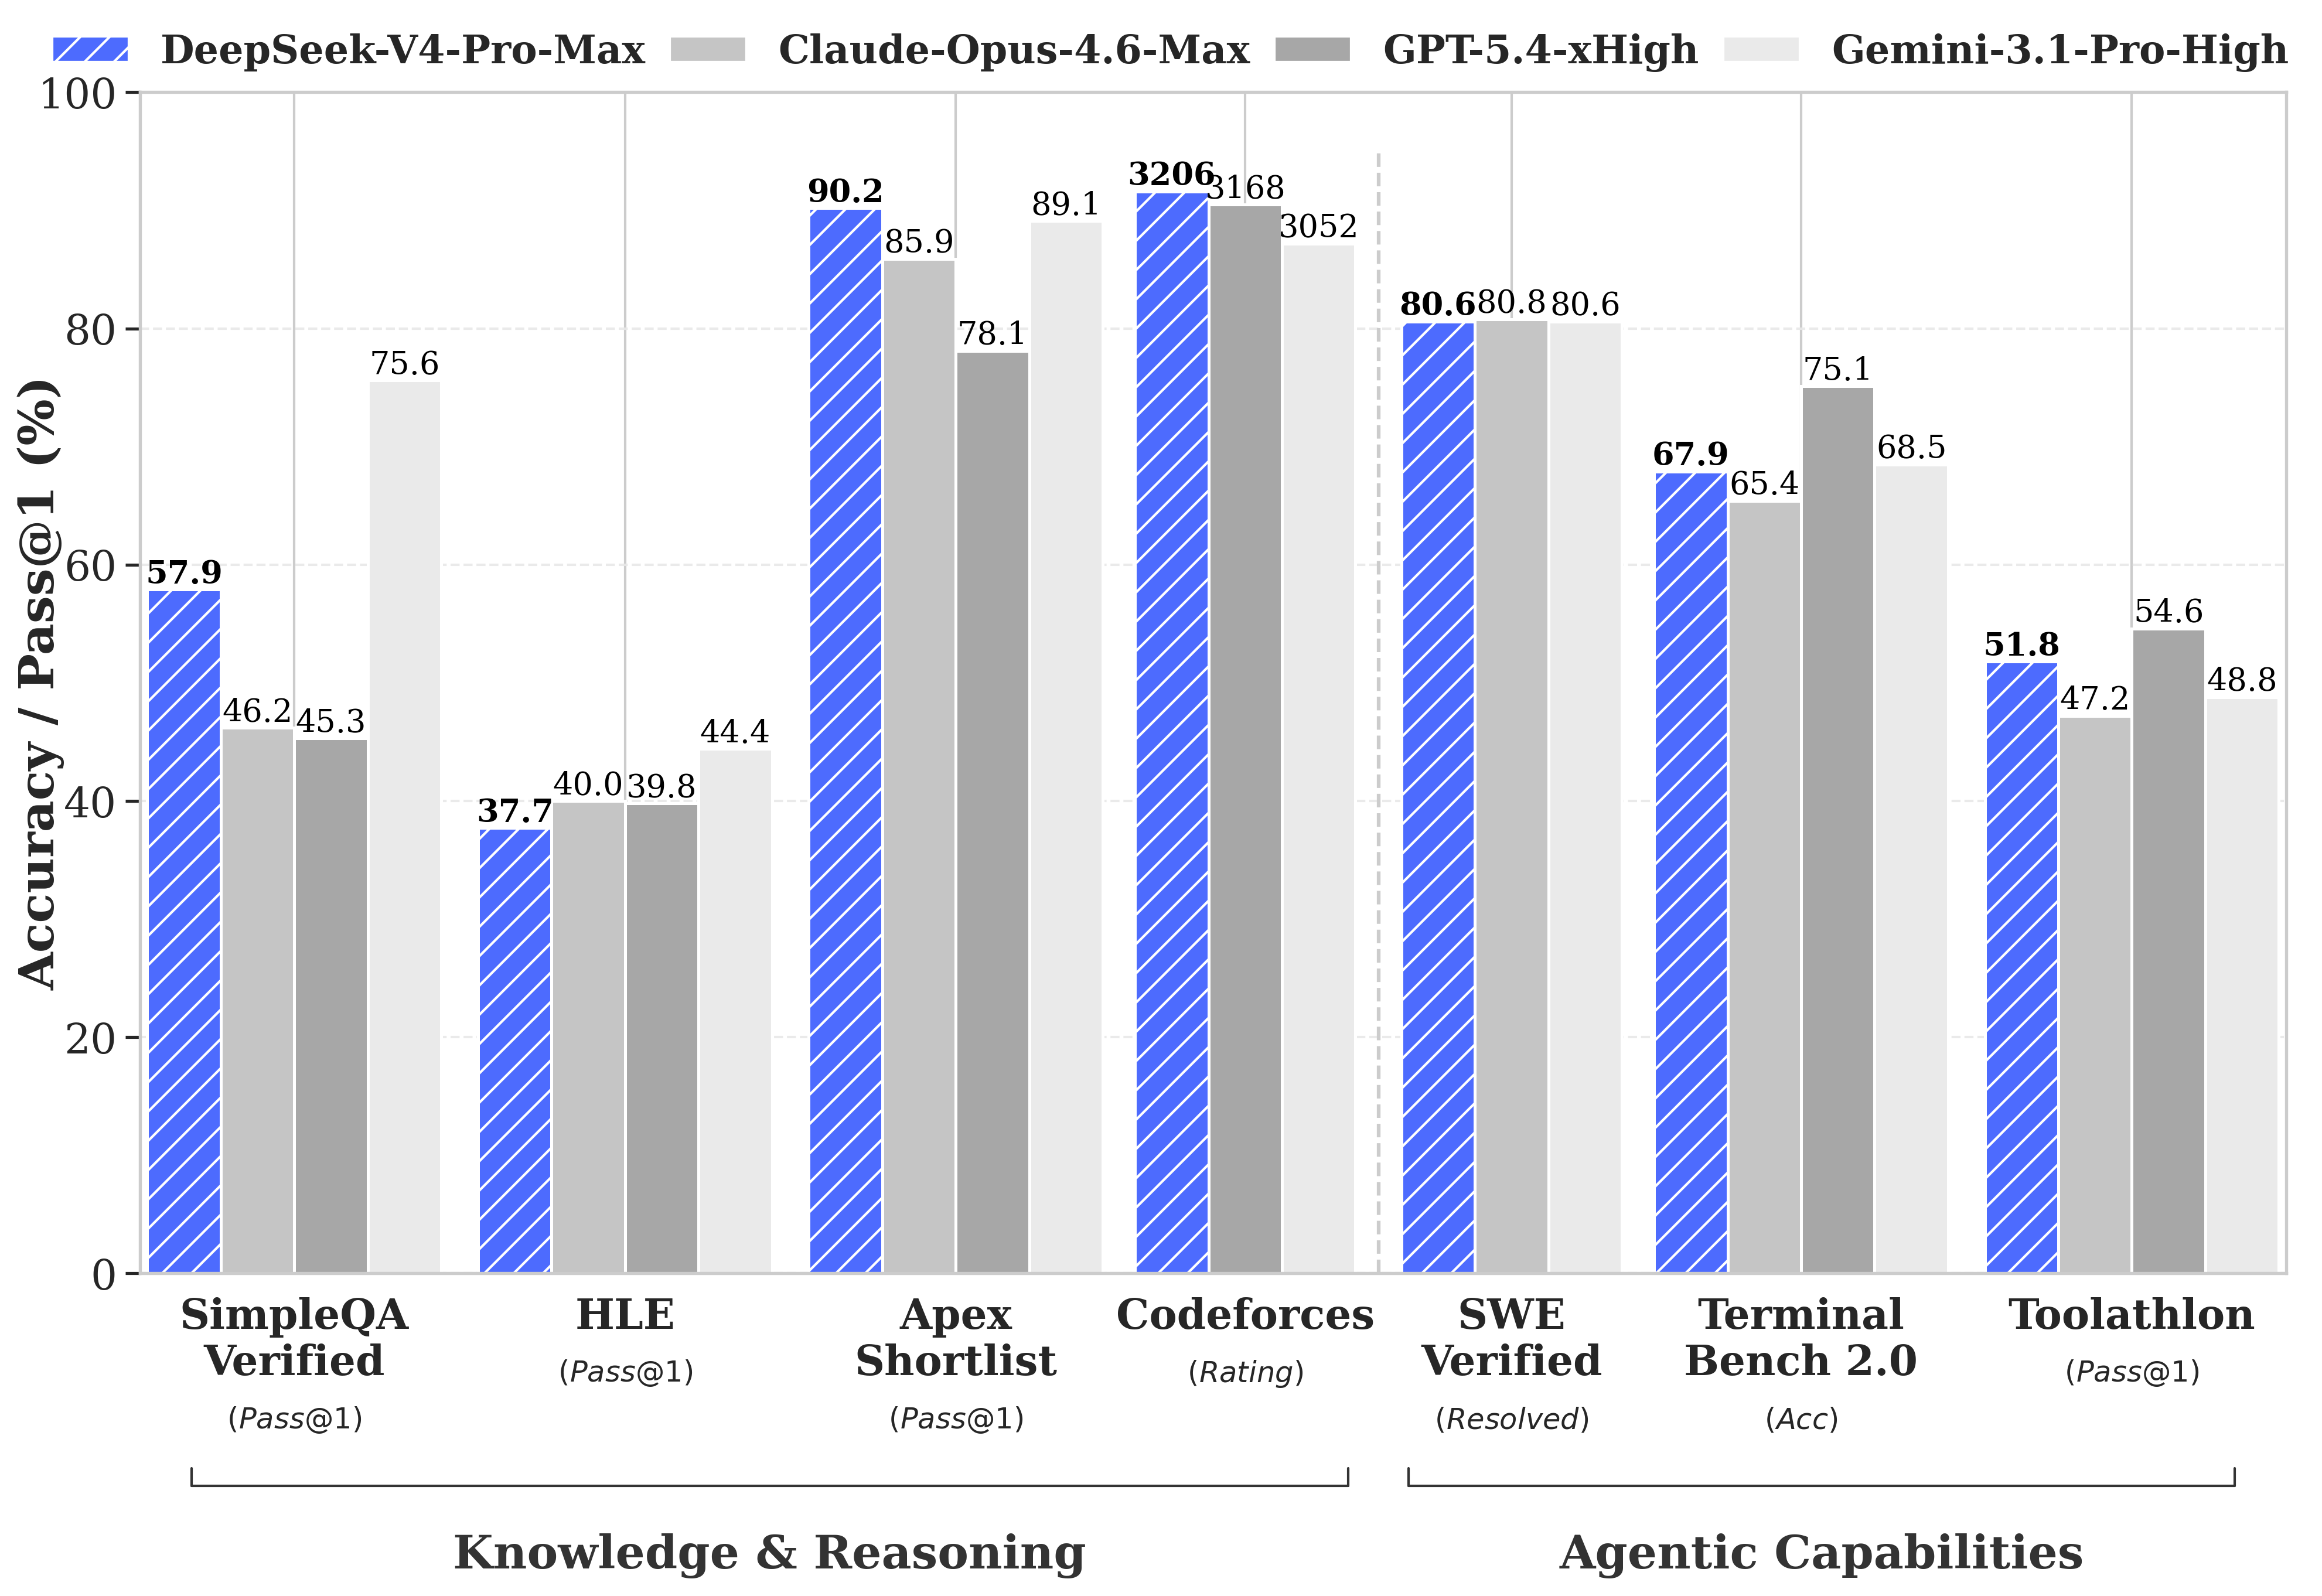
Diese Situation zeichnet sich als ein Faktor aus, der sich direkt auf den Wettbewerb mit großen Playern wie OpenAI und Google auf dem Markt auswirkt. Längerer Kontext, geringere Kosten und eine Kombination aus hoher Leistung machen DeepSeek zu einer starken Position im globalen Rennen um künstliche Intelligenz.
DeepSeek V4 API arbeitet mit OpenAI ChatCompletions und Anthropic kompatible Struktur. Benutzer haben nur den Modellnamen deepseek-v4-pro oder deepseek-v4-flash Es kann sich durch Veränderung in bestehende Systeme integrieren. Zuhause „Denkmodus und unterstützen verschiedene Argumentationsebenen wie "Nicht-Denken-Modus".
Neues Gleichgewicht im globalen Rennen um künstliche Intelligenz
Die Einführung von DeepSeek V4 ist nicht nur eine technische Entwicklung, sondern schafft auch einen neuen Gleichgewichtspunkt im globalen Wettbewerb der künstlichen Intelligenz. Die rasante Entwicklung in diesem Bereich der in China ansässigen Unternehmen wird immer wütender auf die in den USA ansässigen Technologiegiganten.
In diesem Zusammenhang erregt auch die Leistung von Modellen, die auf NVIDIA-Infrastrukturen entwickelt wurden, Aufmerksamkeit. Die Optimierung der Hard- und Software-Integration gehört zu den Faktoren, die für die Zukunft der KI eine entscheidende Rolle spielen.
Skalierung, Effizienz und Zukunftsperspektive
DeepSeek V4 gilt nicht nur als größere Modelle in der künstlichen Intelligenz; effizientere, skalierbarere und zugänglichere Systeme als Messenger einer neuen Ära. 1 Million Token Kontextkapazität, 1,6 Billionen Parameter und fortschrittliche Architekturoptimierungen; dieses Modell zeigt nur, dass dieses Modell die Standards der künstlichen Intelligenz in den kommenden Jahren prägen wird.
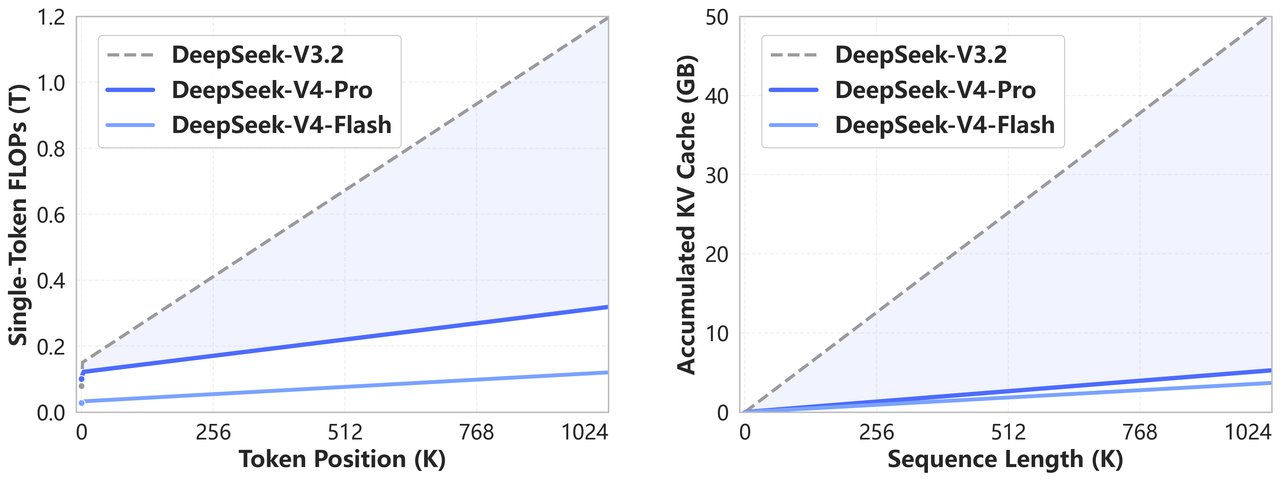
Diese Entwicklung zeigt nicht nur für Technologieunternehmen künstliche Intelligenz; sobald sie zu einer strategischen Infrastruktur für alle Sektoren wird. Zusammen mit DeepSeek V4 verlässt das Konzept des "größeren Modells" das "intelligentere und effizientere Modell".
DeepSeek V4, insbesondere im globalen KI-Rennen eine wichtige Bruchstelle auf der Open Source Seite schaffen. Die Veröffentlichung des Modells mit offenen Gewichten stärkt das Potenzial, ein alternatives Ökosystem zu geschlossenen Systemen zu schaffen.
JP Morgan Raporu: İnsansı Robotlarda Dönüm Noktası
Robotlara Beyin Geldi: Gemini Robotics-ER 1.6 ile Tanışın!


