Ein Fall gegen OpenAI und Microsoft: Great Hamle von der New York Times!
Automatisch übersetzt
 Creator
Hallo liebe Masqot Leser! Ich werde eine Nachricht aus der Technologiewelt treffen. Wir haben mit dieser Nachricht wieder einmal verstanden, dass wir die ethische Größe der künstlichen Intelligenz nicht vergessen sollten, wenn künstliche Intelligenz in den Hinrichtungen gefunden wird, die sich gegenseitig und die Menschheit erleichtern. Journalismus-Gigant Die New York Times (NYT) eröffnete einen bemerkenswerten Fall von führenden Unternehmen im Bereich der künstlichen Intelligenz zu OpenAI und Microsoft. Was steckt hinter dem Vorhang dieses Falls? Braut, lasst uns gemeinsam untersuchen.
Künstliche Intelligenz, Urheberrecht und das Recht einer Zeitung
Die New York Times behauptet, dass OpenAI und Microsoft NYT-Artikel verwenden, die nicht autorisiert durch Millionen von Urheberrechten geschützt sind, um künstliche Intelligenzmodelle zu trainieren. Dies ist eine eindeutige Verletzung der Rechte des geistigen Eigentums. Der auffälligste Punkt dabei ist, dass sich NYT in Common Crawl befindet, einem der größten proprietären Datensätze, die zum Trainieren von Modellen künstlicher Intelligenz verwendet werden.
ChatGPT und Urheberrechtsdiskussionen
ChatGPT und Copyright-Themen sind wirklich ein interessanter Diskussionsbereich. Dies ist komplexer, insbesondere in den Bereichen Informationsverarbeitung und künstliche Intelligenz. Der Fall der direkten Nutzung von Informationen aus Quellen wie der New York Times zeigt, wie wichtig dieses Thema ist.
Tatsächlich verwischt diese Situation die Grenze zwischen dem von künstlicher Intelligenz produzierten Inhalt und dem ursprünglichen Inhalt. Künstliche Intelligenz schafft neue Inhalte durch die Verarbeitung vorhandener Informationen. In diesem Prozess begegnen wir jedoch als ein wichtiges Fragezeichen, wie wir Originalwerke schützen und ihre Einzigartigkeit sicherstellen können. Welche Inhalte werden von künstlicher Intelligenz nach den urheberrechtlichen Regeln der darauf basierenden Ressourcen produziert? Dies ist ein Thema, das sowohl Legalisten als auch Technologieexperten berücksichtigen sollten.
Auf der Grundlage dieser Diskussion, wie sich künstliche Intelligenz an die Konzepte von Kreativität und Originalität anpasst. Künstliche Intelligenz verarbeitet Informationen durch Algorithmen und schafft neue Inhalte. Was sollte das Urheberrecht der in diesem Prozess produzierten Inhalte sein? Ist künstliche Intelligenz selbst, oder entwickeln sie künstliche Intelligenz? Oder sind die Eigentümer der zugrunde liegenden Ressourcen? Diese Fragen sind ein Hinweis darauf, wie Technologie in einer Welt, die schnell vermittelt, an das Gesetz angepasst werden sollte.
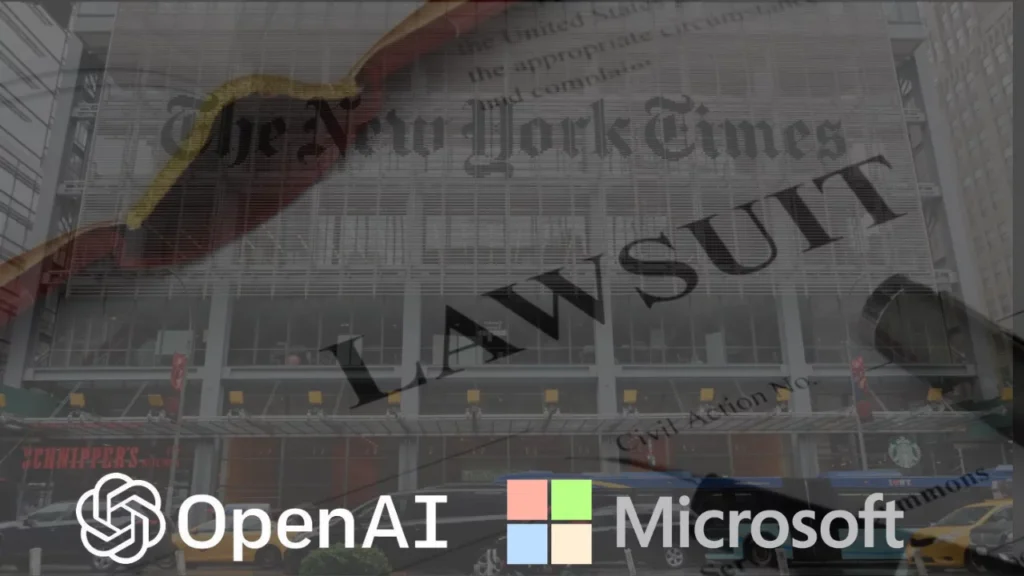
Ergebnisse und Auswirkungen des Sektors Künstliche Intelligenz
Dieser Fall könnte ein Bruchpunkt für die Industrie der künstlichen Intelligenz sein. Wenn die new york times den fall bekommt, können auch andere medienunternehmen eine entschädigung wegen der verwendung ihrer inhalte in der ki-schulung beantragen. Dies kann zu erheblichen Veränderungen in den Zugangs- und Nutzungsformen von Unternehmen mit Urheberrechten für künstliche Intelligenz führen und die Zukunft der künstlichen Intelligenz erheblich beeinflussen.
Kurz gesagt, interessante Entwicklungen werden in der Welt der Technologie und des Rechts erlebt. Privates AI Home Über die ethische Größe der roten Linien ist jetzt ausgeprägter. Dieser Fall kann die Grenzen und ethischen Regeln der künstlichen Intelligenz neu definieren. Hat die New York Times recht? Wie gestaltet man die Zukunft der künstlichen Intelligenz mit diesem Fall? Ich warte auf deine Kommentare!
CreatorEn İyi Yapay Zekâ Dil Öğrenme Uygulamaları: 8 Seçenek
Nvidia, İhracat Kısıtlamalarını Aşmak İçin RTX 4090'ı Piyasaya Sürdü