Zum Inhalt springen
Zurück zur Blogübersicht
Falcon-H1R 7B: Yeni Nesil LLM Yapay Zeka Modeli Sahnede
KI-Tools

Falcon-H1R 7B: Neue Generation des LLM-Modells für künstliche Intelligenz

Automatisch übersetzt
Can Kepenekoğlu
Can KepenekoğluAutor:in
4 Min. Lesezeit
Falcon-H1R 7B zielt auf hohe Genauigkeit in Bereichen wie Abstraktion, mehrstufige Intelligenzausführung und Unternehmensdatenanalyse ab. Das Modell kann dank seines optimierten Mechanismus mit einer geringeren Speicherkapazität arbeiten.

Während die Konkurrenz in Open-Source-Ökosystemen jeden Tag wütend ist, sticht das Falcon-H1R 7B-Modell als bemerkenswerte Alternative hervor. Dieses für lokale Installationen und Unternehmensanwendungen optimierte Modell hat 7 Milliarden Parameter.
FAlcon-H1R modeli veri analizi konusunda yeni bir gelisim hedefliyor.

Es konzentriert sich auf die einfache Installation von der Kapazitätsmenge in den letzten Perioden, Hardwareeigenschaften und realen Leistungen. Falcon-H1R 7B ist ein Modell, das auf diese Erwartungen reagiert. Es zielt auch auf hohe Genauigkeit in Bereichen wie Code-Typisierung, Abstraktion, mehrstufige Intelligenzausführung und Unternehmensdatenanalyse ab.

Technische Spezifikationen von Falcon-H1R 7B

AaUppercaseAufbauend auf transformatorbasierter Architektur. Die Textproduktion zielt auf eine hohe Genauigkeit bei Aufgaben wie Abstraktion, Frage-Cevap und Codeschreiben ab. Das Modell kann dank seines optimierten Mechanismus mit einer geringeren Speicherkapazität arbeiten.

Technische Spezifikationen;

  • 7 Mrd. Parameter
  • Verbesserte Aufmerksamkeitsoptimierung u
  • Kann mit niedrigem VRAM arbeiten
  • Struktur geeignet für lokale Inferenzleistung
  • Unterstützung bei der Feinsteuerung

Dank dieser Funktionen kann Falcon-H1R 7B sowohl einzelne Benutzer als auch kleine mittlere Unternehmen problemlos nutzen.

Wie installiere ich Falcon-H1R 7B?

Die Falcon-H1R 7B-Installation verfügt über eine überschaubare Struktur für Benutzer mit technischer Infrastruktur. Natürlich ist die richtige Konfiguration entscheidend für die Leistung.

  1. Hardware-Setup: Wenn auf dem Computer mindestens 16 GB Ram(bell) empfohlen werden, wird auf der Bildschirmkartenseite 8 GB Vram empfohlen. Sehen Sie diese Hardware jetzt Funktionen, die leicht auf durchschnittlichen Computern gefunden werden können.
  2. Installation der Umgebung: Phton sollte in Version 3.10 oder höher installiert werden. Dann sollte PyTorch oder ein ähnliches Framework installiert werden. Cuda-Kompatibilität sollte überprüft werden, wenn die Bildschirmkarte für Beschleunigung ist.
  3. Modell-Download: Solche Dateien können normalerweise von Open-Source-Plattformen wie Hugging Face bezogen werden. Dann wird es über die Bibliothek installiert.
  • Betrieb und Testen: Inferenz (wie astop-p,max-Token) Parameter werden optimiert und das Modell getestet. Für die Leistung ist es wichtig, die Vram-Nutzung zu überwachen.
  • Nach Abschluss der Installation funktioniert der Falcon-H1R 7B als lokales System, ohne dass eine Internetverbindung erforderlich ist.
    Falcıon-H1R ile LLMA3 arsında teknik karsilastirma ile farklar

    Falcon-H1R vs Llama 3: Leistungsvergleich

    KriterienAaUppercaseLlama3
    Parameternummer7 Milliarden8B, 70B (und höher Varianten)
    ArchitekturstrukturOptimierter TransformatorFortschrittlicher Transformator (Meta Optimierung)
    Hardwareanforderungen zu HauseMittlere GPU (8-12 GB VRAM genug)High Level GPU/Server für 8B, 70B
    Gedächtnisverbrauch zu HauseGeringere VRAM-AuslastungParameter erhöht hohe VRAM-Anforderung
    Lokale Installation Komfortzugänglicher und leichterKomplizierter für große Modelle
    Quantisierungsunterstützung4-Bit / 8-Bit funktioniert effizientUnterstützt aber verbraucht hohe Schweißen in großen Modellen
    RückschlussgeschwindigkeitNiedriger Radius, stabile LeistungHöhere Genauigkeit in großen Modellen, mehr Verarbeitungszeit
    FeinsteuerungskostenNiedrigere Hardwarekosten HomeKostensteigerungen in großen Varianten
    Edge Deployment TagsbequemerBegrenzt (außer kleine Varianten)
    UnternehmensnutzungIdeal für KMU und lokale DatenanalyseStark in großen Unternehmensprojekten
    Benchmark-LeistungAusgewogene und optimierte TagsHöhere Punktzahl in höheren Segmentvarianten

    LLM Künstliche Intelligenz Trends und Standort von Falcon-H1R u

    2026 Zuhause Drei Haupttrends im Bereich der künstlichen Intelligenz zeichnen sich ab: lokaler Modellbetrieb, Modelloptimierung und Corporate Customization. Wir können sagen, dass Falcom-H1R 7B eine besonders starke Position in zwei Titeln ist. Dank seiner leichten Architektur kann es problemlos auf einem Gerät arbeiten.

    Andererseits sind Hybridarchitekturen wie Hybird Transformer-Mamba für Modelle im Falcon-H1R 7B-Segment von entscheidender Bedeutung. Bei diesem Ansatz handelt es sich um eine Mischstruktur, die Mamba-basierte State Space (Durum Space)-Modelle mit dem Vorteil der Effizienz kombiniert. Daher zielt LLM darauf ab, die Leistungs- und Effizienzbalance im Bereich der künstlichen Intelligenz zu optimieren.

    Die Mamba-Architektur verarbeitet den Sequenzdatenfluss linear, d.h. die Komplexität der Ebenen. Dies führt zu einer erheblichen Leistungssteigerung bei Long-Context-Arrays. Die Eigenschaften der Hybird Transformer-Mamba-Architektur können gesagt werden, dass sich ein geringerer Speicherverbrauch auf hohe Effizienz, geringere Latenz und hardwarefreundliche Struktur bei langen Sekreten auswirkt. Natürlich gibt es szenarien, dass dieser ansatz keine kontextbezogene beziehungsmodellierung allein anbieten kann.
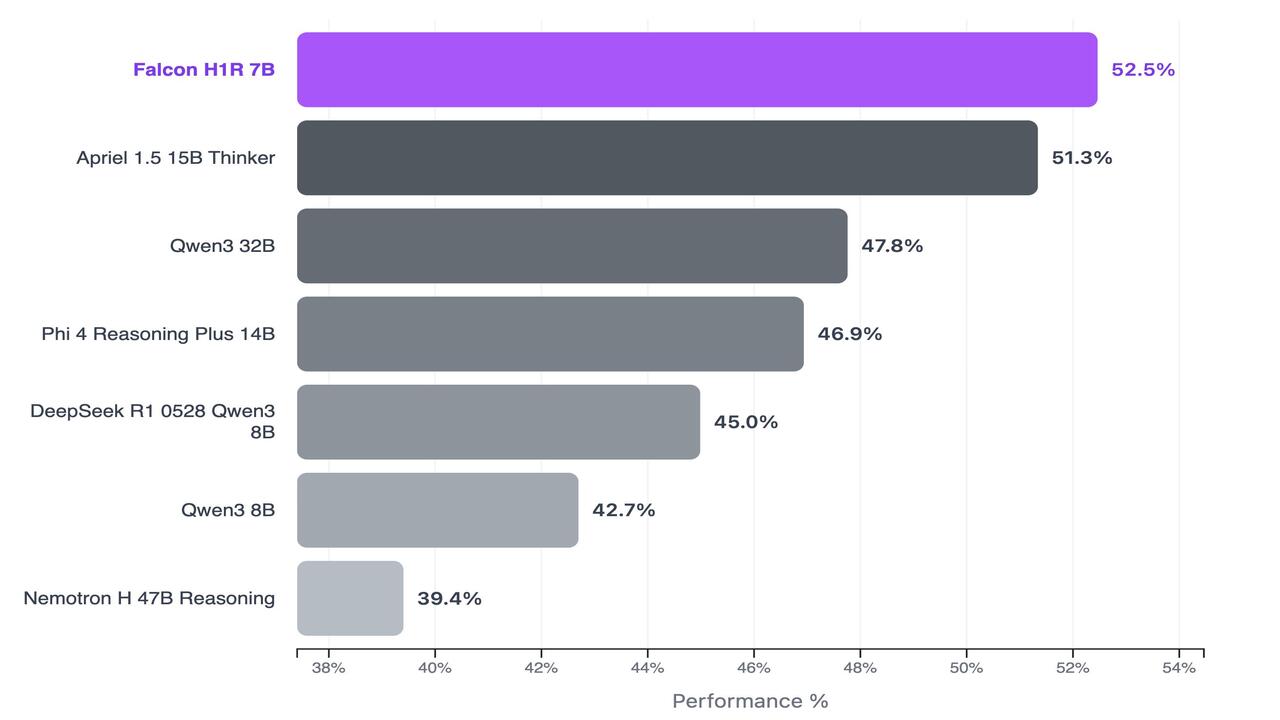
    Falcon-H1R 7B rakip analizi.

    Zukunftsperspektive: Effizienzorientierte LLM-Periode

    Nur die Parametergröße reicht im LLM-Rennen nicht aus. Im Jahr 2026 stehen auch Effizienz und Hardwareoptimierung am Anfang der Themen, die oben abgezogen werden. Falcon-H1R 7B ist als einer der Vertreter dieses Umbaus positioniert. Dieses Modell bietet nachhaltige LLM-Lösungen für Unternehmen und Cobies und kombiniert gleichzeitig hohe Leistung mit Hardwareeinsparung. In der kommenden Zeit wird LLM den Markt gestalten, indem es zugänglichere und anpassbarere Lösungen anbietet. Falcon-H1R macht als Mitglied des neuen Paradigmas auf sich aufmerksam.

    Während die Konkurrenz in Open-Source-Ökosystemen jeden Tag wütend ist, sticht das Falcon-H1R 7B-Modell als bemerkenswerte Alternative hervor. Dieses für lokale Installationen und Unternehmensanwendungen optimierte Modell hat 7 Milliarden Parameter. Es konzentriert sich auf die einfache Installation von der Kapazitätsmenge in den letzten Perioden, Hardwareeigenschaften und realen Leistungen. Falcon-H1R 7B ist ein Modell, das auf diese Erwartungen reagiert. Es zielt auch auf hohe Genauigkeit in Bereichen wie Code-Typisierung, Abstraktion, mehrstufige Intelligenzausführung und Unternehmensdatenanalyse ab. Technische Spezifikationen von Falcon-H1R 7B AaUppercase Aufbauend auf transformatorbasierter Architektur. Die Textproduktion zielt auf eine hohe Genauigkeit bei Aufgaben wie Abstraktion, Frage-Cevap und Codeschreiben ab. Das Modell kann dank seines optimierten Mechanismus mit einer geringeren Speicherkapazität arbeiten. Technische Spezifikationen; 7 Mrd. Parameter Verbesserte Aufmerksamkeitsoptimierung u Kann mit niedrigem VRAM arbeiten Struktur geeignet für lokale Inferenzleistung Unterstützung bei der Feinsteuerung Dank dieser Funktionen kann Falcon-H1R 7B sowohl einzelne Benutzer als auch kleine mittlere Unternehmen problemlos nutzen. Wie installiere ich Falcon-H1R 7B? Die Falcon-H1R 7B-Installation verfügt über eine überschaubare Struktur für Benutzer mit technischer Infrastruktur. Natürlich ist die richtige Konfiguration entscheidend für die Leistung. Hardware-Setup: Wenn auf dem Computer mindestens 16 GB Ram(bell) empfohlen werden, wird auf der Bildschirmkartenseite 8 GB Vram empfohlen. Sehen Sie diese Hardware jetzt Funktionen, die leicht auf durchschnittlichen Computern gefunden werden können. Installation der Umgebung: Phton sollte in Version 3.10 oder höher installiert werden. Dann sollte PyTorch oder ein ähnliches Framework installiert werden. Cuda-Kompatibilität sollte überprüft werden, wenn die Bildschirmkarte für Beschleunigung ist. Modell-Download: Solche Dateien können normalerweise von Open-Source-Plattformen wie Hugging Face bezogen werden. Dann wird es über die Bibliothek installiert. Betrieb und Testen: Inferenz (wie astop-p,max-Token) Parameter werden optimiert und das Modell getestet. Für die Leistung ist es wichtig, die Vram-Nutzung zu überwachen. Nach Abschluss der Installation funktioniert der Falcon-H1R 7B als lokales System, ohne dass eine Internetverbindung erforderlich ist. Falcon-H1R vs Llama 3: Leistungsvergleich Kriterien AaUppercase Llama3 Parameternummer 7 Milliarden 8B, 70B (und höher Varianten) Architekturstruktur Optimierter Transformator Fortschrittlicher Transformator (Meta Optimierung) Hardwareanforderungen zu Hause Mittlere GPU (8-12 GB VRAM genug) High Level GPU/Server für 8B, 70B Gedächtnisverbrauch zu Hause Geringere VRAM-Auslastung Parameter erhöht hohe VRAM-Anforderung Lokale Installation Komfort zugänglicher und leichter Komplizierter für große Modelle Quantisierungsunterstützung 4-Bit / 8-Bit funktioniert effizient Unterstützt aber verbraucht hohe Schweißen in großen Modellen Rückschlussgeschwindigkeit Niedriger Radius, stabile Leistung Höhere Genauigkeit in großen Modellen, mehr Verarbeitungszeit Feinsteuerungskosten Niedrigere Hardwarekosten Home Kostensteigerungen in großen Varianten Edge Deployment Tags bequemer Begrenzt (außer kleine Varianten) Unternehmensnutzung Ideal für KMU und lokale Datenanalyse Stark in großen Unternehmensprojekten Benchmark-Leistung Ausgewogene und optimierte Tags Höhere Punktzahl in höheren Segmentvarianten LLM Künstliche Intelligenz Trends und Standort von Falcon-H1R u 2026 Zuhause Drei Haupttrends im Bereich der künstlichen Intelligenz zeichnen sich ab: lokaler Modellbetrieb, Modelloptimierung und Corporate Customization. Wir können sagen, dass Falcom-H1R 7B eine besonders starke Position in zwei Titeln ist. Dank seiner leichten Architektur kann es problemlos auf einem Gerät arbeiten. Andererseits sind Hybridarchitekturen wie Hybird Transformer-Mamba für Modelle im Falcon-H1R 7B-Segment von entscheidender Bedeutung. Bei diesem Ansatz handelt es sich um eine Mischstruktur, die Mamba-basierte State Space (Durum Space)-Modelle mit dem Vorteil der Effizienz kombiniert. Daher zielt LLM darauf ab, die Leistungs- und Effizienzbalance im Bereich der künstlichen Intelligenz zu optimieren. Die Mamba-Architektur verarbeitet den Sequenzdatenfluss linear, d.h. die Komplexität der Ebenen. Dies führt zu einer erheblichen Leistungssteigerung bei Long-Context-Arrays. Die Eigenschaften der Hybird Transformer-Mamba-Architektur können gesagt werden, dass sich ein geringerer Speicherverbrauch auf hohe Effizienz, geringere Latenz und hardwarefreundliche Struktur bei langen Sekreten auswirkt. Natürlich gibt es szenarien, dass dieser ansatz keine kontextbezogene beziehungsmodellierung allein anbieten kann. Zukunftsperspektive: Effizienzorientierte LLM-Periode Nur die Parametergröße reicht im LLM-Rennen nicht aus. Im Jahr 2026 stehen auch Effizienz und

    Etiketler:Falcon-H1R 7BLLM yapay zekaFalcon-H1R vs Llama 3
    Can Kepenekoğlu
    Can KepenekoğluAutor:in
    @CanKepenekoglu

    Kommentare (0)

    Melde dich an, um zu kommentieren.

    Anmelden
    Noch keine Kommentare. Schreib den ersten!