Gemini 2.5 API Support Bites: 1. Dezember Pass Guide
Automatisch übersetzt
 Autor:in
In der Entwicklung des Ökosystems der künstlichen Intelligenz verlassen die Architekturen, die gestern akzeptiert wurden, ihren Platz heute in Modellen neuer Generationen mit einer viel agileren und tieferen Denkfähigkeit. Google, Gemini 2.5 Pro und Gemini 2.5 Durch die Einführung eines neuen Routing-Prozesses für Flash-Modelle bereiten sich die Entwickler auf den Wechsel zur Gemini 3-Serie vor.
Dieser Prozess wird jedoch nur eine große Illusion sein, um als gewöhnliche Version veda zu lesen. Da Google ein ruhiger und automatischer Routing-Mechanismus im Hintergrund ist, anstatt die alten Endpunkte am 1. Dezembermorgen vollständig zu schließen und Fehler an Systeme zurückzugeben. Dies bedeutet leise Logikfehler, unerwartete Kostenänderungen und Parameterinkompatibilität für Entwickler, die nicht die notwendigen Anpassungen in der Codebasis vornehmen, wenn sie auf den ersten Blick wie ein nahtloses Erlebnis aussehen.
Google Gemini 2.5
Die Entwicklung von Technologien der künstlichen Intelligenz beschränkt sich nicht nur auf die Entstehung neuer Modelle. Technologieunternehmen entwickeln die Fähigkeiten ihrer Modelle auf der einen Seite, während sie auf der anderen Seite allmählich aus dem Verkehr ziehen. Google Gemini Die endgültige Entscheidung für 2,5 Modelle ist eines der Beispiele, die auf diesen Umbau aufmerksam machen.
Google tarafından yayımlanan resmi duyuruya göre Gemini 2.5 Pro ve Gemini 2.5 Flash modelleri kullanımdan kaldırılma sürecine girdi. 1 Aralık 2026 tarihinden itibaren bu modellere gönderilen API istekleri farklı modellere yönlendirilecek. Buna göre Gemini 2.5 Pro istekleri Gemini 3.8 Flash, Gemini 2.5 Flash istekleri ise Gemini 3.5 Flash-Lite üzerinden yanıtlanacak.
Aktuelle Modell-ID |
1 Range 2026 Modell nach Reputation gerichtet werden
Neue Preise und Status
gemini-2.5-pro
gemini-3.8-flash
Gemini 3.8 Flash Tarif wird angewendet
gemini-2.5-flash
gemini-3.5-flash-lite
Gemini 3.5 Flash-Lite Tarif wird angewendet
gemini-2.5-flash-lite
Keine Änderung (nicht erfolgt)
Aktiv in der für eine zweite Ankündigung verfügbaren Form
Hier müssen Sie darauf achten, API wird nicht vollständig gestoppt werden. Google leitet Anfragen von bestehenden Modell-IDs auf neue Modelle um. Aber die Änderung des Modells, das im Hintergrund funktioniert, bedeutet nicht, dass die Entwickler weiterhin auf die gleiche Weise arbeiten werden.
Wie wirkt sich das Gemini API Update auf Benutzer aus?
Diese Änderung in Bezug auf Entwickler, die Gemini 2.5-Modelle verwenden, ist nicht nur eine Versionserneuerung. Denn jedes Modell der künstlichen Intelligenz hat einzigartige Parameter, Antwortformulare und technische Anforderungen.
Insbesondere Entwickler, die bestimmte Modelleinstellungen in bestehenden Anwendungen verwenden, müssen die Arbeitsprinzipien neuer Versionen überprüfen. Selbst wenn API-Anfragen weiterhin Antworten erzeugen, können in einigen Funktionen von Anwendungen Fehler auftreten.
Die Modellabgleiche von Google sind:
Gemini 2.5 Pro → Gemini 3.8 Blitz: Das Pro-Modell, das für erweiterte Aufgaben und komplexe Operationen verwendet wird, wird ersetzt.
Gemini 2.5 Flash → Gemini 3.5 Flash-Lite: Es wird das neue Modell für schnellere und wirtschaftlichere Verarbeitungsanforderungen sein.
Auf der anderen Seite hat das Gemini 2.5 Flash-Lite keine Opt-Out-Entscheidung für das gleiche Datum. Es stimmt also nicht, dass alle Modelle in Gemini 2.5 gleichzeitig deaktiviert werden.
Gemini 3.8 Flash Pass Guide: Was machen Entwickler?
Das wichtigste Thema im Übergangsprozess neuer Modelle ist die technische Bewertung bestehender Systeme. Durch die Vorbereitung der Modelländerung von Anwendungen, die über die Gemini-API ausgeführt werden, können mögliche Unterbrechungen und unerwartete Ergebnisse verhindert werden.
1. Kontrolle bestehender API-Integrationen
In den ersten Anwendungscodes, Konfigurationsdateien und verwendeten Software-Tools sollten Gemini 2.5 Pro- und Flash-Modelle bestimmt werden, wo sich ihre Identität befindet. So können alle Integrationen, die aktualisiert werden müssen, erkannt werden.
2. 2. Überprüfung der Parameter neuer Modelle
Bei der Gemini 3-Serie gibt es Änderungen in einigen technischen Parametern. Zum Beispiel in alten Modellen verwendet thinking_budget Lage der Einstellung thinking_level Empfangsparameter. Außerdem werden einige Auswahl- und Antwortkonfigurationsoptionen in neuen Modellen nicht unterstützt.
Daher kann es nicht nur ausreichen, den Modellnamen zu ändern. Das neue Modell der Anwendungen muss auf die technischen Anforderungen zugeschnitten werden.
3. Prüfung und Leistungsbewertung
Bevor Sie mit dem neuen Modell fortfahren, sollte die Leistung der Anwendung in verschiedenen Szenarien getestet werden. Genauigkeit, Bearbeitungszeiten, Fahrzeuganrufe und Tokenverbrauch der Antworten sollten verglichen werden. Somit kann der Effekt der Modelländerung auf die Gesamtleistung der Anwendung als gesünder angesehen werden.
4. Kostenberechnung überprüfen
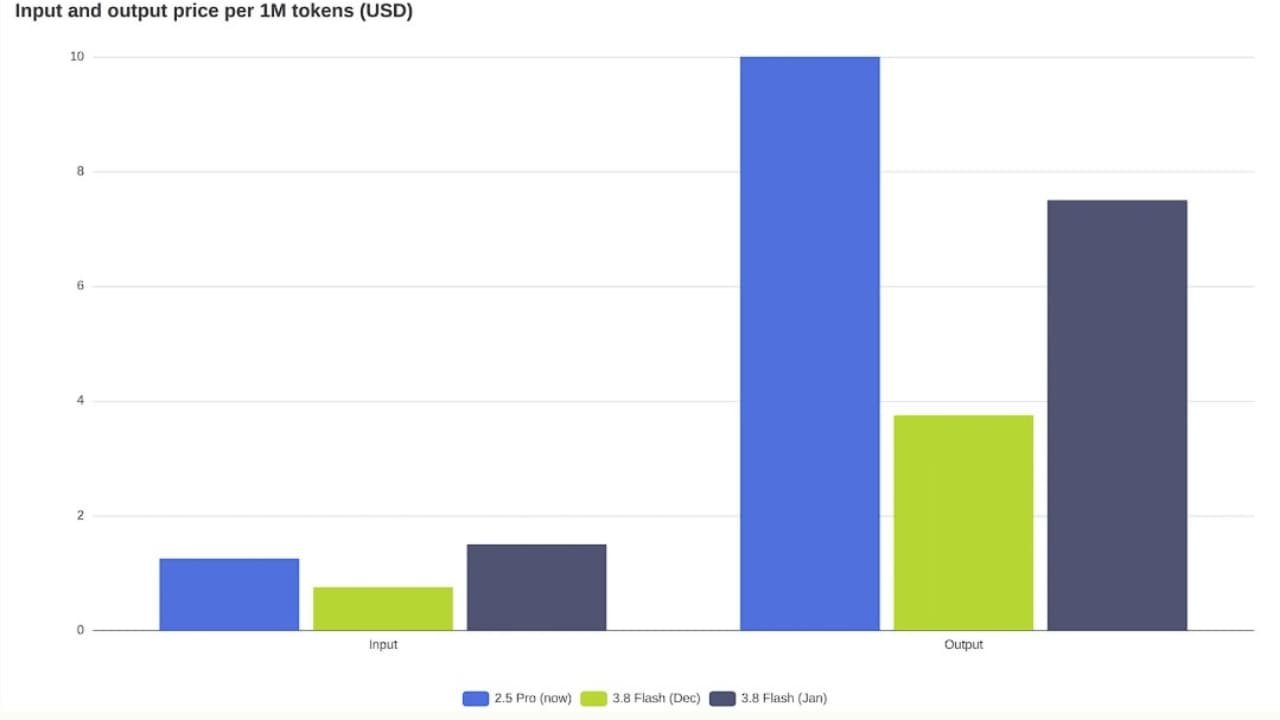
Modelländerung, API Nutzung kann auch die Kosten beeinflussen. Da neue Modelle die Preispolitik und den Token-Verbrauch variieren können, ist es wichtig, dass Entwickler bestehende Budgets neu berechnen.
Gleicher Name, anderes Verhalten: Warum kann Ihr Code stören?
Die Gemini 3.x-Familie wendet keine Regeln an, die 2.5 akzeptiert hat. Deshalb kann eine Anwendung, die den Modellnamen überhaupt nicht ändert, nach dem 1. Dezember sogar Fehler verursachen oder unterschiedliche Ergebnisse erzielen, so wie sie nicht bemerkt wird.
Thinking Setting: Vom Budget zum Level
Zuhause thinking_budget Lage des Gebiets thinking_level Nehmen. 3.8 Flash lowTags medium und high Akzeptwerte, minimal lehnt seinen Wert ab. 3.5 Flash-Lite standardmäßig minimal arbeitet mit. Das Senden von zwei Bereichen zusammen bringt HTTP 400 Fehler. Niedrig genug für einfache Aufgaben wie Datenextraktion und -klassifizierung; für Agenten, die mehrstufige Intelligenz durchführen möchten medium oder high sicherer.
Sampling und Vergangenheit Management Home
temperatureTags top_p und top_k Gemini 3. x zählt. Fehler werden in den nächsten Generationen erwartet. candidate_count nicht unterstützt. Das "Preing" fordert, dass in der letzten Runde Modellrolle enden oder das erste Wort der Antwort auf die HTTP 400 Rückkehr schreiben. Stattdessen Systemanweisung und strukturierte Ausgabeempfehlungen.
Fahrzeuganrufe und Gedankensignatur
Die Verifizierung wird in Funktionsaufrufen verschärft: thought_signature Das Gebiet wird kontrolliert und jeder FunctionResponse Das Objekt sollte die übereinstimmende Anruf-ID und den entsprechenden Namen verschoben werden. Das Löschen der Signatur kann zu leeren Antworten anstelle eines sauberen Fehlers führen. Deshalb ist es nicht nur eine Ausnahme in Tests, es ist notwendig, den rotierenden Text selbst zu betrachten.
Pass Guide: Welches Modell lädt die Arbeit?
Jeder Pass geht nicht in die gleiche Richtung. Zunächst ist es notwendig, sich das Modell anzusehen. Es ist ein sanfter Optimismus, wenn ein Flash-Modell die Basis des alten Pro-Modells bei jeder Aufgabe schützt; der Test ist nicht sanft, direkt.
Arbeitsbelastung | Empfohlenes Ziel | Menü |
|---|---|---|
Allgemeine Anfragen, Codierung, lange Dokumente | 3.8 Flash, | Qualität und Januar-Preis sollten erneut gemessen werden |
Fahrzeugträger | 3.8 Flash, | Thought Signatur, Call IDs, Early Stop |
Klassifizierung, Datenextraktion, Routing | 3.5 Flash-Lite, | Der wirtschaftlichste Weg; Upgrade des Niveaus, wenn das Fahrzeug hinzugefügt wird |
Sprachtranskription u
3.5 Flash-Lite
Sound-Input ist billig, überprüfen Sie Cache-Stifte Home
Effizienz und Kostenbalance in der Künstlichen Intelligenz
Im Entwicklungsprozess von Modellen der künstlichen Intelligenz reicht es nun aus, nur noch eine höhere Leistung zu erzielen. Technologieunternehmen versuchen, leistungsstarke Intelligenzfunktionen mit niedrigeren Handelskosten und kürzeren Reaktionszeiten zu kombinieren. Dieser Modellpass von Google unter Gemini API kann ebenfalls als Spiegelung dieses Ansatzes bewertet werden.
Speziell Flash und Flash-Lite Das Führen von Modellen zu verschiedenen Nutzungsszenarien erhöht die Bedeutung der Modellauswahl, die für die Bedürfnisse der Entwickler geeignet ist. Anstatt für jede Transaktion das fortschrittlichste Modell zu verwenden, ist es möglich, verschiedene Modelle entsprechend der Komplexität der Aufgabe zu nutzen und die Ressourcennutzungs- und Anwendungskosten effizienter zu verwalten.
Modelländerungen sind aber auch für die Kontinuität der Qualitätskontrolle in auf künstlicher Intelligenz basierenden Systemen erforderlich. Verschiedene Modelle desselben Befehls können unterschiedliche Antworten erzeugen, insbesondere zu unerwarteten Ergebnissen in den Bereichen Kundenservice, Inhaltsproduktion, Datenanalyse und Automatisierung. Daher müssen sich die Entwickler nicht nur auf die technische Kompatibilität konzentrieren, sondern auch auf die Konsistenz der erzielten Ergebnisse.
GoogleDieser Schritt zeigt einen der grundlegenden Trends einer neuen Ära in der Welt der künstlichen Intelligenz. Der Wettbewerb wird in Zukunft nicht nur so gestaltet sein, dass er das leistungsstärkste Modell entwickelt, sondern das richtige Modell auf die effizienteste Weise einsetzt.
Autor:in