Gemini Use Limit: Gibt es ein Fragelimit?
Automatisch übersetzt
 Autor:in
Google hat einen Schritt getan, indem es die Konsumgewohnheiten verwurzelt hat, die wir seit langem in der Welt der künstlichen Intelligenz gewohnt sind. In Gemini schloss der feste Quotenzeitraum in Form von "die Frage ist so viel wie möglich". Google gab offiziell bekannt, dass Gemini bei der I/O-Veranstaltung im Jahr 1905.2026 in das Quotensystem auf der Grundlage der Transaktionsleistung übergegangen ist. Dieser Schritt, der auf den ersten Blick wie ein kleines Textupdate auf der Benutzeroberfläche steht, deutet tatsächlich auf einen riesigen Architektur- und Geschäftsmodellwechsel im Hintergrund hin. Jede Aufforderung, die wir jetzt geworfen haben, wird nicht gleich dem Pool sein. Wenn Sie den Fehler einer einfachen Funktion von fünf Zeilen finden, werden Tausende von Token nicht im selben Tiegel schmelzen, um eine ganzheitliche Repository-Analyse zu erhalten. Insbesondere diese Änderung für Softwareer, die zum Hauptpartner von Gemini in Produktionsprozessen werden, ist gezwungen, Workflow-Designs von Anfang an zu optimieren.
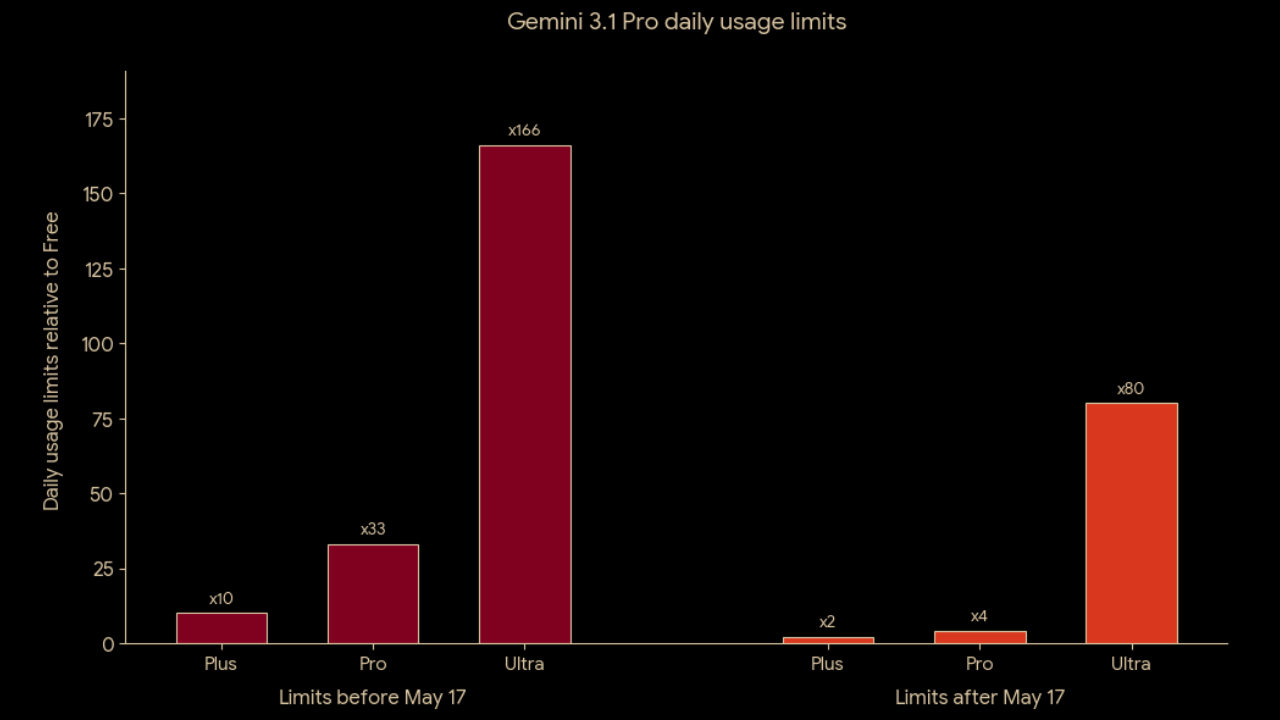
Kurze Antwort (13.10.2026 by): In Gemini gibt es kein festes "die Frage so weit wie möglich" Limit, aber es gibt ein Limit für die Verwendung. Das Limit gemäß Google wird durch die Komplexität der Eingabeaufforderung, die von Ihnen verwendeten Eigenschaften und die Länge des Chats berechnet. Das Limit wird alle 5 Stunden erneuert und hat eine wöchentliche Obergrenze. Google AI Plus bietet 2 Schichten, AI Pro 4 Schichten, AI Ultra ist 5 oder 20 mal höhere Grenzwerte als Pro.
Wenn Sie sich fragen, welcher Plan für Sie genug ist und die Preise der Türkei Gemini bezahlt? Kostenlose Version und alle Pläne Siehe unseren Artikel.
Cloud Computing Manik von Chatbot Experience: Was macht Gemini Veränderung?
Als Werkzeuge der künstlichen Intelligenz zum ersten Mal üblich wurden, bestand das System aus einem einfachen Frage-Cevap-Mechanismus. Der Benutzer gibt eine Eingabe, das Modell produzierte eine direkte Ausgabe. Dieser lineare Fluss ähnelte der Preisgestaltung der traditionellen Serveranforderungen von Cloud-Anbietern. Heute sind LLMs jedoch nicht mehr nur die Algorithmen, die Wörter vorhersagen. Model denkt dahinter, plant, testet seinen eigenen Code und schrittweise Logik.
Das neue System, an dem Google arbeitet, ist, die traditionelle Chatbot-Logik an dieser Stelle zu töten und stattdessen sind wir mit AWS, Google Cloud oder Azure vertraut pure Processing Power Oriented Pricing/Cota Architektur Home bringt. Wenn Sie CPU, GPU und RAM auf einem Server verbrauchen, wird die Cloud-Computing-Logik, mit der Sie die Rechnung bezahlen, nun auf unsere Eingabeaufforderungen auf der Gemini-Schnittstelle angewendet. Was wir stapeln, ist nicht mehr "die Anzahl der Zahlen", sondern die Sekunden und Handelszyklen, die für Chips in Google-Rechenzentren ausgegeben werden.
Was sagt Android Police? Ende des Daily Query Manik
Änderung angekündigt auf Google I / O 2026; Android Police hat auch Details im 20.05.2026 übertragen. Google entfernt nach und nach die Logik der "Remaining Requests" (Calan Requests), die in der Benutzeroberfläche enthalten ist und die verbleibenden Rechte symbolisiert. Stattdessen wird das System dynamisch nach dem Gewicht der Transaktionen des Benutzers aktualisiert und bringt einen neuen Tracking-Mechanismus, der auf einem komplexen Rechenobjektiv im Hintergrund basiert.
Schließung des Zeitraums "Remaining Requests" im Developer Workflow
Bei der Entwicklung der Software kennt der Editor durch Integrationen oder Web-Schnittstellen kontinuierlich gute Lautsprecher mit Gemini; Es ist wichtig, dass die Geschäftsplanung weiß, wie viele Rechte am Tag verbleiben. Im alten System können Sie sagen "Ich habe mehr 20 Nachrichten, ich bin bereit, bequem zu beenden", bevor Sie einen kritischen Refaktorprozess eingeben. Diese Vorhersagbarkeit wird jedoch in der neuen Struktur eliminiert, in der Android Police erscheint. Eine einzige schwere Aufforderung kann Ihren gesamten Handelspool im Hintergrund trocknen. Diese Situation macht das tägliche Ressourcenmanagement besonders für unabhängige Entwickler und Agenturen, die stark arbeiten.
Was sagt Compute Based AI genau? Warum nicht gleich?
"Compute Based AI", das als ausgefallenes Wort der Marketingabteilungen steht, basiert vollständig auf der Hardware-Realität auf der technischen Seite. Die Kosten einer Aufforderung, die Sie in diesem System übersprungen haben, und der Betrag, den Sie von Ihrer Jeans nehmen. Wie viel die GPUs, die hinter Ihrer Nutzung arbeiten, berechnet werden.
Drei grundlegende Variablen, die den direkten Compute Consumption beeinflussen
Prompte Komplexität: Mit einer einfachen Frage "Wie meine ich das Element in CSS?" wiegt der Befehl "Das Deadlock-Problem in der Microservice-Architektur analysieren" nicht in der gleichen Brust. Der zweite Befehl löst die vielschichtigen Denknetzwerke des Modells aus und verbringt mehr Inferenzstärke.
Kontextlänge: Das riesige Kontextfenster mit dem größten Muskel von Gemini ist zum größten Kostenstift geworden. Jede protokolldatei, die sie erwartet haben, die dokumentationsseite oder der codeblock, bewirkt, dass der aufmerksamkeitsmechanismus mehr als quadratisch berechnet.
Denkmodus und mentale Ausführungszeit: Bevor Sie das Modell beantworten, bedeutet dies, dass Sie die "Fall" -Phase durchlaufen, Hunderte von unsichtbaren Token im Hintergrund erzeugen und in selbstkorrekte Zyklen eintreten. Der Benutzer sieht nur eine einzige Ausgabe, fügt jedoch die Leistung von Strom und Prozessor hinzu, die im Hintergrund ausgegeben werden.
Kostenlastversorgung von Argumentationsmodellen
Googles Entscheidung ist nicht überraschend, dass Modelle, die Sinn machen. OpenAIs O-Serien-Modelle in der gesamten Branche, Claude Sonnet Argumentation Updates auf der anthropischen Seite, die Richtung der künstlichen Intelligenz ist vollständig im "Mischen" Bein aufgezeichnet. Diese Situation bringt jedoch schreckliche Hardware- und Energiekosten für Technologiegiganten.
Schiff 3.1 Pro hat 1 million token kontextfenster wie pro, ein modell, das komplexe codeblöcke gründlich recherchieren und analysieren kann, ist ein wirtschaftliches intihardi, um mit der logik des alten usul "fixed 50 nachrichten am tag" zu präsentieren. Weil ein benutzer in der lage war, alle repository-modelle hochzuladen und riesige analysen für 50-mal zu erstellen, während er diese 50 nur durch chatten konsumierte. Da der Kostenunterschied zwischen Tausenden von Malen gefunden werden kann, musste Google zum computerbasierten Modell gehen, um seine Fair-Use-Jeans an die Basis zu bringen.
Was erwarten Google AI Pro Abonnenten und Entwickler?
Mit der Zahlung der monatlichen Gebühr warten Benutzer mit Google AI Pro auf einen kleinen nebligen Prozess in der kommenden Zeit. Google öffnet keine bestimmte Anzahl von Fragen oder Recheneinheiten; nur 4 Mal nach dem kostenlosen Plan von Pro, sagt Ultras Pro bietet 5 oder 20 Mal Limit und das Limit wird in 5 Stunden erneuert. Laut User Experience fallen folgende Szenarien auf:
Teams, die sich intensiv mit Codeanalysen beschäftigen und große Projekte zu Gemini auf architektonischer Ebene untersuchen, kommen viel früher an ihre täglichen Grenzen. Im Gegenzug können Benutzer, die innerhalb des Tages einfache Skripte oder abstrakte Texte schreiben, das System verwenden, möglicherweise ohne Einschränkungen. Das Modell wird die Lichtarbeiter länger im System halten, während das Recht schnell von schweren Aufgaben gesammelt wird.
Wie können wir unseren Prompt Engineering Ansatz ändern? Token und Compute Optimierung
Die lange prompte Zeit schließt offiziell mit dem Komfort von "Howless unlimited" oder "How do I have 100 right per day". Diese neue Periode wird sich direkt auf den schnellen Engineering-Ansatz von Softwareern auswirken. Die "Tokenfarm"- und Kostensenkungstaktik, die wir auf der alten API-Seite gemacht haben, wird nun auf die Gemini App-Schnittstelle im Browser verschoben.
In der neuen Ära der Entwickler muss Gemini diese Praxis zur Gewohnheit machen:
Modular Prompting: Anstatt das gesamte Projekt auf einmal zu starten, füttern Sie nur verwandte Module oder Funktionsblöcke, an denen gearbeitet wird.
Kontextreinigung: Bereinigung alter code-ausgaben, die im chat-verlauf verbleiben und nicht mehr mit der vorhandenen aufgabe zu tun haben, wodurch verhindert wird, dass das modell diese riesige geschichte jedes mal wieder liest.
Richtiges Modell für genaue Pflicht: Einfache Regex-Typisierung bedeutet, den Denkmodus für einfache Fehlererfassungen zu schließen oder leichtere Modelle zu bevorzugen; tiefe Architekturentwürfe laufen nur bei Bedarf im Pro-Denken-Modus.
Diskussionen zu "Free Kota" in Reddit und Entwicklerforen
Vor der offiziellen Ankündigung äußerten einige Benutzer die Grenzen in Foren, in denen sie schneller gefüllt wurden. Vor allem in Reddits r/LocalLLM, r/Bard und verschiedenen Softwareern subbreddits Die letzten Monate waren "Obwohl ich heute keine Reihe von Aufforderungen gegeben habe, war das Limit über 2 Stunden?" die Header wurden geöffnet.
Entwickler bemerkten, dass sich das System viel aggressiver blockiert, wenn es speziell auf großen Codebasen arbeitet. Dies war der größte Beweis dafür, dass das rechenbasierte KI-Modell von Google vor der Produktion tatsächlich leise in einer Wohnumgebung getestet wurde. Die größte Kritik an der Community ist hier der Mangel an Transparenz. Softwareentwickler wollen sehen, wie viele "Compute Unit" in ihren Panels gerechtfertigt sind, was dazu führt, wie viel der Pool verbraucht.
Gemini API und Gemini App Limit ist Line Accessed?
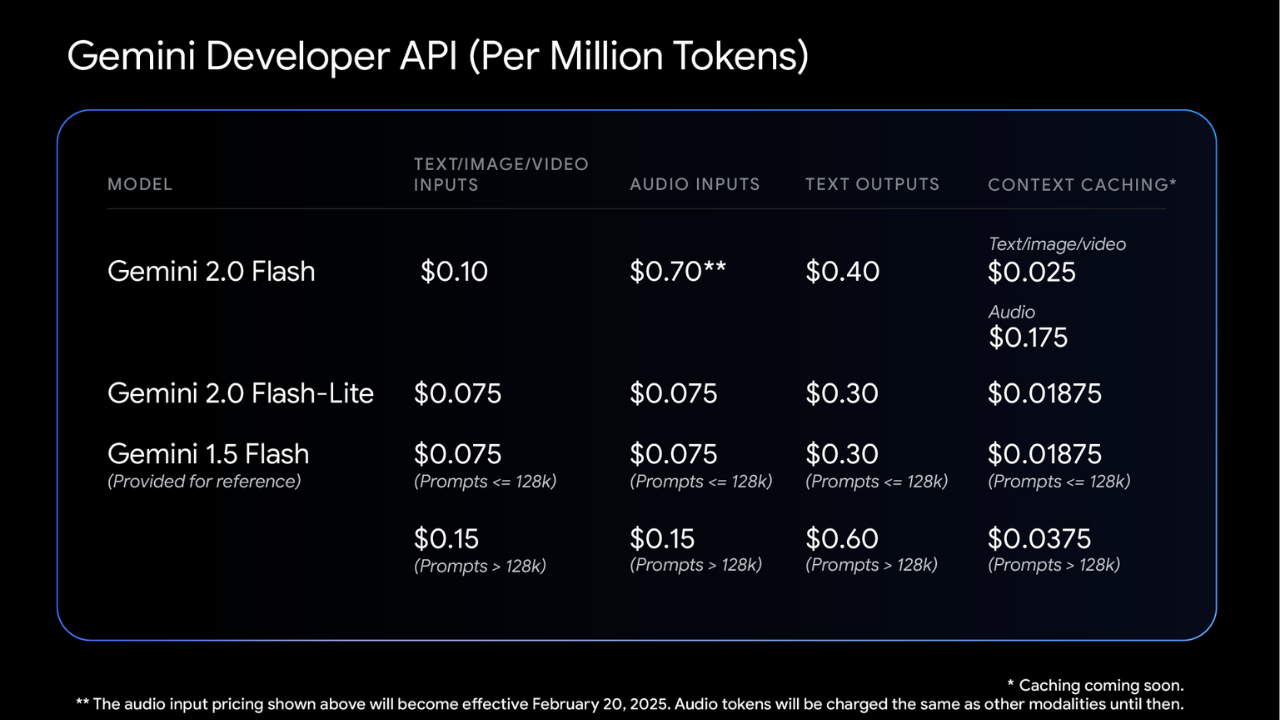
Hier müssen Sie eine wichtige Unterscheidung treffen, um die Verwirrung des Kopfes zu beseitigen. Gemini Für Entwickler, die diese Logik verwenden, ist eigentlich nichts Neues. TPM, RPM und tokenbasierte Preismodelle gelten seit vielen Jahren in der API-Welt. Die Software wurde bereits aus dem Token berechnet, das für die Kosten des von ihnen geschriebenen Codes ausgegeben wurde.
Die sich ändernde Sache ist die Umstellung auf die Gemini App, die jetzt die neueste Benutzeroberfläche der API Economy und die brutale Ressourcenoptimierungslogik dort ist. Google zielt darauf ab, den Source-Exploit zu übernehmen, indem der Standard-Endbenutzer und die Standard-Schnittstelle, die Chatbot sowie eine API-ähnliche Hardeme-Matrix verwenden, unterworfen werden.
Neuer Vorhang im Rennen um Künstliche Intelligenz: Inferenzökonomie und Kostenmanagement
Das Ereignis am Ende des Tages ist nicht nur, wie Google die Jeans berechnet. Wir sind nun in eine neue Phase in der Welt der künstlichen Intelligenz übergegangen: Inferenzökonomie. Kein Riese in der Branche, Milliarden von Dollar GPU-Investitionen können den Endbenutzern nicht "unbegrenzt und unkontrolliert" anbieten. Wenn sich die Modelle einander nähern, werden diese Modelle des ursprünglichen Gewinns das Unternehmen sein, das den Ring zu den am besten optimierten Kosten anbieten kann.
Dieser rechenbasierte KI-Schritt, den Google springt, ist ein Indikator, der den Markt für künstliche Intelligenz reift und in die Nachhaltigkeitsphase übergeht. In der kommenden Zeit werden wir wahrscheinlich ähnliche Bewegungen von Konkurrenten sehen. Wenn wir es als Entwickler tun müssen, um mit diesem neuen Layout Schritt zu halten, unsere Eingabeaufforderungen intelligenter zu gestalten und zu lernen, künstliche Intelligenz als "Beat-Monster" zu verwalten, während wir Code schreiben, nicht wie eine sensible Cloud-Quelle.
Häufig gestellte Fragen
Was ist das Gemini Nutzungslimit?
Die künstlichen Intelligenzmodelle von Google sind das maximale Handelslimit, das es pro Benutzer definiert, um die Serverlast zu schützen und auszugleichen. Bei dem neuen System basiert diese Grenze nicht mehr auf der Rechenleistung.
Wie hoch ist das Google AI Pro Limit?
Google Keine feste Anzahl von Nachrichten auf AI Pro. 4 mal höher als der kostenlose Plan des Limits. Wie viel sie verwenden können, hängt von der komplexität der aufforderung, den von ihnen verwendeten eigenschaften und der länge des chats ab.
Was bedeutet Gemini?
Der Benutzer drückt das gesamte Geschäftsvolumen aus, das in einem bestimmten Zeitrahmen aufgebaut werden kann. Das neue System ist direkt mit der Quote, der ausgegebenen Token-Tiefe und der Ausführungszeit des Modells verbunden.
Gemini Nutzungslimit beim Zurücksetzen?
Das Limit wird alle 5 Stunden erneuert; es gibt jedoch eine wöchentliche Obergrenze. Wenn Sie am Wochenende ankommen, warten Sie auf eine Erneuerung. Sie können mit dem Flash-Lite-Modell fortfahren, das plandays bezahlt wird, oder Sie können künstliche Intelligenz gutschreiben.
Erhöht das Compute-basierte KI-System die Gebühren?
Google nahm den 99,99-Dollar-Ultra-Plan, der im gleichen Zeitraum ein 5-solides Pro-Limit bot, und lud 20-stöckiges Ultra auf 199,99-Dollar herunter. Wenn das Limit nicht ausreicht, können Sie auch einen zusätzlichen Kredit für künstliche Intelligenz erhalten.
Gemini API und Gemini App-Limits sind die gleichen?
Nein, ganz anders. Die Gemini API verwendet eine flexible und dynamische Rechenjeans, die auf den genauen Token-Limits basiert, die Sie so viel bezahlen, wie Sie verwenden oder speziell für das Projekt definiert sind; Die Gemini App-Benutzeroberfläche verwendet eine flexible und dynamische Rechenjeans, die auf dem Abonnementmodell basiert.
Autor:inOpenAI Yapay Zekanın Yönetiminde Üç Adımlı Plan Sundu
Yapay Zeka Çağında Kamu Siber Güvenliği Alarm Veriyor