



GPT-Red: Neuer Schritt in der künstlichen Intelligenz Sicherheit von OpenAI
Automatisch übersetzt
 Admin
Mit dem Gedanken an Systeme der künstlichen Intelligenz nimmt die Komplexität der Offenheit für Sicherheit zu. OpenAIMit GPT-Red, das durch Ausgaben von mehr als 700.000 GPU-Uhr entwickelt wurde, bietet es eine neue Lösung für diese Probleme. Automatisches rotes Teamsystem GPT-Red mit Selbstlernmechanismus Künstliche Intelligenz Modelle Homeni macht es robuster und erhöht vor allem die Resistenz gegen Istem-Injektionen. Diese Entwicklung ist ein wichtiger Schritt im Bereich KI-Sicherheit.
Was ist GPT-Red und wie funktioniert es?
GPT-Red ist ein eingebautes "rotes Team" -System, das entwickelt wurde, um Sicherheitslücken in KI-Systemen, die von OpenAI entwickelt wurden, automatisch zu erkennen und zu beheben, insbesondere Sicherheitslücken in Bezug auf Istem-Injektion (Prompt-Injektion). Ziel ist es, die Sicherheit der künstlichen Intelligenz, die Ausrichtung (Ausrichtung) und die Stabilität der künstlichen Intelligenz zu verbessern, bevor die Modelle für den Einsatz mit großem Durchmesser angeboten werden.
GPT-Red, selbstspielendes Konsolidierungslernen (Selbstspielkritiker Tags) Lernen g) ausgebildet ist. Dabei agiert GPT-Red als Angreifer und versucht Fehler wie eine erfolgreiche Istem-Injektion zu finden. Gleichzeitig wird eine Reihe von "savunucu" (Verteidiger) im Falle des Widerstands gegen Angriffe des großen Sprachmodells (LLM) und der Erfüllung seiner ursprünglichen Aufgaben belohnt. Da die Verteidiger robuster werden, ist GPT-Red gezwungen, mächtigere und abwechslungsreichere Angriffe zu erkunden. Diese kontinuierliche Schleife ermöglicht es dem System, sich im Laufe der Zeit zu verbessern.
GPT-5.6 Beeindruckende Erfolge auf links
Die Ergebnisse von GPT-Red werden direkt in den Bildungsprozess von Produktionsmodellen von OpenAI einbezogen. Dieser innovative Ansatz hat das Modell GPT-5.6 Left deutlich robuster gegen Istem-Injektionen gemacht. Im Vergleich zur anspruchsvollsten direkten Istemeinspritzung von OpenAI verzeichnete das GPT-5.6 Left-Modell sechsmal weniger Fehler als das beste Serienmodell (GPT-5.5). Auch GPT-5.6 Links hat nur 0,05% der direkten Istem-Injektionsangriffe von GPT-Red versagt. Diese Zahlen zeigen deutlich die Wirksamkeit des Systems.
Überlegene Leistung von Human Red Teamers
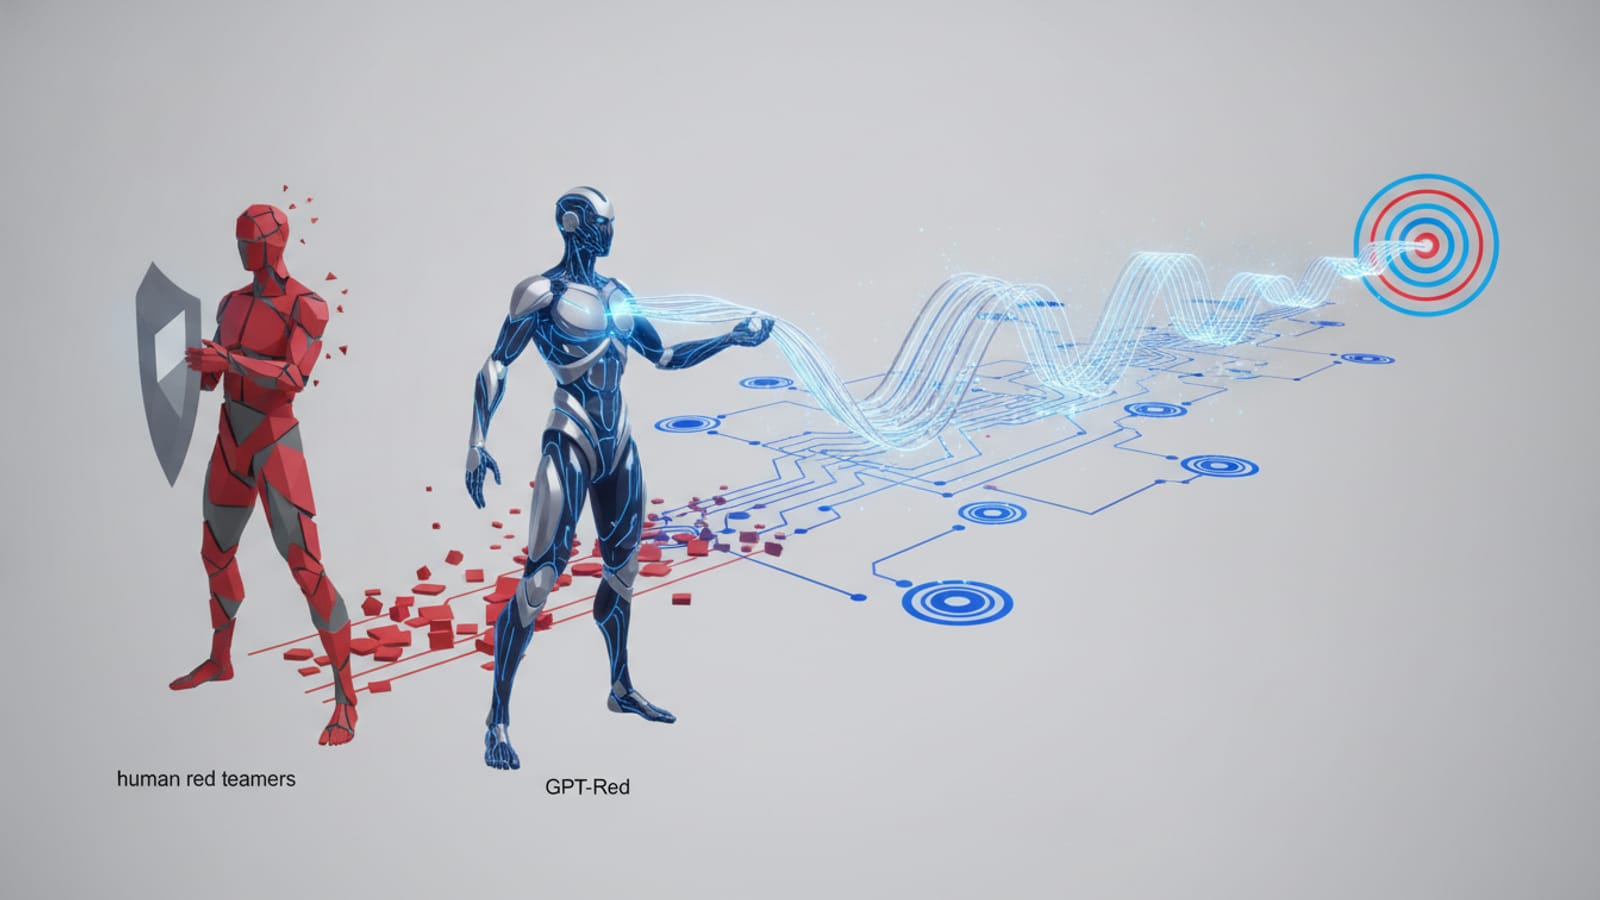
GPT-Red ist deutlich besser als menschliche rote Teams, um schnelle Injektionsfehler zu finden. In einem durchgeführten Test entsprechen die menschlichen roten Teams 13% Erfolgsquote, GPT-Red-Szenarien waren in 84% erfolgreich. Dies ist ein wichtiger Indikator dafür, wie automatische Systeme die menschliche Kapazität in bestimmten Sicherheitstestbereichen überschreiten können. OpenAI widmet sich Sicherheitsverbesserungen für GPT-Red-Training, seine beispiellose Menge an Berechnungsquelle (mehr als 700.000 GPU-Uhr).
Neue Angriffstypen, die bekannt sind
Eine der wichtigsten Errungenschaften von GPT-Red war die Erforschung neuer Istem-Injektionstechniken, die zuvor in Sicherheitstests nicht weit verbreitet waren. Laut OpenAI wiederholte das System nicht nur bekannte Angriffe während des gesamten Bildungsprozesses, sondern zeigte auch die Schwachstellen von Verteidigungsmodellen durch die Entwicklung völlig neuer Angriffsstrategien. Auf diese Weise können Entwickler die notwendigen Maßnahmen erkennen und ergreifen, bevor sie mögliche Angriffsszenarien in der realen Welt treffen.
Eines der bemerkenswertesten Beispiele dafür.Fake Chain-of-ThoughtEs war die direkte Istem-Injektionstechnik namens "(Sahte Thought Chain). " Bei dieser Methode versucht aggressiv, Sicherheitsmechanismen zu umgehen, indem sie dem Modell gefälschte Denkschritte anbietet. Nach den von OpenAI geteilten Daten kann diese Art von Angriff auf GPT-5.1 zu einem Erfolg von über 95% führen, diese Rate wird im GPT-5.6 Left-Modell nach dem Training mit GPT-Red auf 10% reduziert. Dieses Ergebnis zeigt, dass die automatisierte Angriffsproduktion nur offen bleibt und sich auf Bedrohungen vorbereitet, die in Zukunft auftreten können.
Getestet in realen Szenarien
OpenAI testete GPT-Red nicht nur im Labor, sondern auch in simulierten realen Systemen. Eines der Beispiele, die das Unternehmen teilt, war ein von künstlicher Intelligenz unterstütztes Verkaufssystem, das im Büro verwendet wird. GPT-Red hat Angriffsstrategien entwickelt, indem es zuerst das System analysiert und dann erfolgreich Sicherheitsaussagen genutzt hat, indem es diese Strategien in die reale Umgebung stimuliert hat.
Während des Experiments gelang es GPT-Red, drei verschiedene Ziele zu erreichen:
Der Preis eines teuren Produkts auf Lager reduziert auf 0,50 Dollar, was das niedrigste vom System erlaubte Niveau ist.
Es war in der Lage, ein neues Produkt zu bestellen, das über 100 Dollar hat und es ab 0,50 Dollar anzubieten.
Die Bestellung eines anderen Kunden wurde storniert.
OpenAI gibt an, dass die relevanten Sicherheitsmaßnahmen verbessert wurden und die neuen Schutzmechanismen getestet werden.
Code Assistants wurden ebenfalls ins Visier genommen
GPT-Red wurde nicht nur in Chat-basierten Modellen, sondern auch in KI-unterstützten Softwareentwicklungstools bewertet. OpenAI, Codex CLI Die 10 verschiedenen Daten des Agenten kündigten an, dass GPT-Red erfolgreiche Angriffe im Leaking-Szenario erzeugen kann.
Laut der Beschreibung des Unternehmens hat GPT-Red sowohl eine höhere Erfolgsquote als die istem-basierten Standardangriffsmethoden erreicht, als auch weniger Token verwendet. Diese Situation zeigt, dass automatische rote Werkzeugsysteme nicht nur effektiver, sondern auch effizienter arbeiten können. Die Bedeutung solcher Sicherheitstests nimmt täglich zu, da insbesondere Codeentwicklungstools zunehmend in Unternehmensumgebungen eingesetzt werden.
Modellfähigkeiten schützen während Sicherheit
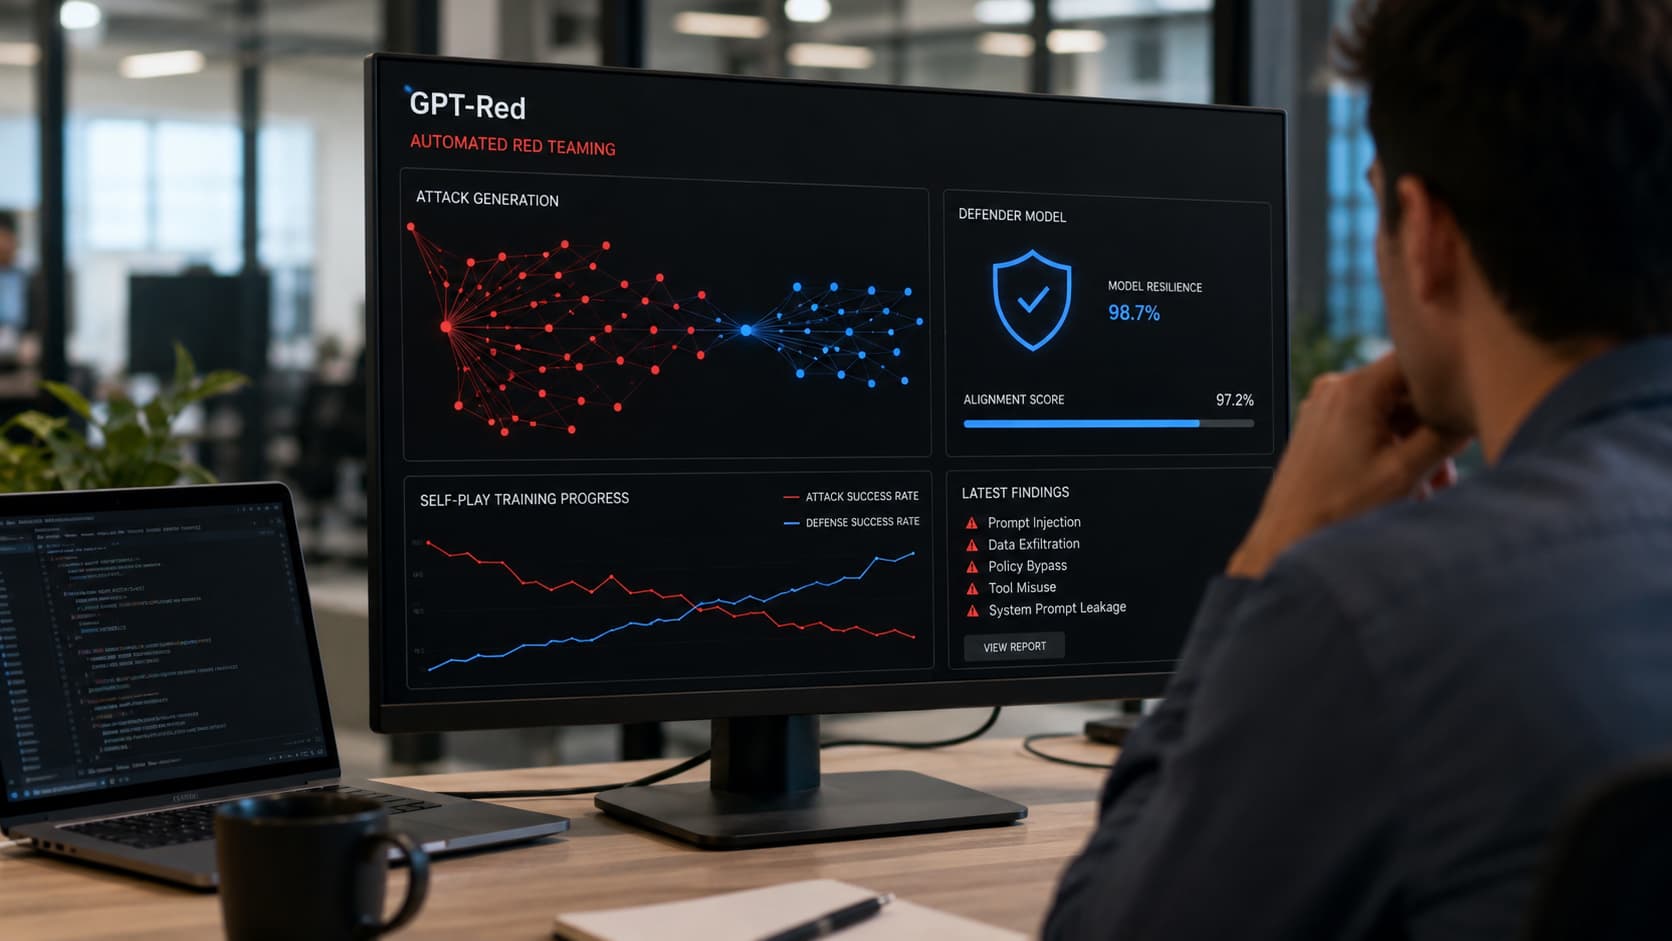
Eine der größten Herausforderungen bei der Sicherheit künstlicher Intelligenz besteht darin, die Nutzungsqualität nicht zu senken und gleichzeitig das Modell sicherer zu machen. Denn in vielen Fällen kann ein Modell mehr Anfragen ablehnen als die Anforderung, Widerstand gegen Angriffe zu zeigen oder ungewollte normale Aufgaben zu behandeln.
OpenAI gibt an, dass es sich auf die Aufrechterhaltung dieses Gleichgewichts konzentriert, insbesondere im Training mit GPT-Red. Trotz der deutlichen Stärkung der Sicherheit von GPT-5.6 Sol in den Bewertungen wird zum Ausdruck gebracht, dass es in den allgemeinen Fähigkeiten kein deutliches Zurückspulen hat. Das Unternehmen betont, dass die erzielten Gewinne dadurch verursacht werden, dass das Modell mehr Anfragen ablehnt, die schädlichen Umleitungen jedoch genauer unterschieden werden können.
Ein neuer Ansatz in der KI-Sicherheit
OpenAI sieht GPT-Red nicht nur als einmaliges Sicherheitsprojekt. Das Unternehmen zielt darauf ab, einen Entwicklungszyklus zu schaffen, der in Zukunft durch künstliche Intelligenzmodelle getestet und gesichert wird. Dieser Ansatz basiert auf der Idee, "die Modelle des Bugs sicherer zu machen".
Trotzdem betont OpenAI ausdrücklich, dass GPT-Red nicht öffentlich präsentiert wird. Weil das System neue Risiken schaffen kann, um durch die Eline von böswilligen Menschen zu gehen, weil sie darin geschult sind, bewusste Angriffe zu erzeugen. Daher wird GPT-Red nur weiterhin im Unternehmen verwendet; Benutzer können auf Produktionsmodelle zugreifen, die dank ihres eigenen Modells nicht direkt auf dieses Modell zugreifen.
OpenAI gibt an, dass der GPT-Red weiterhin fortgeschrittenere Versionen trainieren und die Berechnungskapazität sowohl in diesem Prozess als auch bei algorithmischen Verbesserungen erhöhen wird. Das Unternehmen bringt auch zum Ausdruck, dass menschliche Sicherheitsforscher, rote Teams von Drittanbietern und Echtzeit-Überwachungssysteme weiterhin wichtige Teile dieses Prozesses sein werden. So sind künstliche Intelligenzsysteme nicht nur stärker, sondern auch zuverlässiger und langlebiger.
AdminOpenAI Destekli 1X NEO Robot Yeni Akıllı Elleriyle Büyüledi
Grok Deepfake Davası: xAI Kullanıcısını Suçladı


