Harte Entscheidung von AI Academic Artikel Krise ArXiv: 1 Jahr Männer
Automatisch übersetzt
 Autor:in
Der größte und renommierteste Open-Access-Shop in der Welt der wissenschaftlichen Forschung ZuhauseIn der letzten Periode kletterte die KI in die Welt der digitalen Kultur und die Wissenschaft zog eine historische Erholung gegen die akademische Artikelkrise. Mit der Einführung großer Sprachmodelle (LLM) in unser Leben waren wissenschaftliche Produktionsprozesse so schnell wie eh und je, diese Situation führte zu einer unkontrollierten Inhaltsproduktion und einer ernsthaften ethischen Krise. Eine radikale Schritt-für-Schritt-Plattform gegen diese Invasion der künstlichen Intelligenz ist für Autoren, die von künstlicher Intelligenz produziert und kontrolliert werden. 1 Jahr für Sendeverbot angekündigt zu gelten.
Also, verteilt Karten in der digitalen Akademie? Eine Plattform mit der zentralen Basis der technologischen Revolution selbst geschaffen, warum fühlt es sich notwendig, ein Barikat gegen künstliche Intelligenz aufzubauen?
Künstliche Intelligenz im wissenschaftlichen Publizieren und Vorsichtsmaßnahmen
ArXiv, die erste Station der revolutionären Studien in den Bereichen Informatik, Mathematik und künstliche Intelligenz, hat keine soliden Schiedsrichterdelegationsprozesse, die Monate wie traditionelle akademische Zeitschriften dauern. Gegründet, um die Informationen schnell zu verbreiten, ist dieses System in der letzten Zeit für Missbrauch offen geworden. Einige Forscher, die einen akademischen Titel erwerben, die Anzahl der Posts erhöhen oder Geld verdienen wollen, wurden gesehen, dass sie begannen, Artikel vollständig auf künstliche Intelligenz zu drucken, ohne Daten zu sammeln oder zu experimentieren.
ArXiv hatte bereits Schritte, um die zunehmende Anzahl von Artikeln zu bekämpfen, die mit geringer Qualität und künstlicher Intelligenz hergestellt wurden. Die Plattform ist von einem bekannten Autor von Artikel Absendern zum ersten Mal vor dieser Situation vorbei Genehmigung (Bezug) die Bedingung zu nehmen. Trotz dieser Maßnahmen entschied sich die Plattform jedoch, direkt in das kriminelle System überzugehen, da es nicht in die unkontrollierte Produktion übergeht.
arXiv, das sich zu einer unabhängigen Non-Profit-Organisation entwickelt hat, nachdem es seit mehr als zwanzig Jahren von Cornell gehostet wurde, wird dank seiner neuen Struktur künstliche Intelligenz geschweißt "AI slop" (Nichtwertinhalt) Mehr Geld kann gesammelt werden, um Probleme wie anzugehen. Hier ist die neue ArXiv AI-Politik, die mit dieser Finanz- und Unternehmensmacht aktiviert wird, zielt darauf ab, die Zuverlässigkeit wissenschaftlicher Informationen direkt mit Sanktionen zu schützen.
Wissenschaftliche Ehrlichkeitsherausforderung: Warum jetzt und so schwer?
Die grundlegenden Ziele der neuen Politik, die das Plattformmanagement durch diesen radikalen Schritt umsetzt, sind ganz klar:
Schutz menschlicher Audits und Verantwortung:
Künstliche Intelligenz zielt darauf ab, sich allein wie ein Schriftsteller zu bewegen.
Filterung von Inhalten künstlicher Intelligenz:
Es soll die Verbreitung von Daten mit geringer Qualität oder "Halusination" (Satipping) verhindern.
Wahrung der Zuverlässigkeit der wissenschaftlichen Literatur:
Der Schutz der globalen Reputation der digitalen Plattform hat Priorität.
Diese Entscheidung hat nicht nur einen Bestrafungszweck; sondern gibt auch eine Botschaft an das Stück, das auf einen "Sorumluluk" -Aufruf an die wissenschaftliche Gemeinschaft abzielt: Künstliche Intelligenz-Tools können ein Assistent sein, aber die letzte Entscheidung und die Initiative sollte immer der Autor selbst sein.
Kein Rücktritt: "Single Error" Regelkreis
Neue Regeln, als Assistent von Forschern der KI (Sprachanordnung, Resektion), Übersetzen Home oder in Prozessen wie Codeschreiben bringt kein Verbot zum Ball. Der Punkt, dass die Plattform auf dem Haupt steht, wie der Inhalt produziert wird, die Übernahme der gesamten Verantwortung der Autoren. Die Forscher werden die gesamte Verantwortung übernehmen, wenn sie irreführende Informationen hinzufügen oder Referenzen von AI direkt in die Arbeit aufnehmen.
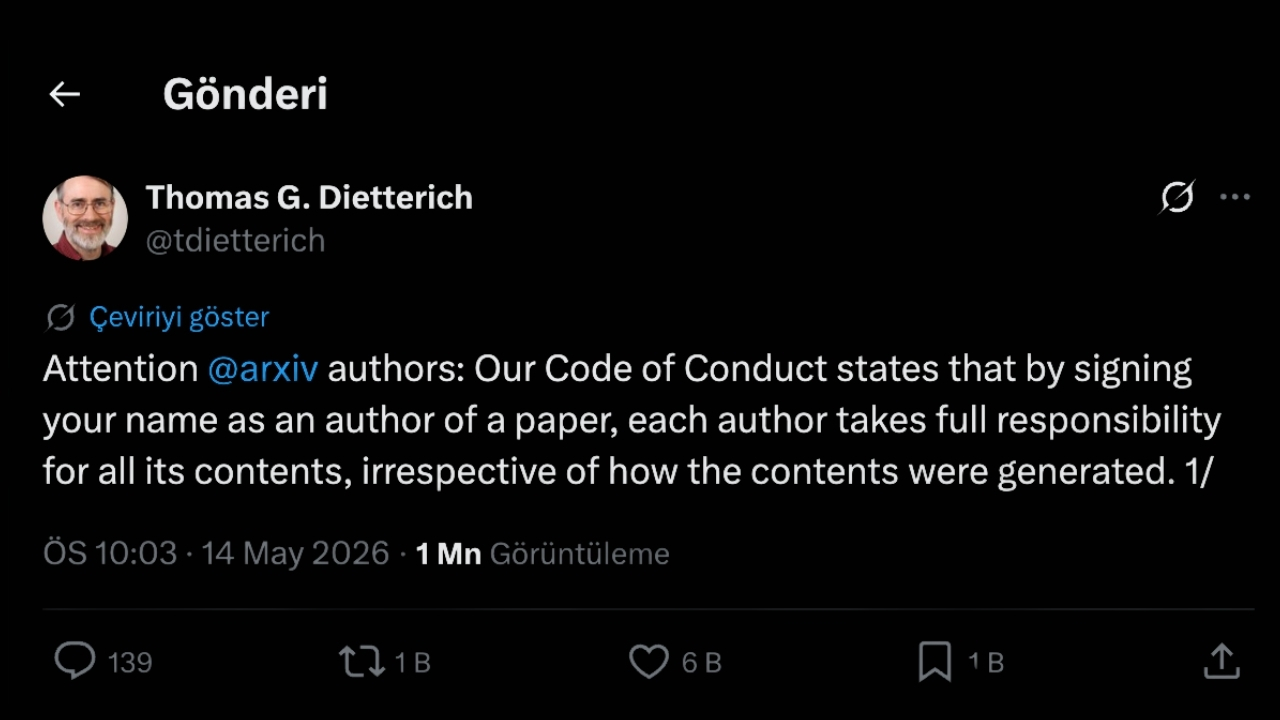
Der Prozess, wenn solche Situationen erkannt werden"Einzigfehler"-Prinzipwird mit arbeiten. Der Bericht der Modatoren und die Beweise für Kapitelköpfe werden nach der Bestätigung der Strafen abgeschlossen. Die Autoren, die gegen die Regel 1 Jahr des ArXiv-Satzes verstoßen, sowie die neuen Artikel, die sie nach Abschluss der Strafe an die Plattform senden, aber sie können möglicherweise in ein vorbewertetes und von Experten begutachtetes Medium laden. Das Recht, diesen Entscheidungen der Autoren zu widersprechen, bleibt ebenfalls vorbehalten.
Was erwartet uns in Zukunft?
Diese Entscheidung ist ein großer Schritt, um die Grenzen der künstlichen Intelligenz Forschungsethik zu klären, aber im Falle von viel größeren und tiefen Diskussionen feuerte den Docht. Auf der anderen Seite des Madalyon ist bekannt, dass Erkennungswerkzeuge für künstliche Intelligenz (KI-Detektoren) zu gegebener Zeit falsche Ergebnisse liefern und sogar die Originaltexte vollständig wie die KI-Produktion kennzeichnen können. Insbesondere die jungen Forscher, die die Muttersprache als nicht-englische und künstliche Intelligenz als Sprach-only-Support-Tool verwenden, sind jetzt ein großes Anliegen in der Akademie, die durch das Risiko der Blockierung in dieser festen Regeln und einzelne Fehler betroffen sein wird.
Auf der anderen Seite ArXiv Unternehmensunabhängige Struktur und FondssucheEs ist auch ein Indikator dafür, dass eine solche technologische Krise nicht nur mit Regeln, sondern mit einem viel größeren Budget und einer viel größeren technologischen Infrastruktur gelöst werden kann. In der kommenden Periode werden wir nicht nur Artikel diskutieren, sondern auch die Integration künstlicher Intelligenz von Systemen, die Artikel kontrollieren. Die Wissenschaftswelt scheint das Budget und nicht die Geschwindigkeit der generierten Inhalte trennen zu müssen.
Als Ergebnis; Wenn sich die Technologie entwickelt, werden die Inhalte, die ohne intellektuelle Arbeit, Zweifel und Kontrolle der menschlichen intellektuellen Arbeit in LLM-wissenschaftlichen Publikationsprozessen produziert werden, in der Wissenschaftswelt nicht berücksichtigt. Dieser Schritt von ArXiv ist ein Kandidat für einen historischen Meilenstein, der die zukünftigen gemeinsamen Lebensstandards der digitalen Kultur- und Wissenschaftswelt, ethische Grenzen und vor allem die Definition von "heute und richtige Informationen" neu definieren wird.
Autor:inAdventHealth ChatGPT ile İdari Yükünü Yüzde 80 Azalttı
Endava'nın AI Ajanlarla Yazılım Teslimatı Dönüşümü