Lösung für Halusination in der Künstlichen Intelligenz: Was ist RAG Architektur?
Automatisch übersetzt
 Autor:in
Große Sprachmodelle (LLM) Obwohl sie eine enorme Sprachfähigkeit haben, frieren sie nicht ein und bleiben in der Geschichte der Bildungsdatenlizenzierung, und sie können falsche Informationen produzieren, die zuversichtlich sind, was sie wissen. Es ist die architektonische RAG, die heute zum Industriestandard geworden ist, um dieses Problem namens Halusination zu lösen und mit aktuellen, verifizierten Unternehmensdaten über künstliche Intelligenz zu sprechen.
Was ist Retrieval-Augmented Generation (RAG) genau?
RAG ist ein Framework, das es ermöglicht, ein Modell der künstlichen Intelligenz auf eine vertrauenswürdige Datenbank von Informationen von außen anzuwenden, bevor es reagiert. Traditionelle Sprachmodelle reagieren nur auf geschlossene Informationen, die sie in der Bildungsphase lernen und sich im Gewicht verstecken. Die RAG-Architektur öffnet dieses geschlossene System nach außen; gibt dem Modell die Möglichkeit, ein nevi "offenes Buch" zu testen. Somit wird das Problem des Datenmangels oder Updates auf Basis der durch künstliche Intelligenz verursachten Fragestellung durch Einspeisen dynamischer Daten aus dem Modell gelöst.
Die Bedeutung der RAG-Architektur: 2020 Was zeigt uns NeurIPS-Artikel?
Dieses Konzept stand im Zentrum der Technologiewelt mit einem bahnbrechenden Artikel, der von Patrick Lewis und dem Team in Meta AI im Jahr 2020 veröffentlicht wurde. "Retrieval-Augmented Generation für wissensintensives NLP" Aufgaben NeurIPS 2020 Artikel hat bewiesen, dass Sprachmodelle viel erfolgreichere Ergebnisse liefern können, indem sie Informationen aus einer Wikipedia-Datenbank herausziehen, ohne sich alles merken zu müssen. Dieser Artikel war der erste konkrete Indikator, dass Modelle den aktuellen Erfolg erfassen können, ohne die Anzahl der Parameter in Trilyonen zu entfernen.
Wie funktioniert ein RAG-System Schritt für Schritt?
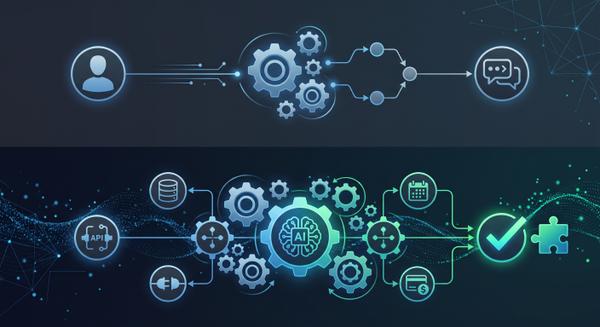
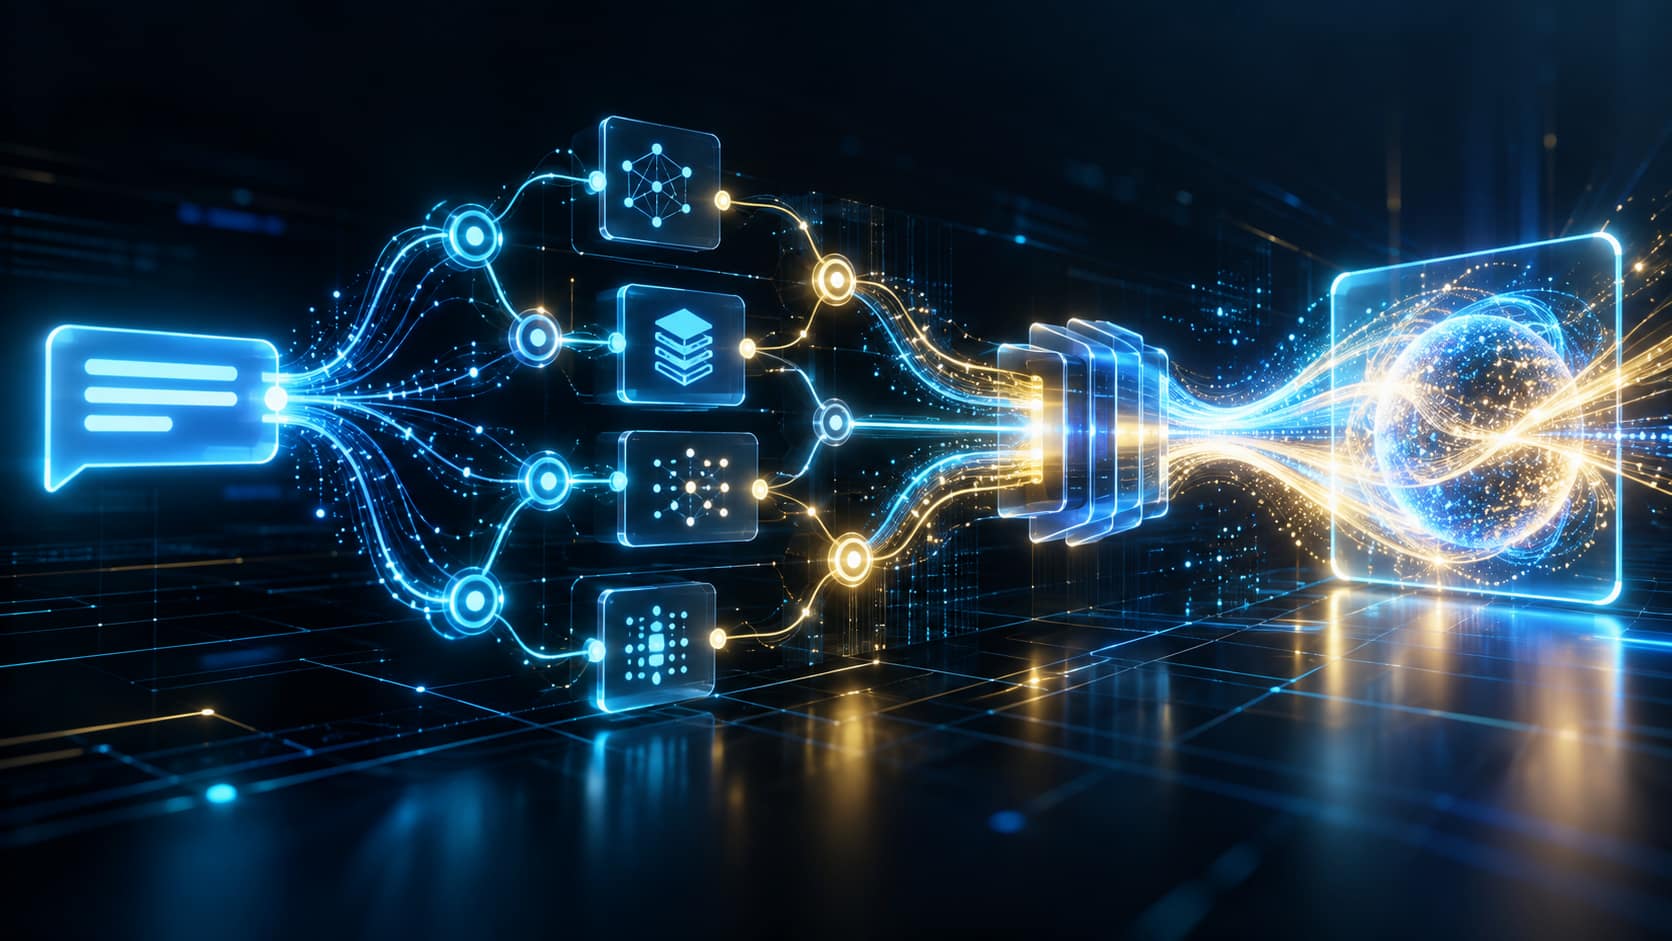
Die RAG-Architektur besteht aus zwei grundlegenden Phasen, wie der Name schon sagt: Recall (Retrieval) und Production (Generation). Wenn der Benutzer dem System eine Frage stellt, stoppt das Modell den Prozess, anstatt direkt zu antworten. Das Rückrufmodul, das mit Suchmaschinenlogik läuft, erstellt die übereinstimmendsten Dokumente aus der externen Datenbank mit der Frage des Benutzers. Dann werden diese aktuellen Dokumente mit der ursprünglichen Frage des Benutzers (Promptromaation) dem großen Sprachmodell präsentiert. Das Sprachmodell erzeugt eine schlanke, natürliche und ressourcenspezifische Reaktion auf den Endbenutzer, indem es diesen neuen und genauen Kontext liest.
Welche Rolle spielen Vektordatenbanken im RAG-Prozess?
Die RAG-Architektur ist eine Vektordatenbank. Die PDF-Berichte von Unternehmen können nicht schnell nach einem Sprachmodell in der Standardform von Kundenanrufen oder interner Korrespondenz suchen. Diese Texte werden mit einer Transaktion namens "Pinkdding" in Tausende von numerischen Arrays (Vektoren) konvertiert. Die Vektordatenbanken wie Pinecone, Milvus oder Weaviate speichern diese numerischen Sequenzen. Wenn der Benutzer eine Frage stellt, wird die Frage sofort in den Vektor übersetzt und die nächsten aussagekräftigen Daten in der Datenbank werden in kurzer Zeit von Sekunden gepaart und an das System zurückgegeben.
Warum ist RAG in großen Sprachmodellen?
Kein Unternehmen, das künstliche Intelligenz auf Unternehmensebene integrieren möchte, kann sich die Rede des Modells nicht durch Annahmen leisten. Die RAG-Architektur eliminiert die Kosten für kontinuierliche Umschulungen. Anstatt Millionen von Dollar Rechenleistung auszugeben, um eine Finanztabelle oder ein aktuelles Modellmodell zu lehren, wird das entsprechende Dokument einfach in die Vektordatenbank aufgenommen. Darüber hinaus maximiert RAG die Auditierbarkeit des Systems, indem ein Verweis auf "Ich habe diese Informationen von der 4. Seite des X-Dokuments erhalten" hinzugefügt wird.
Agentic RAG: Wo ist die Zukunft der Künstlichen Intelligenz?
Traditionelle RAG Genau wie eine statische Bibliothek, die Dokumente zu der gestellten Frage findet und bringt. Aber die neue GenerationZuhause RAG-Architekturen wandeln das Modell in eine Entscheidungsfindung um. Wenn das System bei der ersten Suche nicht genügend Informationen findet, kann es selbst neue Subabfragen erstellen, im Internet suchen oder eine andere API auslösen, um die Daten zu verifizieren. Es wird zu einem autonomen Agenten, der nicht nur die künstliche Intelligenz, die Bau- und Forschungsstrategie liest, sondern auch die Arbeitsströme der Informationsdichteindustrie verändert.
Was denkt die Gemeinschaft?
Im Entwickler-Ökosystem hat RAG zwei wichtige aktuelle Ansichten über die Zukunft. Die Mehrheit argumentiert, dass RAG trotz der Erweiterung des Kontextfensters immer ein Industriestandard mit dem Vorteil von Kosten und Genauigkeit bleiben werden. Ein weiterer Schnitt sind die Modelle der neuen Generation mit riesigen Kontextfenstern wie 2 Millionen Token (zum Beispiel, Gemini 1.5 Pro) prognostiziert, dass die gesamte Datenbank den Bedarf an komplexen Vektordatenbankinfrastrukturen in Zukunft reduzieren kann, da sie sofort gelesen werden kann.
Häufig gestellte Fragen
Was ist der Unterschied zwischen RAG und Fine-Tuning (Thread Setting)?
Feinabstimmung trainiert die inneren Gewichte, um das Verhalten oder die Sprachstruktur des Modells dauerhaft zu ändern; RAG ändert das Modell nicht, bietet ein sofortiges Gedächtnis (Link). Um aktuelle Informationen hinzuzufügen, wird RAG mit Feinabstimmung verwendet, um den Sprachstil des Modells an die Branche anzupassen.
Ist es teuer, RAG-Architektur zu bauen?
Das Sprachmodell ist viel kostengünstiger im Vergleich zu Zug von Grund auf neu oder kontinuierliche Feinabstimmung. Vektordatenbanken und Rückrufe (Retrieval-) Operationen können auch mit recht billiger Hardware effizient durchgeführt werden.
Setzt das RAG-System Halluzinationen vollständig zurück?
Es reduziert sich erheblich, wenn es vollständig zurückgesetzt wird. Das Modell kann manchmal die Daten von außen falsch interpretieren oder den Kontext ausführen, aber da es basierend auf der Quelle funktioniert, ist die Erkennung des Fehlers viel einfacher und korrigierbar.
Autor:inSağlık Sektöründe NLP ve Şeffaflık: Klinik Modellerde Güven
Vibe Coding Uygulamaları 16 Bin Veritabanını Açıkta Bıraktı