Zum Inhalt springen
Zurück zur Blogübersicht
LLM Veri Formatı Karşılaştırması: Yapay Zeka İçin En Doğrusu Hangisi?
Data Science

LLM Datenformat Vergleich: Welches ist das Beste für künstliche Intelligenz?

Automatisch übersetzt
Büşra Özer
Büşra ÖzerAdmin
4 Min. Lesezeit

Große Sprachmodelle (LLM) Bei der Diskussion über die Zuverlässigkeit von Betriebssystemen wird in der Regel auf die Anzahl der Parameter oder Trainingsdaten des Modells eingegangen. Aber meistens gibt es ein sehr grundlegendes technisches Detail, das übersieht: In welchem Format bieten wir dem Modell Daten an? Der LLM-Datenformatvergleich ist ein entscheidendes Element, das nicht nur auf "intelligent" eines künstlichen Intelligenzsystems reagiert, sondern auch direkt die Betriebskosten bestimmt.
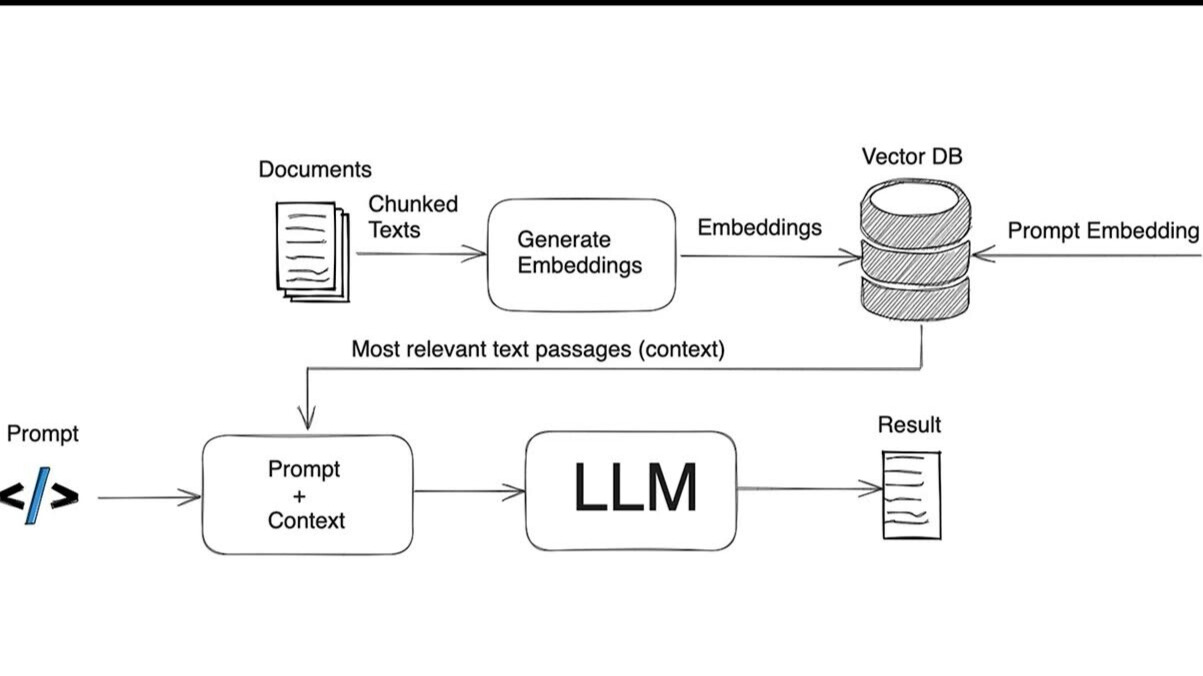
Rag-pipeline-llm

Insbesondere bei RAG Pipeline Optimierungsprozessen, Tabellen oder hierarchischen Daten (JSON, CSV, Markdown usw.) Die Methode der Übertragung auf das Modell beeinflusst den Gesamterfolg des Systems. Die Wahl des falschen Formats kann den Anteil der Datengenauigkeit der künstlichen Intelligenz aufgrund einer falschen Interpretation des Modells oder eines überflüssig hohen Wertes reduzieren. LLM-Tokenkosten mit Ihrem Budget. In diesem ausführlichen Überblick analysieren wir die Leistung verschiedener Datenformate mit technischen Daten und Benchmark-Ergebnissen.

Welches Format bedeutet vorzugsweise LLMs-Tabellen?

1.000 verschiedene Fragen zu künstlichen Intelligenzmodellen über 1.000 registrierte Datensätze Kontrollierte Experimentezeigt die Auswirkungen der Formatauswahl auf die Systemgenauigkeit dramatisch.

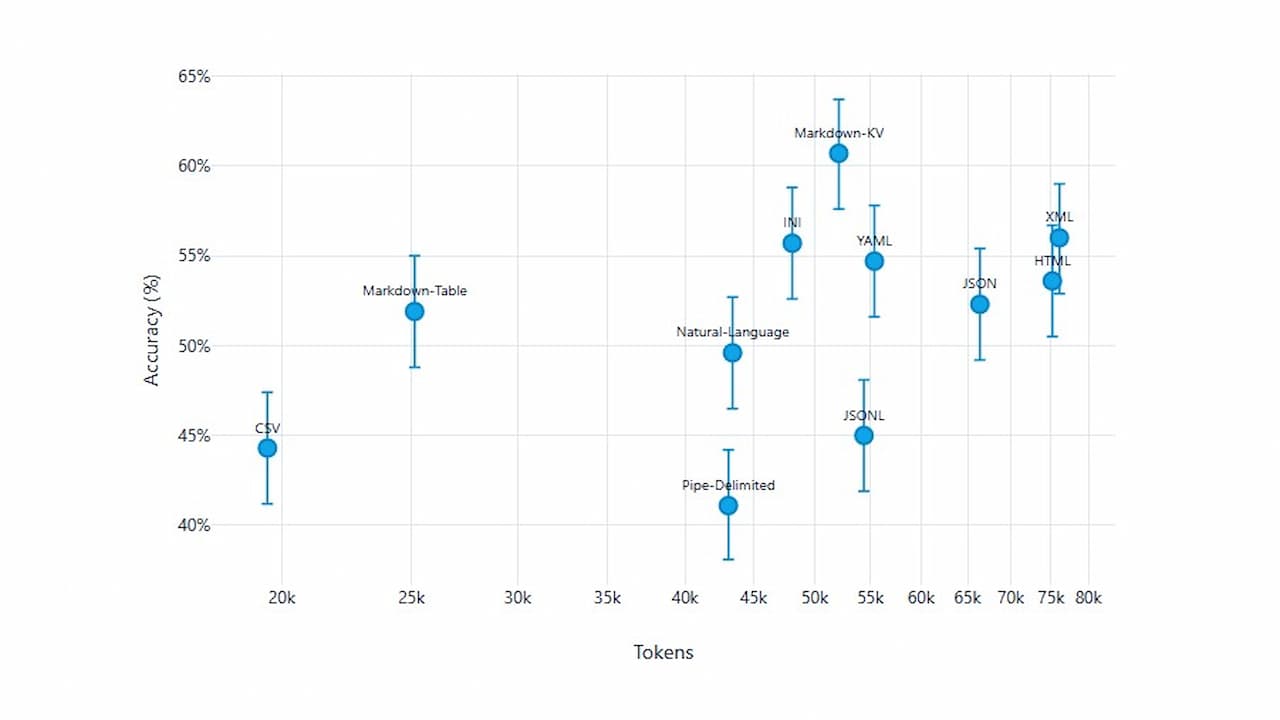
  • Markdown-KV (Key-Value) Format: In den durchgeführten Tests wurden 60,7% der Genauigkeit erreicht. Schlüssel zu jedem Datensatz anstelle von klassischen Tabellen: Diese Struktur, die Wertepaare bietet, erleichtert es dem Modell, die Beziehung zwischen Daten herzustellen.
  • XML und INI: Es folgt Markdown-KV mit einer Genauigkeit von rund 56%. Aber die Kosten für XML sind ziemlich hoch.
  • CSV und JSONL Performance: Überraschenderweise blieb die am häufigsten verwendete CSV JSONL-Leistung in der Datenwissenschaft ziemlich niedrig. CSV 44,3%, JSONL bleiben bei 45% Genauigkeit. Dies deutet darauf hin, dass LLMs gezwungen sind, Rohdaten zu erfassen, die durch Komma getrennt sind.
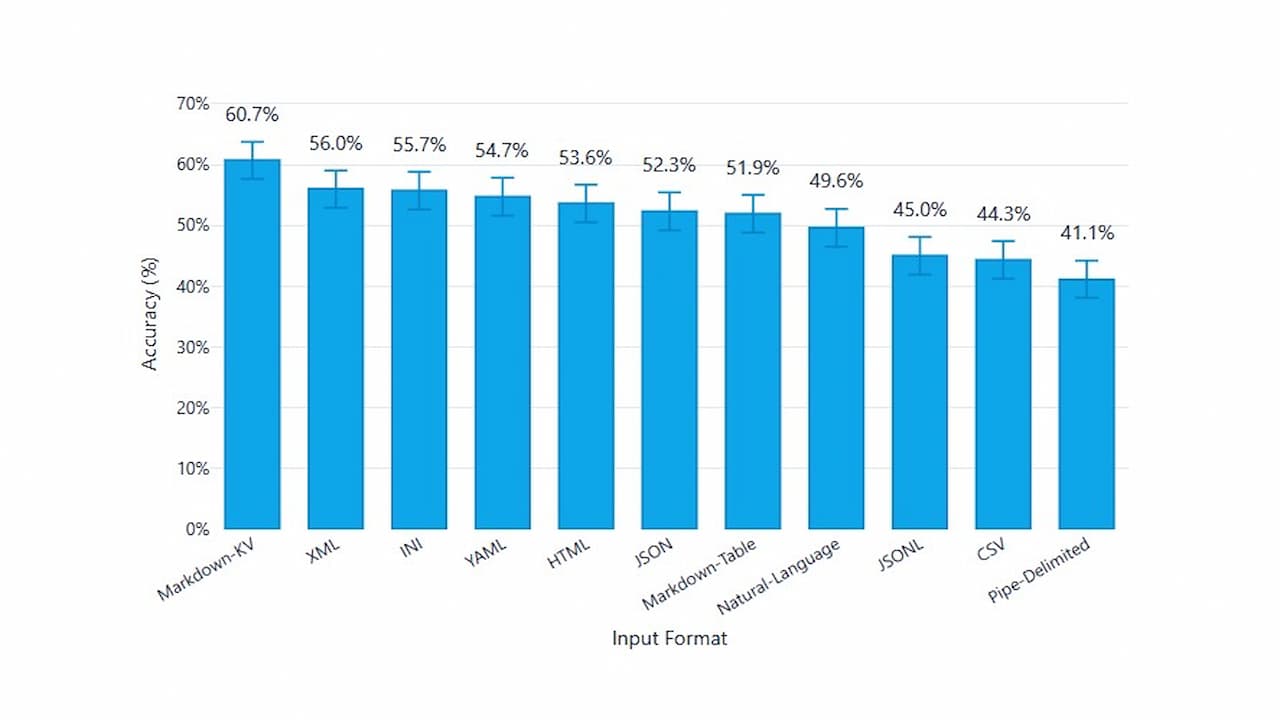
  • Token Effizienz: CSV, Format verbraucht mindestens Token (19.524 Token) Obwohl es eine der niedrigsten Genauigkeitsraten hat. Markdown-KV bietet einen 16-Punkte-Genauigkeitsvorteil, obwohl es 2,7 Mal mehr Token verbraucht als CSV.
  • LLM'ler Tabloları Anlamada Hangi Formatı Tercih Ediyor

    Was ist das beste Format in Havarchy (internen) Daten?

    Moderne KI-Systeme müssen in der Regel interne Daten wie API-Antworten oder Konfigurationsdateien verarbeiten. LLM Datenformat Vergleich bietet unterschiedliche Ergebnisse von Modell zu Modell.

    • YAML – Accuracy Leader: GPT-5 Nano und Gemini 2.5 Flash Lite Modelle Zuhause zeigte die höchste Leistung. Die visuelle Hierarchie basierend auf dem Eingang liefert die komplexen Strukturen des Modells "sehen".
    • Markdown-Cost-Champion: Markdown war das tokeneffizienteste Format in allen Modellen. 34-38% von JSON verbraucht etwa 10% weniger Token von YAML. Ideal für diejenigen, die die Kosten minimieren und gleichzeitig die erforderliche Genauigkeit beibehalten möchten.
    • JSON's Poorness: Trotz der weit verbreiteten Nutzung JSONzeigte eine schlechtere Leistung als bei den GPT-5- und Gemini-Modellen erwartet. Nur Llama 3.2 hat JSON akzeptable Ergebnisse gegeben, da die Formatgenauigkeit im 3B Instruct-Modell gering ist.
    • Wie viel von XML: XML hat sowohl den höchsten Tokenverbrauch als auch seine Genauigkeitsraten sind in der Regel in der letzten Zeile enthalten. Wiederholte Etikettenstrukturen () können den Aufmerksamkeitsmechanismus des Modells verteilen (Aufmerksamkeit).

    Wie beeinflusst die Formatauswahl die Genauigkeit der RAG-Pipeline?

    • Was ist betroffen? Die Genauigkeit eines RAG-Systems (Retrieval-Augmented Generation) hängt davon ab, wie die empfangenen Informationen dem Modell zugeführt werden. Das falsche Format führt das Modell zu einer falschen Berichterstattung, basierend auf "Halbflation".
    • Warum wichtig? Eine Reduzierung der Datengenauigkeit von künstlicher Intelligenz um 10% kann eine Katastrophe für den Kundendienst-Bot oder das Finanzanalyse-Tool bedeuten.
  • Wie optimieren? Wenn die Genauigkeit vor allem wichtig ist, sollte Markdown-KV oder YAML verwendet werden. Wenn das Budget begrenzt ist und die Daten dicht sind, sind Markdown-Tabellen ein guter mittlerer Weg.
  • Wo zu verwenden? Diese Optimierung ist an jedem Punkt wichtig, an dem die Ergebnisse der Datenbankabfrage an LLM übertragen werden.
  • Wer tut das? Dateningenieure und KI-Architekten müssen das Format der Daten in einer schnellen Engineering-Phase in einen Standard umwandeln.
  • Token Kosten- und Leistungsbilanz

    Token-Verbrauch von Datenformaten ist direkte Betriebskosten. Zum Beispiel erfordert das XML-Format 80% mehr Token als Markdown. Das bedeutet, dass Sie fast doppelt so viel Geld bezahlen, um die gleichen Daten zu verarbeiten.

    Performance-Material Matrix:

    1. Genauigkeitspriorität (High Budget): Markdown-KV (für Sheets), YAML (für verschachtelte Daten).
    2. Bilanzpriorität: Abgleichtabellen.
    3. Niedrige Kostenpriorität (Low Accuracy Acceptance): CSV oder JSONL.
    Token Maliyeti ve Performans Dengesi

    Strategische Empfehlungen für die Anwendung

    Nach den Ergebnissen des LLM-Datenformatvergleichs kann die Verwendung von CSV oder JSON das Potenzial Ihres Systems einschränken. Es wird empfohlen, diese Schritte unter Beibehaltung der technischen Tiefe zu befolgen:

    • Wenn die Tabellendaten in Ihrem System intensiv verwendet werden, fügen Sie eine Zwischenschicht hinzu, die die Daten in das Markdown-KV-Format konvertiert, bevor Sie sie an das Modell senden.
    • Standardisieren Sie das YAML-Format für komplexe Konfigurationsdateien oder Kataloge.
    • Dein Modell (GPT, Llama, Gemini usw.) Führen Sie kleine Benchmark-Tests mit Ihrem eigenen Datensatz durch, um festzustellen, welches Format reaktionsfähiger ist.
    • Laden Sie das XML-Nutzungsminimum herunter, um unnötigen Token-Abfall zu vermeiden.

    Zuhause "rechts" Es gibt kein Format; aber nach Ihren Zielen "Optimieren" Format. Wenn die Genauigkeit kritisch ist, sind YAML und Markdown-KV die stärksten Standards der Welt der KI für 2025 und später, wenn die Kosten kritisch sind. Der Erfolg des Systems hängt nicht nur vom Vorhandensein der Daten ab, sondern das Modell konsumiert sie in reinster und verständlicher Form.

    Große Sprachmodelle (LLM) Bei der Diskussion über die Zuverlässigkeit von Betriebssystemen wird in der Regel auf die Anzahl der Parameter oder Trainingsdaten des Modells eingegangen. Aber meistens gibt es ein sehr grundlegendes technisches Detail, das übersieht: In welchem Format bieten wir dem Modell Daten an? Der LLM-Datenformatvergleich ist ein entscheidendes Element, das nicht nur auf "intelligent" eines künstlichen Intelligenzsystems reagiert, sondern auch direkt die Betriebskosten bestimmt. Insbesondere bei RAG Pipeline Optimierungsprozessen, Tabellen oder hierarchischen Daten (JSON, CSV, Markdown usw.) Die Methode der Übertragung auf das Modell beeinflusst den Gesamterfolg des Systems. Die Wahl des falschen Formats kann den Anteil der Datengenauigkeit der künstlichen Intelligenz aufgrund einer falschen Interpretation des Modells oder eines überflüssig hohen Wertes reduzieren. LLM-Tokenkosten mit Ihrem Budget. In diesem ausführlichen Überblick analysieren wir die Leistung verschiedener Datenformate mit technischen Daten und Benchmark-Ergebnissen. Welches Format bedeutet vorzugsweise LLMs-Tabellen? 1.000 verschiedene Fragen zu künstlichen Intelligenzmodellen über 1.000 registrierte Datensätze Kontrollierte Experimente zeigt die Auswirkungen der Formatauswahl auf die Systemgenauigkeit dramatisch. Markdown-KV (Key-Value) Format: In den durchgeführten Tests wurden 60,7% der Genauigkeit erreicht. Schlüssel zu jedem Datensatz anstelle von klassischen Tabellen: Diese Struktur, die Wertepaare bietet, erleichtert es dem Modell, die Beziehung zwischen Daten herzustellen. XML und INI: Es folgt Markdown-KV mit einer Genauigkeit von rund 56%. Aber die Kosten für XML sind ziemlich hoch. CSV und JSONL Performance: Überraschenderweise blieb die am häufigsten verwendete CSV JSONL-Leistung in der Datenwissenschaft ziemlich niedrig. CSV 44,3%, JSONL bleiben bei 45% Genauigkeit. Dies deutet darauf hin, dass LLMs gezwungen sind, Rohdaten zu erfassen, die durch Komma getrennt sind. Token Effizienz: CSV, Format verbraucht mindestens Token (19.524 Token) Obwohl es eine der niedrigsten Genauigkeitsraten hat. Markdown-KV bietet einen 16-Punkte-Genauigkeitsvorteil, obwohl es 2,7 Mal mehr Token verbraucht als CSV. Was ist das beste Format in Havarchy (internen) Daten? Moderne KI-Systeme müssen in der Regel interne Daten wie API-Antworten oder Konfigurationsdateien verarbeiten. LLM Datenformat Vergleich bietet unterschiedliche Ergebnisse von Modell zu Modell. YAML – Accuracy Leader: GPT-5 Nano und Gemini 2.5 Flash Lite Modelle Zuhause zeigte die höchste Leistung. Die visuelle Hierarchie basierend auf dem Eingang liefert die komplexen Strukturen des Modells "sehen". Markdown-Cost-Champion: Markdown war das tokeneffizienteste Format in allen Modellen. 34-38% von JSON verbraucht etwa 10% weniger Token von YAML. Ideal für diejenigen, die die Kosten minimieren und gleichzeitig die erforderliche Genauigkeit beibehalten möchten. JSON's Poorness: Trotz der weit verbreiteten Nutzung JSON zeigte eine schlechtere Leistung als bei den GPT-5- und Gemini-Modellen erwartet. Nur Llama 3.2 hat JSON akzeptable Ergebnisse gegeben, da die Formatgenauigkeit im 3B Instruct-Modell gering ist. Wie viel von XML: XML hat sowohl den höchsten Tokenverbrauch als auch seine Genauigkeitsraten sind in der Regel in der letzten Zeile enthalten. Wiederholte Etikettenstrukturen ( ) können den Aufmerksamkeitsmechanismus des Modells verteilen (Aufmerksamkeit). Wie beeinflusst die Formatauswahl die Genauigkeit der RAG-Pipeline? Was ist betroffen? Die Genauigkeit eines RAG-Systems (Retrieval-Augmented Generation) hängt davon ab, wie die empfangenen Informationen dem Modell zugeführt werden. Das falsche Format führt das Modell zu einer falschen Berichterstattung, basierend auf "Halbflation". Warum wichtig? Eine Reduzierung der Datengenauigkeit von künstlicher Intelligenz um 10% kann eine Katastrophe für den Kundendienst-Bot oder das Finanzanalyse-Tool bedeuten. Wie optimieren? Wenn die Genauigkeit vor allem wichtig ist, sollte Markdown-KV oder YAML verwendet werden. Wenn das Budget begrenzt ist und die Daten dicht sind, sind Markdown-Tabellen ein guter mittlerer Weg. Wo zu verwenden? Diese Optimierung ist an jedem Punkt wichtig, an dem die Ergebnisse der Datenbankabfrage an LLM übertragen werden. Wer tut das? Dateningenieure und KI-Architekten müssen das Format der Daten in einer schnellen Engineering-Phase in einen Standard umwandeln. Token Kosten- und Leistungsbilanz Token-Verbrauch von Datenformaten ist direkte Betriebskosten. Zum Beispiel erfordert das XML-Format 80% mehr Token als Markdown. Das bedeutet, dass Sie fast doppelt so viel Geld bezahlen, um die gleichen Daten zu verarbeiten. Performance-Material Matrix: Genauigkeitspriorität (High Budget): Markdown-KV (für Sheets), YAML (für verschachtelte Daten). Bilanzpriorität: Abgleichtabellen. Niedrige Kostenpriorität (Low Accuracy Acceptance): CSV oder JSONL. Strategische Empfehlungen für die Anwendung Nach den Erg

    Etiketler:LLM Veri Formatı KarşılaştırmasıRAG Pipeline OptimizasyonuToken Verimliliği ve Doğruluk
    Büşra Özer
    Büşra ÖzerAdmin
    @busraozer

    Kommentare (0)

    Melde dich an, um zu kommentieren.

    Anmelden
    Noch keine Kommentare. Schreib den ersten!