Neue Revolution von Meta: Sam Audio Künstliche Intelligenz Modell!
Automatisch übersetzt
 Admin
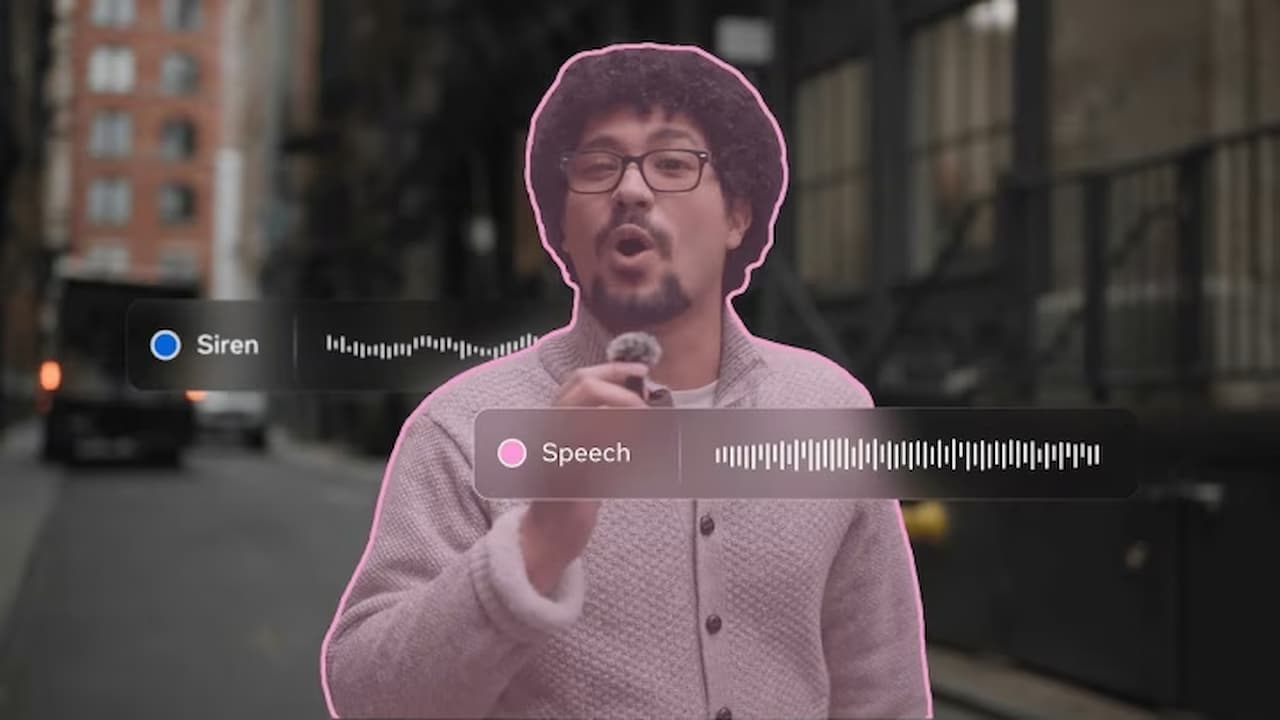
Meta AI ist ein großes Echo in der Bildverarbeitung WeltSegment Anything ModellIndem er die Architektur von „(SAM) in die Klangwelt stimulierte, startete er ein neues Paradigma im KI-Ökosystem. SAM Audiozielt darauf ab, digitale Audioverarbeitungsstandards von der Wurzel zu ändern, indem Audioobjekte in komplexen akustischen Umgebungen identifiziert, getrennt und isoliert werden können. Dieses Modell wird als unabhängiges "Obje" jedes Audioelements in einer Audioaufzeichnung angesprochen, so wie es jedes Objekt in einem Foto auswählen kann.
Was ist SAM Audio?
SAM AudioJede Audioquelle (menschliche Stimme, Instrument, Tierstimme, mechanisches Rauschen, etc. in komplexen und sehr stimmlichen Umgebungen.) ist ein Grundmodell der künstlichen Intelligenz, das sich selbstständig als "visuelles Objekt" identifiziert und perfekt voneinander unterscheidet. Im Gegensatz zu herkömmlicher Audiobearbeitungssoftware klingt dieses Modell nicht nur als Wellenform, jedes sieht die Kombination von Teilen mit verschiedenen Zeichen. Diese Situation gibt dem Benutzer die Freiheit, Teile eines Fotos wie auf einer Tonplatte zu schneiden und einzufügen.
Technische Kapazität und Wettbewerbsanalyse Home
Hinter dem Erfolg von SAM Audio steht Meta Transformator basierte Architektur und Training auf einer riesigen Audiobibliothek. Der Sound für Computer besteht normalerweise aus komplexen Frequenzen im Inneren. Aber SAM Audio löst dieses Chaos mit:
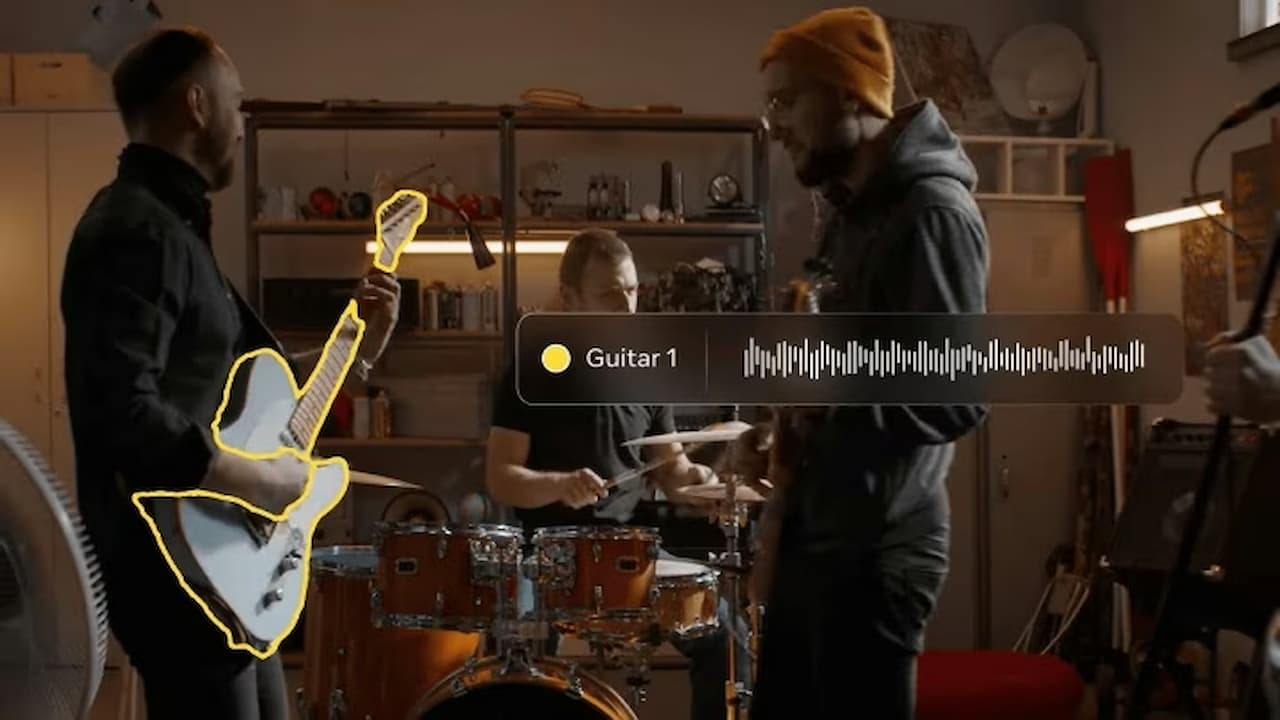
- Akustische Signaturanalyse: Das Modell weiß, dass jede Stimme einen "Fingerabdruck" hat. Sie verstehen den taktischen Unterschied des Klangs vom Draht einer Gitarre mit einem scharfen Draht und legen sie in separate Schichten.
- Zero Sample Learning: Dieser Begriff bedeutet, dass selbst eine Stimme, der das Modell noch nie begegnet ist, als "Wut und separater Klang" wahrgenommen werden kann. Zum Beispiel kann die Stimme eines neu produzierten Staubsaugers den Fernsehton im Hintergrund trennen, auch wenn er nicht im Trainingsset ist.
Aktuelle Audio AIs ()OpenAITags ElevenLabs usw. normalerweise „Text-to-Speech ist fokussiert, d.h. nimmt einen Text und wandelt ihn in eine menschliche Stimme um. Aber SAM Audio, ein "Ses Segmentierung und Manipulation" Modell. Dies bringt es in eine "mimar" Position, anstatt einen "Produzenten", der die Teile des Klanguniversums trennen und neu verwalten kann.
Widerspruch der Stimme
Modelle wie ElevenLabs erzeugen den Sound als ein einziges Ganzes. SAM Audio definiert jedes Element in einer Audiodatei (z. B. Klimaanlagengeräusche im Hintergrund, die Atemstimme des Lautsprechers und das Echo im Raum) als unabhängige Objekte.
Differenz: Während andere Modelle versuchen, Rauschen zu drucken, SAM Audio Rauschen "langsam". Dies kann nur unerwünschte Teile mit chirurgischer Präzision entfernen, ohne den ursprünglichen Klang überhaupt zu beschädigen.
Natürlichkeit und akustisches Bewusstsein
Obwohl OpenAI Sprachmodelle bieten eine hohe Natürlichkeit, sie liefern oft die besten Ergebnisse in studioähnlichen sterilen Umgebungen. Technische Überlegenheit von SAM Audio, Sound Raumakustik Home verstehen.
Emotoning: SAM Audio analysiert nicht nur die Frequenz der Stimme, emotionale Akzente im Inneren und Pausen als "anlamsal". Es hat die Verarbeitungskapazität, indem es den Klang von Vibrationen (Mikrohythmen) unterscheidet, dass eine Stimme Angst bekommt oder jubelt.
Geringe Verzögerungszeit und Effizienz
SAM Audio, Meta "Effizienter Segmenter" Gebaut auf Architektur. Anstatt die gesamte Datei während der Verarbeitung von Audiodaten zu lesen, wird diese Architektur gleichzeitig betrieben, indem die Stimme in kleine "Token" unterteilt wird.
Technischer Vorteil: Während komplexe Operationen anderer Modelle (Klonen oder Reinigen von Stimmen) auf Cloud-Servern längere Zeit in Anspruch nehmen, arbeitet SAM Audio dank seiner optimierten Struktur mit einer viel geringeren Latenz. Das ist sie Live-Posts und Übersetzungen in Echtzeit Einen Schritt vor seinen Konkurrenten.
Zero-Shot Kapazität und Flexibilität
OpenAI und ElevenLabs-Modelle erfordern in der Regel ein intensives Training in bestimmten Sprachen und Audiotönen. SAM Audio kann eine Stimme (z. B. ein sehr seltenes Musikwerkzeug) mit ihrer "Zero-shot" -Kapazität sofort identifizieren und isolieren. Dies beweist, dass das Modell nicht in vordefinierten Kategorien pillt.
Wie zu verwenden?
Meta, SAM Audio Da das Modell (wie in der Phase der Entdeckung) noch nicht zu Anwendungen wie WhatsApp oder Instagram für den letzten Benutzer hinzugefügt wurde. Es gibt jedoch zwei Möglichkeiten, diese Technologie zu nutzen:
Meta AI Demo und Forschungsseiten
Meta, neue Modelle sind oft Meta AI-Forschung Die Website bietet interaktive Demos.
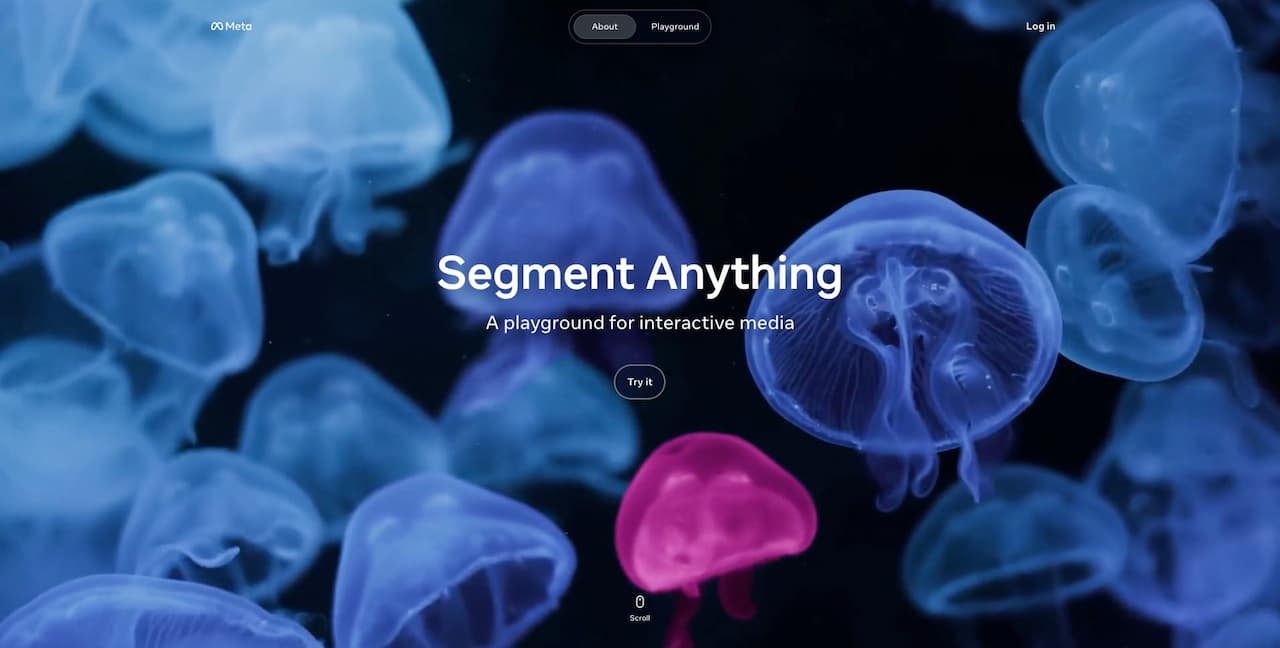
- Schritt 1: Besuchen Sie die offizielle "Segment Anything"-Website von Meta AI.
- Schritt 2: Laden Sie eine Audiodatei im Demo-Bereich hoch.
- Schritt 3: Klicken Sie auf die Region, die Sie auf dem Specogram trennen möchten (audiovisuelle Karte) oder geben Sie ein Skript wie "Lassen Sie einfach die menschliche Stimme" im Textfeld ein.
- Schritt 4: Hören und laden Sie die Audioebenen herunter, die das Modell nicht trennt.
Für Entwickler und technische Anwender
SAM Audio ist ein Basismodell mit Open Source Code. Wenn Sie Kenntnisse von Python auf der Grundstufe haben, oder wenn Sie ein Programmierer sind:
- Zugang zum Code: Meta GitHub Sie können die gewichte und codes des modells von der seite auf ihren computer herunterladen.
- Hugging Face: Diese Modelle werden von der Community optimiert Hugging Face Sie können direkt im Browser testen.
- API Nutzung: Um Ihre eigenen Anwendungen zu verbessern, können Sie die Bibliothek des Modells zu Ihrem Projekt hinzufügen.
Verwendungen und Auswirkungen des täglichen Lebens
SAM Audio ist ein praktisches und leistungsstarkes Werkzeug, das über den theoretischen Erfolg hinausgeht, indem Audiodaten in Teile unterteilt werden können:
- Zugänglichkeit: Löst "Kokteyl Party Problem" in Hörgeräten. In lauten Umgebungen wie Café oder Restaurant; Einzelobjekte wie Fork-byek und Whirltu machen nur den Klang des Ziellautsprechers.
- Produktion: Minimiert Aufnahmefehler in der Kino- und Content-Produktion. Ein Krankenwagen oder ein Windgeräusch, das zurückgeht, ohne den Dialog in den externen Aufnahmen zu stören, kann aus der Aufzeichnung entfernt werden "wie mit einer Pinzette gezogen". Müzisyens kann alte Platten in Sekunden auf Gesang und Instrumente trennen.
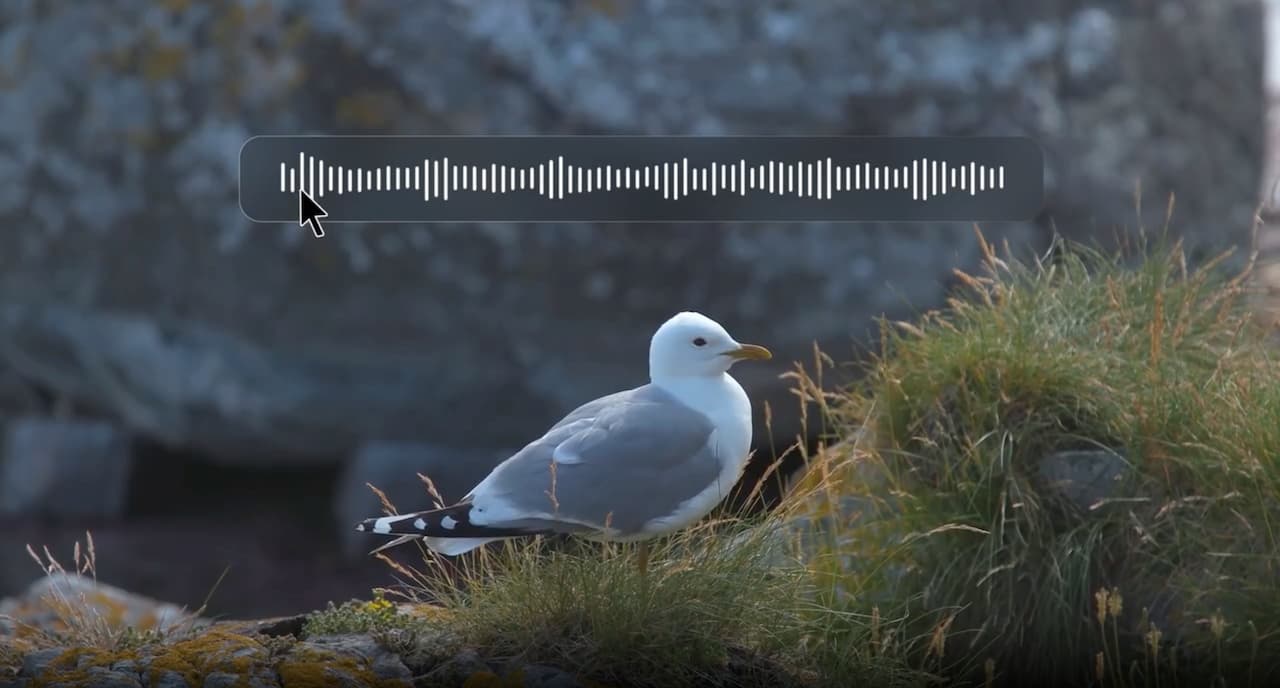
- Sicherheit & Wissenschaft: Erkennt sofort bestimmte Geräusche wie Glasbruch oder Schrei in der Stadtsicherheit. In den Naturwissenschaften erleichtert es das ökologische Tracking, indem es den Klang eines einzelnen lebenden Typs durch eine komplexe Waldaufzeichnung isoliert.
Die perfekte Manipulation von Sounds daraus, digitale Fälschung ()tief) und das Risiko von Datenschutzverletzungen. Aber Meta positioniert dieses Modell als mehr Kreativität und zugängliche Technologie.
Dieses Modell in naher Zukunft Smartphone-Betriebssysteme integriert. Dies bedeutet eine sofortige Bearbeitung des Umgebungslärms bei Telefongesprächen, ohne dass professionelle Software für Audioschichten in aufgenommenen Videos erforderlich ist.
Wie in naher Zukunft zu verwenden?
Wenn die Technologie die neueste geworden ist, wird sie auf diese Weise in unser Leben eintreten, ohne ein spezielles technisches Wissen zu erfordern:
Meta SAM Audio Technologie konvertiert Sound in digitale Objekte, die aus einfachen Daten gesteuert werden können. Smartphones Im Gegensatz zur Standard-Rauschblockierung macht der Ton einen chirurgischen Eingriff durch Einspruch. Bei einem Telefonanruf werden Babyschreie auf der Rückseite oder Straßengeräusche vollständig vom Lautsprecher getrennt, externe Geräusche werden durch Studiopräzision zerstört und nur eine klare Stimme wird auf die gegenüberliegende Seite übertragen.
Social Media und Videobearbeitung Das Modell gibt dem Benutzer einen "visuellen Radiergummi", indem er den Audiokanal in Stücke wie ein Puzzle trennt. In der Videoladephase können unerwünschte Geräusche von automatisch definierten Geräuschen wie Wind, Vögel oder Verkehr mit einem Klick gelöscht werden. SAM Audio ermöglicht es Ihnen, professionelle Inhalte zu produzieren, indem Sie den gelöschten Audioraum mit einer natürlichen Stille füllen.
Hörgeräte im Feld "Kokteyl Party Problem". Dank des "Solving Mode" können Benutzer Code und Eifersucht als "unerwünschtes Objekt" auf dem Beistelltisch. Diese Technologie verbessert die soziale Interaktion von der Wurzel aus, so dass das Gerät nur die gezielten Geräusche im kristallklaren Bereich übertragen kann.
AdminHIX AI: Çok Yönlü İçerik Üretim Platformu Rehberi
Stream Ring: Yapay Zeka ile Güçlendirilmiş Akıllı Yüzük Satışa Açıldı!