Phi-4-Reasoning-Vision: Visual Mind Execution Devri von Microsoft
Automatisch übersetzt
 Creator
Wenn das Ökosystem der künstlichen Intelligenz mit größeren und kostengünstigeren Modellen verheiratet ist, widerspricht Microsoft einem neuen Ansatz, der Auswendiglernen vorschreibt. Multimodale Argumentationsmodelle sind einer der mächtigsten Vertreter der Vision von 2026, Phi-4-Reasoning-Vision startet eine echte visuelle Argumentationspatrouille in der Branche, indem es das "wie groß es ist" eliminiert. Dieses 15-Milliarden-Parameter (15B)-Modell der neuen Generation, das hauptsächlich eingeführt wird, ist nicht nur in der Lage, Bilder passiv zu erkennen, sondern auch mit sehr Schritt auf diese Bilder, logische und komplexe Interessen. EntwicklerMicrosoft KI-Modelle für die Gießerei„ aus dem Katalog, Hugging Face von der Plattform und GitHub Diese innovative Struktur, auf die sofort zugegriffen werden kann, bietet starke analytische Fähigkeiten auch auf Endgeräten und reduziert die Abhängigkeit von Rechenzentren, die eine hohe Rechenstärke erfordern.
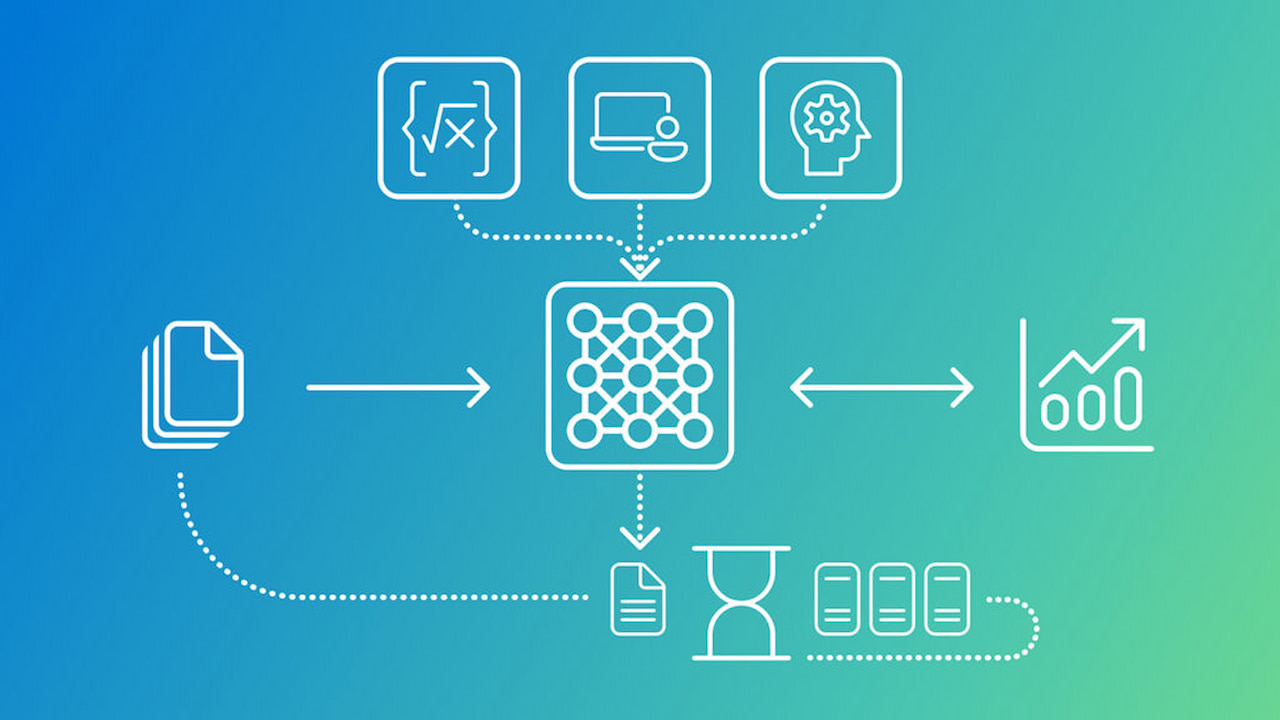
Warum Phi-4-vision? Weniger Daten, mehr Intelligenz
Phi-4-vision 15B ist die enorme Datenoptimierung im Bildungsprozess des Modells, das unter seinen Merkmalen die meiste Aufmerksamkeit auf sich zieht und bei Forschern der künstlichen Intelligenz eine Überraschung hervorruft. Die stärksten Konkurrenzmodelle der Branche Qwen 3 VLTags Zuhause und Gemma 3 Gigantische Vision-Sprachsysteme werden oft mit riesigen Datentoken über 1 Billion trainiert. Im Gegenzug wird-4 Phi-Reasoning-Vision nur mit 200 Milliarden multimodalen Token trainiert und hat es geschafft, in bestimmten Bereichen eine überlegene Leistung zu erbringen.
Wie bekommt man eine hohe Intelligenz mit Daten mit einer Rate von fünf? Die Antwort liegt in der Akribie im Prozess der Datenheilung und nicht in der Datenmenge. Die Forscher klassifizierten die Bildungsdaten manuell aus dem zufälligen Internet, korrigierten falsche Fragen, Logikfehler und Formatstörungen in Open-Source-Datensätzen. In den notwendigen Fällen werden mit Modellen wie GPT-4o Daten synthetisch angereichert und perfekt ein Datenpool erstellt. Dieses Modell, das in kurzer Zeit trainiert wurde und nur 240 PS NVIDIA B200 GPU verwendet, ist ein Meisterwerk, das die Grenzen von Pareto in Bezug auf Energieeffizienz und Rechenstärke erweitert.
Die folgende Tabelle fasst die strukturellen Unterschiede, die das Modell gegenüber seinen Mitbewerbern zeigt, klar zusammen:
Merkmal | Phi-4-reasoning-vision-15B | Rivalenmodelle (Qwen/Gemma) |
|---|---|---|
Bildungsdaten | 200 Milliarden Token | 1 Trilyon+ Token |
Ausgewählter Bereich |
Wissenschaftliche Berichterstattung & UI Understanding
Allgemeine visuelle Kennzeichnung
Hardware benötigt
Niedrige / bescheidene Hardware
Hoch / Datacenter
Mentale Hinrichtung
Hybrid (Gründung + NichtGründung)
Einzelmodus
Technische Architektur: Mid-Fusion und SigLIP-2 Integration u
Wie man visuelle und textuelle Daten in einem Modell der künstlichen Intelligenz kombiniert, bestimmt es direkt die Effizienz des Modells. Frühe Fusionsmodelle, die seit Beginn von Bildern und Texten im gleichen Transformator arbeiten, erfordern eine sehr große Rechenstärke und Speicherkapazität. Phi-4-reasoning-vision nutzt die Mid-Fusions-Architektur, um gleichzeitig kostengünstig und mit hoher Expressionsstärke zu sein. In dieser Architektur, die von Google zur Verarbeitung von Bildern entwickelt wurde, übernimmt SigLIP-2 die Aufgabe des visuellen Encoders. Visuals werden zuerst in visuelle Token übersetzt, dann wird der Mehrschichtsensor (MLP) mit Sprachtoken gemischt, indem er mit einer Projektionsschicht in den bündigen Raum des Phi-4-Modells übertragen wird.
Der ärgerlichste Punkt dieser Integration ist die Verwendung einer dynamischen Auflösung. Dank der NaFlex-Variante von SigLIP-2 werden Bilder ohne Verzerrung der ursprünglichen Seitenraten verarbeitet. Die Anzahl der visuellen Token kann je nach Bedarf bis zu 3.600 (etwa 720p HD-Auflösung) betragen. Diese dynamische Struktur bietet eine einzigartige visuelle Wahrnehmungsschärfe, indem sie das kleinste Symbol auf einem Computerbildschirm oder feine detaillierte Grafiken in einem wissenschaftlichen Artikel blockiert.
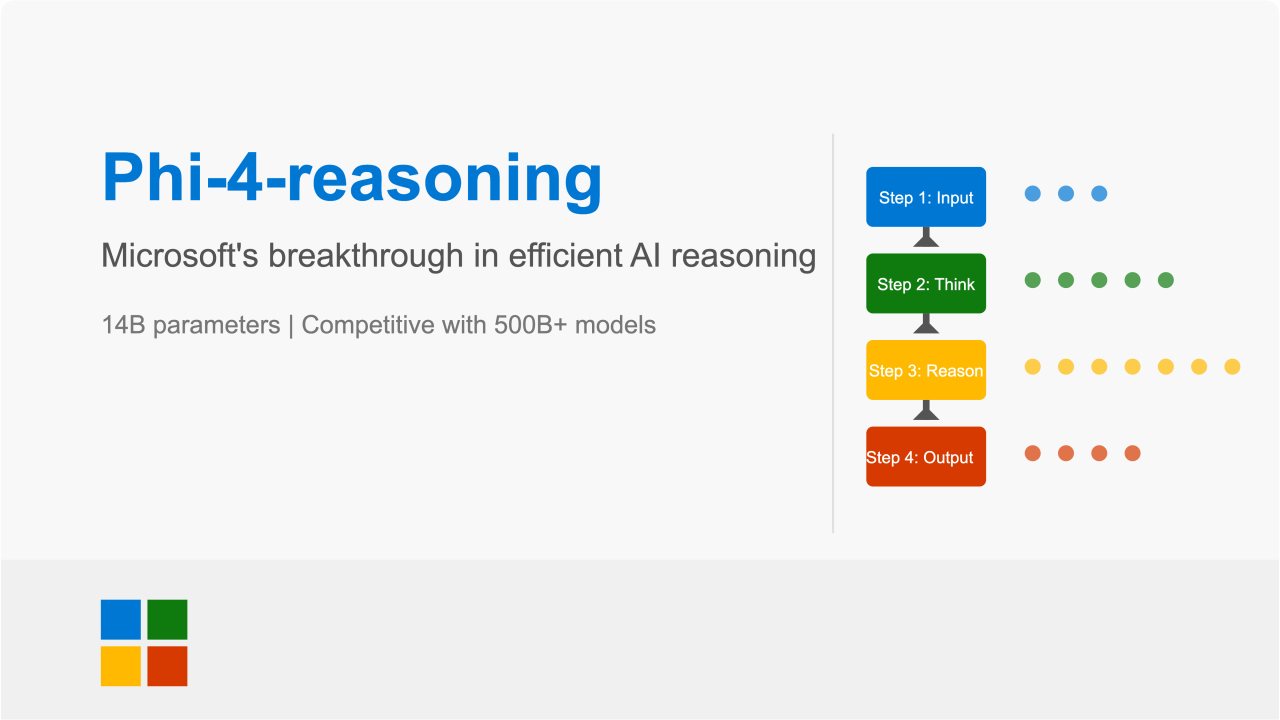
Hybriddatenstrategie: Mentale Ausführung und Wahrnehmung
Phi-4-Reasoning-Vision hat einen revolutionären Hybrid-Hörmotor, der den Benutzern die Optionen "Dick" oder "Dick" bietet, verglichen mit einheitlichen Modellen, die jedes Problem mit der gleichen Methode lösen. Etwa 80% der Bildungsdaten des Systems werden wahrgenommen und 20% von ihnen bestehen aus Daten, die eine gründliche Argumentation erfordern.
Benutzer können das Verhalten des Modells eindeutig umleiten. Wenn nur das Transkript des Dokuments aufgefordert wird, die Koordinate eines Objekts beim Lesen oder Anzeigen der Quittung zu haben, In Sekunden mit Tag erzeugt es direkte Ergebnisse, ohne unnötige Rechenleistung auszugeben. Aber wenn ein komplexes Physikproblem eine mathematische Frage oder eine mehrstufige analytische Aufgabe erhält, die Beweise erfordert, ... Durch die Eingabe der Etiketten trennt es das Problem in logische Teile, bewertet Zwischenschritte und erreicht die genaueste Antwort mit einem verketteten Denkprozess. Diese Flexibilität maximiert die Genauigkeit und reduziert gleichzeitig die Latenz.
2026 Anwendungsgebiete: Screen Reading und wissenschaftliche Analyse
Phi-4-Reasoning-Vision, darüber hinaus ein einziger akademischer Erfolg zu sein, industrielle und individuelle Probleme zu lösen ein professionelles Werkzeug entwickelt. Microsoft Gießerei Al-Modelle sind die Hauptanwendungsgebiete dieser künstlichen Intelligenz:
Screen Usage (CUA): Model kann Smartphone-, Desktop- und Webbrowser-Schnittstellen mit ausgezeichneter Präzision lesen. Ein Rekordwert wie 88.2, den ScreenSpot v2 testet, beweist, dass das Modell nicht nur die Buttons, Menüs, Korbsymbole und Textfelder auf dem Bildschirm erkennen kann, sondern dass diese Elemente (x,y) in Millimetern erfasst werden können. Otonom bietet eine perfekte "See" -Infrastruktur für Agenten der künstlichen Intelligenz (z. B. E-Commerce-Bots).
Wissenschaftliche geistige Hinrichtung: Die mathematische Logik des Modells hinterlässt die Giganten in der Branche. Die Studierenden analysieren mathematische Gleichungen gefüllt mit Schwärzungen, überschriebenen Fehltransaktionen und komplexen Manuskripten. Es bietet schrittweise Lösungen, die erklären, wo Fehler wie ein Lehrer gemacht werden, wobei der Schwerpunkt auf der korrekten Verarbeitung defekter Teile liegt. Es kann auch intensive akademische Grafiken und istatische Tabellen erfolgreich kommentieren. 75,2 Punkte im MathVista Mini-Test belegen diese überlegene Fähigkeit.
Visual Language Tasks: Um die täglichen Arbeitsabläufe zu beschleunigen, kann das Modell Rechnungs-, Plug- oder komplexe PDF-Dokumente in Text und konfigurierbare Formate konvertieren (z. B.: JSON). In den Szenarien „Was hat sich geändert?, die für Robotik und Agentenanwendungen sehr kritisch sind, kann sie die zeitlichen und räumlichen Unterschiede zwischen ihnen sofort erkennen, indem sie die aufeinanderfolgenden Fotos aus der Art Arda vergleicht.
Künstliche Intelligenz Welt Die Größe hat sich mit Phi-4-reasoning-vision erneut bewährt, was für Qualitätsdaten und optimierte Architektur immer sehr wichtig ist. Mit seiner Effizienz, Intelligenzkapazität und seinem geringen Hardwarebedarf ist dieses Modell einer der strategischsten KI-Assistenten von 2026 und darüber hinaus.
CreatorOpenAI Anthropic Savaşı: İhanet, Sızıntı ve Halka Arz!
LLM ile Eşli Programlama: Google Destekli Ücretsiz Kurs 2026