Türkische Modelle für künstliche Intelligenz: BİLGE, Kumru, T3 AI und andere
Automatisch übersetzt
 Autor:in
Die großen Sprachmodelle haben eine sehr grundlegende Tatsache, die sie überprüfen, während sie die Welt häkeln: Egal wie talentierte Riesenmodelle mit Silicon Valley Outlets sind, die Arbeit wird anders, wenn es um Englisch geht. Die meisten von uns haben die seltsamen Übersetzungs-Kochan-Phrasen bemerkt, die bei der Arbeit mit diesen Modellen zusammengestellt werden, bedeutungslos von Idiomen oder einfach nur ein einfaches technisches Problem an einen unnötigen Ort erweitern. Hier sind zu diesem Zeitpunkt inländische Projekte der künstlichen Intelligenz zu einer technischen Verpflichtung geworden, nicht nur ein nationaler Stolz.
Heute ist das in der Türkei entwickelte KI-Ökosystem keine einfache Schnittstelle vor OpenAI oder Anthropic Modellen. Eine starke Infrastruktur wird mit dem Beitrag von Open-Source-Communities aufgebaut, die mit ihren eigenen Gewichten ausgebildet sind und sich direkt auf die hochmoderne Struktur des Türkischen konzentrieren.
Wie Denersin?
Eine kurze Tabelle zuerst: wie Sie heute auf dieses Modell zugreifen können und ob das Modell eingeschaltet ist (14.10.2026).
Zuhause | Entwickler | Wie kann man darauf zugreifen? | Outdoor/Indoor |
|---|---|---|---|
Nachrichten | TUBITAK | Noch nicht für den allgemeinen Gebrauch geöffnet; für Pilotprojekte © Copyright 2018. Alle Rechte vorbehalten. über TUBITAK TICKET | Schließen |
Kumru | VNGRS | Zuhause Kumru-2B Hugging Face | 7,4B aus, 2B offen (Apache 2.0) |
T3A | T3 Foundation und Baykar | Eröffnet als Beta auf der TEKNOFEST Social Platform am 11.07.2025 | Open-Source-Ziel; nicht geteilt das herunterladbare Gewicht |
Trendyol LLM | Zuhause | Hugging FaceHerunterladen | Außengewicht |
Zuhause | Bosporus-Universität TABILab |
Hugging FaceHerunterladen
Offene, nicht kommerzielle akademische Nutzung allein m
Zuhause
Zuhause
Privat für Institutionen, Plattform in Institution eingebaut
Schließen
Warum sind globale Modelle noch nicht?
Während globale KIs mit Trilyons trainiert werden, besteht ein kleiner Teil dieser Daten aus Türkisch. Diese Situation bringt zwei große Probleme mit sich:
Token Waste und High Billing:
Token-Systeme, die nach Englisch entworfen wurden, können die Wurzel und zusätzliche Logik des Türkischen nicht lösen. Ein einfaches Wort teilt 3-4 Stücke (Token). Dies fügt beide API-Nutzungsrechnungen hinzu und verlängert die Reaktionszeit des Systems in bar.
Kultureller und rechtlicher Kontext:
Es ist ziemlich riskant, eine dem türkischen Handelsgesetzbuch eines globalen Modells entsprechende Vertragsanalyse durchzuführen oder die Beschwerde des Kunden mit dem richtigen Gefühl zu klassifizieren. Weil das Modell westliche Kultur und amerikanische Rechtslogik als Standard verweist.
Um dieses Defizit zu schließen, konzentrierte sich die Akademie auf die Entwicklung türkischer Modelle der künstlichen Intelligenz durch die Kombination öffentlicher und unabhängiger Initiativen in der Türkei.
Was funktioniert auf der Website? Featured Native Models
Künstliche Intelligenz Projekte in der Türkei Home; reagiert auf unterschiedliche Bedürfnisse von staatlich unterstützten Großinfrastrukturen bis hin zu agilen Lösungen.
1. BİLGE: Umfangreiche Sprachmodellfamilie von TÜBİTAK
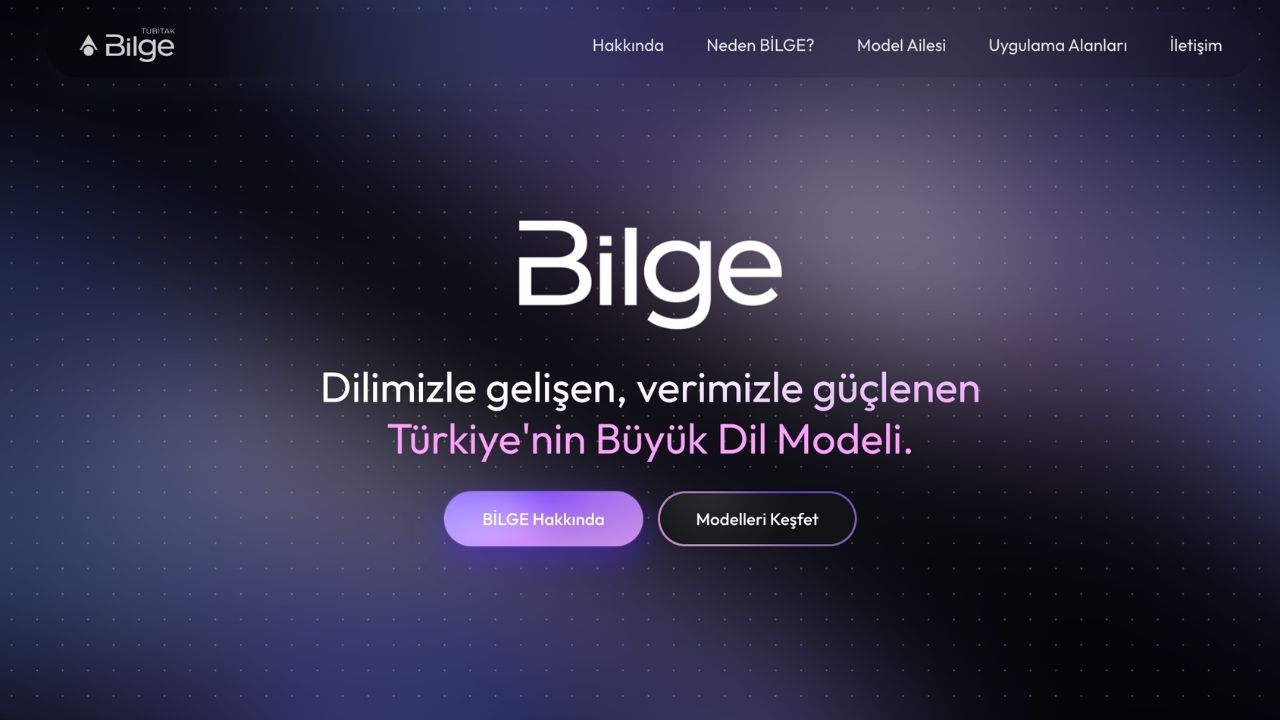
Der konkreteste und umfassendste Schritt auf öffentlicher Seite wird von TÜBİTAK BİLGEM umgesetzt Nachrichten Das Projekt war es. Der größte Anspruch von BİLGE ist, Türkisch als Muttersprache zu verwenden, ohne aus einer anderen Sprache zu übersetzen.
Verschiedene Größen für unterschiedliche Bedürfnisse:
BİLGE ist kein einzelnes Modell, eine Familie. Mit 1B, das für Mobil- und Endgeräte entwickelt wurde, wurde die Leistungs- und Effizienzbalance von 9B auf Kratzer trainiert. BİLGE 27B wurde mit der Continuous Pre-Training-Methode mit türkischen Daten entwickelt. Konzipiert für komplexe Denkaufgaben, befindet sich BİLGE 122B noch in der Entwicklungsphase.
Devasa Englisch Korpus:
Das Training begann mit etwa 1 Billion Vokabular rohen türkischen Datenpool. 250 Milliarden hochwertige Token wurden aus diesem Pool ausgewählt und die Daten wurden mit 500 Milliarden synthetischen Daten angereichert. Ziel ist es, die Idiome, Anwendungen und technischen Begriffe des Modells im türkischen Kontext zu erfassen.
Niedrige Energie & Kosten:
Es zielt darauf ab, weniger Rechenleistung auszugeben, weil es ein Token verwendet, das für das Türkische geeignet ist. Öffentliche Institutionen sind für Unternehmensanwendungen konzipiert, bei denen die Datensicherheit von entscheidender Bedeutung ist.
Zugangsstatus: Ab 14.10.2026 ist BİLGE nicht für den allgemeinen Gebrauch geöffnet. Für Pilotprojekte gemäß der offiziellen Website kann TUBITAK TICKET kontaktiert werden. Zugangsbezogene Ankündigungen wurden nur über die offiziellen Kanäle von TÜBİTAK mit dem Ministerium für Industrie und Technologie angekündigt.
2. 2. Kumru AI: Schnell, fokussiert und leicht
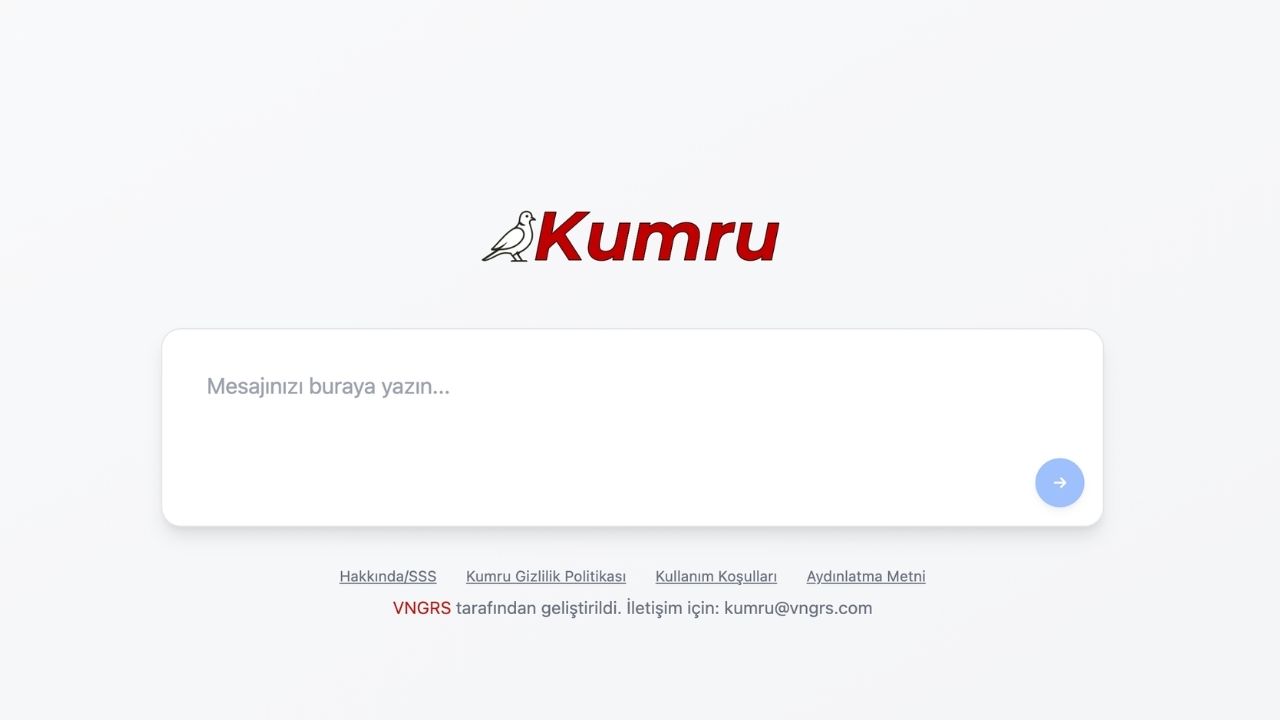
In der Welt des Wagnisses konzentrieren sich Modelle auf Funktionalität, anstatt in das riesige Parameterrennen einzusteigen. von Kumru AI, Eine türkische LLM-Alternative, die Unternehmen auf ihren Servern betreiben können, ohne riesige Budgets auszugeben.
Textabstraktion, Kategorisierung der Kundenanforderungen und Aufbau eines natürlichen türkischen Dialogs Sehr erfolgreiches Modellbietet eine hohe Ablenkungsgeschwindigkeit, ohne Hardwareressourcen zu entfernen.
VNGRS Kumru 7,4 Milliarden Parameter und kann auf einer GPU mit 16 GB VRAM arbeiten. Zuhause Sie können die Demo darauf ausprobieren; Mit 2 Milliarden Parametern ist der Kumru-2B mit Apache 2.0-Lizenz in Hugging Face geöffnet. Für technische Details und Grenzen Kumru AI guide News Siehe.
3. T3 AI: Open Source und Community Power
Die in Baykar entwickelte T3 AI mit der Turkish Technology Team Foundation (T3 Foundation) stellt die Gemeinschaftsgröße der Arbeit dar. In Modell 11.07.2025 wurde TEKNOFEST für die Verwendung mit der Beta-Version in der Social Platform geöffnet. Während der Ankündigung wurde angekündigt, zum Projekt von 1.792 Freiwilligen aus 67 Provinzen beizutragen.
Das Projekt sagt, es wurde als Open Source entwickelt; aber die Anzahl der Parameter und Modellgewichte wurden noch nicht geteilt, wo sie heruntergeladen werden sollten. Wenn die Gewichte geöffnet sind, kann es leicht sein, spezielle Modelle in Bereichen wie Recht oder Medizin zu trainieren.
4. Akademische Wirbelsäule und Outdoor-Gewichtsinitiativen
Das Ökosystem in der Türkei ist nicht nur auf drei Namen beschränkt:
Trendyol LLM:
Die erste Version von Trendyol LLM wurde mit 10 Milliarden Token auf dem LLaMA 2 7B-Modell von Meta trainiert. Die nächsten Versionen Qwen 2.5 7B bestanden Qwen 3 8B und Gemma 3 12B Basen. Trendyol-LLM-Asure-12B, das im Februar 2026 geteilt wurde, kann auch für E-Commerce-Aufgaben wie Abstraktion, Frage-Cevap funktionieren und eingestellt werden. Modelle werden hauptsächlich in Hugging Face geteilt.
TOURNA:
TURNA, entwickelt von TABILab in der Boğaziçi University Computer Engineering Department, ist ein 1,1 Milliarden Parameter-Encoder basierend auf UL2 Frame, ein türkisches Sprachmodell. Entwickelt für das Verständnis und Textgenerierung Aufgaben und gemeinsam für nicht-kommerzielle akademische Forschung in Hugging Face allein.
Zemberek Heritage:
Open Source Englisch Natural Language Processing Library ZuhauseEines der Werkzeuge, die seit vielen Jahren in grundlegenden Arbeiten wie Root-Ex-Lösung eingesetzt werden.
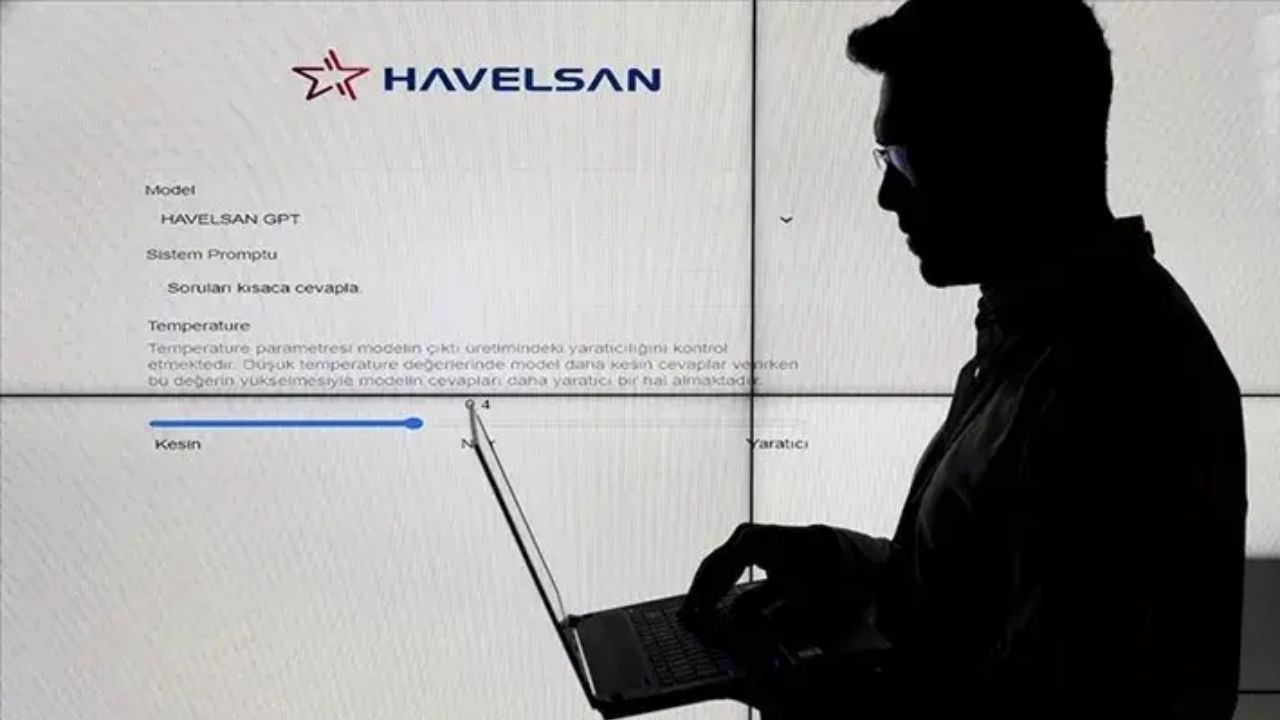
5. MAIN GPT (HAVELSAN): Native Brain of Defense und Corporate Safety
Einer der kritischsten Füße der inländischen KI-Bewegungen wird auf die Seite der Verteidigungsindustrie und der öffentlichen Sicherheit geworfen. Entwickelt zum Schutz der internen Datensicherheit und hoher Datenschutzstandards von HAVELSAN HAVELSAN MAIN GPT Es zeichnet sich als eine der Unternehmens-KI-Infrastrukturen aus, die sich von der Türkei abheben können.
Das im 01.02.2024 von HAVELSAN geförderte Root (Multi Artificial Intelligence Network) ist eine Plattform, auf der Institutionen basierend auf ihren Daten einen Assistenten für künstliche Intelligenz einrichten können. Der geschlossene Kreislauf ist so konzipiert, dass er funktioniert; der Zweck lässt die Daten nicht außerhalb der Institution. In der ersten Phase arbeitet textbasiert; Content Abstracting ist in der Lage, Informationen aus Open-Source-Daten und Code-Schreiben zu verarbeiten.
6. Aigency: Early Term Turkish Language Model Initiative Home
Şanlıurfa-basierte eCloud Software Technologies begann 2022 mit der Entwicklung Aigentitätstellt sich als eines der ersten einheimischen Sprachmodelle in der Türkei vor. Laut Nachrichten in der lokalen Presse basiert Meta auf dem LLaMA 3-Modell und konzentriert sich auf die türkische Textproduktion, Inhaltsanalyse und Unternehmenskommunikation. Eine unabhängige Bewertung des Modells wurde noch nicht veröffentlicht.
Übersicht der Modelle:
Zuhause | Entwickler | Skala/Anflug | Grundlegende Schwerpunkte | Größtes Plus |
|---|---|---|---|---|
Nachrichten | TUBITAK | 1B, 9B, 27B (122B wird entwickelt) | Public, Corporate, Digital Domination | 1 Trilyon-Wort Rohdatenpool, inländisches Altyap |
Kumru | VNGRS | 7,4B vom Kratzertraining; 2B offen | In-House (B2B) Dokumentenverarbeitung, Zusammenfassung |
Niedrige Serverkosten, schnelle Reaktionszeit
T3A
T3 Foundation und Baykar
Parameteranzahl nicht bekannt gegeben
Community Based Turkish LLM
Freiwilligendatensatz, Open-Source-Ökosystemziel
Trendyol LLM
Trendyol Tech
7B - 12B Außengewicht
E-Commerce und Kundendialog
Direkte Integration in praktische Szenarien
HOME GPT
Zuhause
Corporate & isoliertes Sprachmodell
Verteidigung, öffentliche und Unternehmensdatensicherheit
Betrieb im geschlossenen Stromkreis (vor Ort)
Aigentität
eCloud Software
Frühe Bühne Spracharchitektur
Textproduktion und Unternehmenskommunikation
Frühzeitinitiative mit Fokus auf türkische Textproduktion
Warum wichtig für Entwickler und Unternehmen?
Die Wahl eines muttersprachlichen Modells ist nicht nur die Idee von "wir unterstützen die Bodentechnologie"; direkt die Vorteile von Unternehmen, die an ihrer Tasche und ihren rechtlichen Prozessen interessiert sind:
KVKK und Datensicherheit:
Ein ernstes Kopfzerbrechen aufgrund der Regulierung einer Bank, eines Krankenhauses oder einer E-Commerce-Website, um Benutzerdaten zu erhalten und an eine API im Ausland zu senden. Lokale Modelle verlassen die Daten nicht aus der Institution, da sie direkt auf ihrem Server (on-premise) arbeiten können.
Weniger Hardware, mehr Geschwindigkeit:
Anstelle von Hunderten von Milliarden Parameter-Bulkmodellen können Sie problemlos auf einer einzelnen Mittelsegment-GPU, einem 7B- oder 14B-Kompaktmodell, das für einen bestimmten Auftrag ausgebildet ist, laufen. Deshalb sind die Server- und Stromkosten stark gesunken.
Break Out Abhängigkeit:
Globale Unternehmen für künstliche Intelligenz können die API-Preise in einer Nacht verdoppeln oder Zugangsbeschränkungen für Ihr Unternehmen einführen. Außengewichte Hugging Face native Modelle, die Sie von Plattformen herunterladen können, ermöglichen es Ihnen, Ihre Softwarearchitektur vollständig in Ihrer eigenen Kontrolle zu halten.
Mit der Öffnung nationaler Supercomputer-Ressourcen wie TRUBA und der Durchführung von Software-Erfahrungen in der Verteidigungsindustrie (ASELSAN, HAVELSAN) breitet sich die Produktion künstlicher Intelligenz in der Türkei schnell auf die Basis aus. Jetzt geht es nicht nur darum, Text zu drucken; autonome Systeme zu schaffen, die unsere einheimische Kultur und Sprache wirklich verstehen. Native models schieben auch das rückgrat dieser unabhängigkeit vollständig.
Die Zukunft mit unserem eigenen Code schreiben
Das Rennen um künstliche Intelligenz wird jetzt nicht nur daran gemessen, wer eine größere Serverfarm hat, sondern auch, wie realistisch es die lokalen Bedürfnisse dieser Technologie berührt. Die Modelle wurden in der Türkei entwickelt; Anstatt die vorgefertigten Formen zu kopieren, wird sie in einer Linie platziert, die viel mehr Füße drückt und sich darauf konzentriert, die Feinheiten der Türkei zu lösen, Datensicherheit zu bieten und die Betriebskosten von Unternehmen zu senken. Anhand der Unternehmensmacht von TICGE, Kumru AI und T3 AI zeigt dieser Punkt, dass eine unabhängige Technologieinfrastruktur, die in ihrer eigenen Sprache denkt und produziert, nicht mehr attraktiv ist. Die Zukunft mit unseren eigenen Codes zu bauen, anstatt mit den Algorithmen anderer zu konsumieren, der wichtigste Schritt, den wir im digitalen Zeitalter machen können.
Einige Unternehmen hinter diesen Modellen Türkische KI-Unternehmen, die sich im Jahr 2026 abheben Home Wir kamen in den Artikel. Für technische Details von Kumru Kumru AI Guide Schauen Sie sich Leute an, die an türkischen Sprachmodellen arbeiten Masqot Gemeinschaften Sie können sich treffen.
Autor:inDario Amodei'den Yapay Zeka Uyarısı: Sektör Yalan Söyledi
Gemini Ücretli mi? Ücretsiz Sürüm ve Tüm Planlar (2026)