Tiefenorientierte Sensitivitätsanalyse in MoE-Modellen
Automatisch übersetzt
 Admin
Große Sprachmodelle (BBD) sind entscheidend für die Aufrechterhaltung von Leistung und Effizienz, während sie jeden Tag komplexer werden. Obwohl Mixture-of-Experts (MoE)-Architekturen dieses Gleichgewicht bieten, wurde die relative Bedeutung jeder MoE-Schicht auf dem Modell nicht ausreichend verstanden. Insbesondere im Zusammenhang mit der Modellkompression (Modellkompression) fehlte es an einer eingehenden Analyse. Eine neue Studie, die im August 2026 veröffentlicht wurde, bietet eine umfassende schichtbasierte Präzisionsanalyse des Qwen3.6-35B-A3B-Modells, indem sie diese Lücke schließt und einen bedeutenden Schritt für die zukünftige Optimierung von BBDs unternimmt.
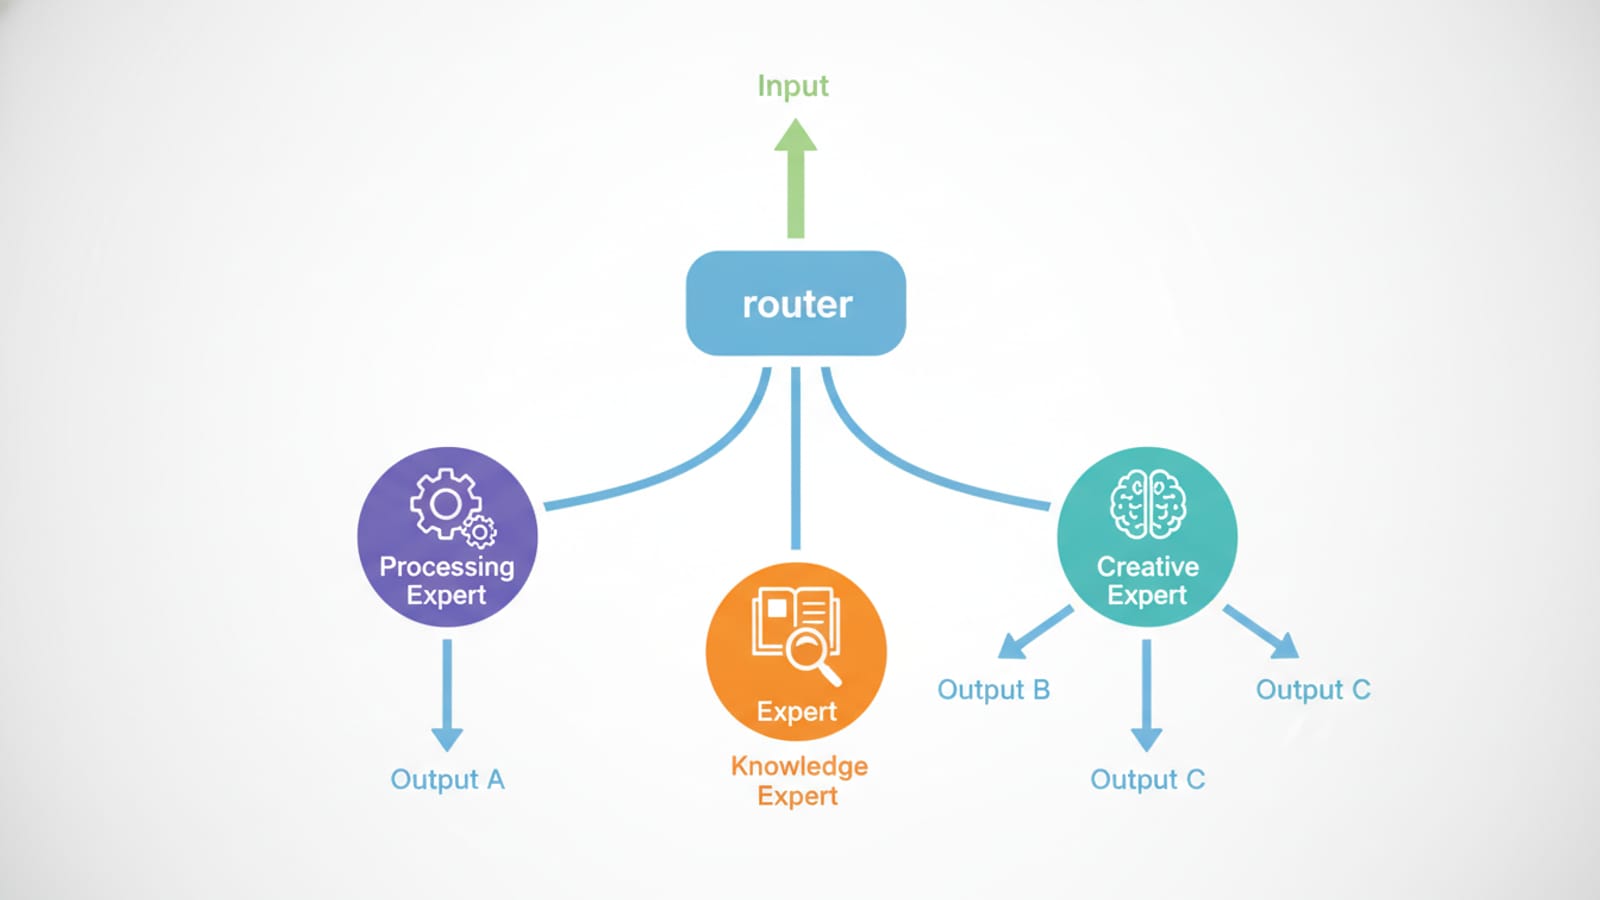
Was ist eine Tiefen-orientierte Sensitivitätsanalyse in MoE-Modellen?
"Derinlik Oriented Sensitivity Analysis ist eine Methodik, die systematisch die Auswirkungen verschiedener Schichten von Mixed-of-Experts-Modellen (MoE) und Experten in diesen Schichten (Experten) auf die Gesamtleistung des Modells untersucht." Der Zweck besteht darin, die Möglichkeiten zur Erstellung kleinerer oder schnellerer Modelle ohne Leistungsverlust zu erkunden, indem festgestellt wird, welche Teile des Modells kritischer sind. Diese Analyse zeigt ihre Bedeutung für komplexe MoE-Strukturen wie Qwen3.6-35B-A3B, basierend auf Gewichtswerten (Magnituden) jeder Schicht und jedes Spezialisten.
Mixture-of-Experts (MoE) Architektur und Arbeitsprinzip
MoE ist eine innovative Struktur, die ein großes Modell der künstlichen Intelligenz in mehrere kleine, spezialisierte Subnetzwerke (Coman-Netzwerke) unterteilt. Jede Eingabe (z.B. ein Textstück) wird über einen Redirect-Mechanismus (Router) nur an die relevantesten Fachnetzwerke geleitet. Der Ansatz dieser seltenen Aktivierung (sparse Aktivierung) erhöht die Gesamtzahl der Parameter des Modells, erhöht nicht die Berechnungskosten proportional. Traditionell (absichtlich) bietet geringere Berechnungskosten und eine schnellere Ausbildung / Körnung auf 70% als BBDs. Zum Beispiel das Qwen3.6-35B-A3B-Modell, 40 MoE-Schicht, 256 Experten pro Schicht und hat die "Top-8-Routing" -Struktur, in der die besten 8 Experten für jeden Token ausgewählt werden. Experten sind oft auf feinkörnigere Jobs wie sprachliche Prozesse oder sinnvolle Aufgaben spezialisiert.
Bedeutung der Kompression in großen Sprachmodellen (BBD)
Heute zeigen BBDs unglaubliche Talente, indem sie Milliarden von Parametern erreichen. Diese Größe verursacht jedoch hohe Berechnungs-, Energie- und Speicherkosten, die die Verteilung von Modellen in realen Anwendungen ermöglichen. Modellkompressionstechniken sind entscheidend, um diese Herausforderungen zu lindern und sicherzustellen, dass BBDs mit weniger Ressourcen effizienter arbeiten. Zu den wichtigsten Kompressionsverfahren gehören:
Quantumisierung (Quantisierung): Geringere Präzision Datentypen von Parametern (z.B. Die Modellgröße und -geschwindigkeit wird durch die Umwandlung von FP16 in INT-8 verbessert.
Budama (Beschneidung): Weniger wichtige Parameter oder Verbindungen im Modell werden dauerhaft entfernt. Dies reduziert die Komplexität und Ressourcenauslastung des Modells.
Informationsdestillation (Knowledge Distillation): Das Wissen eines größeren "Studenten" -Modells wird durch Komprimierung durch Übertragung auf ein kleineres "Studenten" -Modell bereitgestellt.
Sensitivitätsanalyse und Magnitudenbasierte Expertenmaske g
Der Artikel zielt darauf ab, zu bestimmen, welche MoE-Schichten oder Experten den größten Einfluss auf die Modellleistung für die schichtbasierte Präzisionsanalyse, Modellkompression und Leistungsoptimierung haben. Diese Arten von Analysen sind wichtig, um die interne Funktionsweise des Modells zu verstehen und die wichtigsten Komponenten zu erkennen. Der Ausdruck "Magnitude-Based Expert Masking" bezieht sich auf eine Verschmierungs- oder Analysetechnik, die das Maskieren oder Deaktivieren von weniger wichtigen umfasst, indem die Bedeutung von Gewichtswerten nach der Größe der Experten bewertet wird. Dieser Ansatz ist eine Möglichkeit, das aktuelle Merkmal der Stille in MoE-Modellen zu optimieren oder mehr Verdünnung zu erzeugen.
Sektoraler Kontext: Qwen3.6-35B-A3B und MoE Nutzung
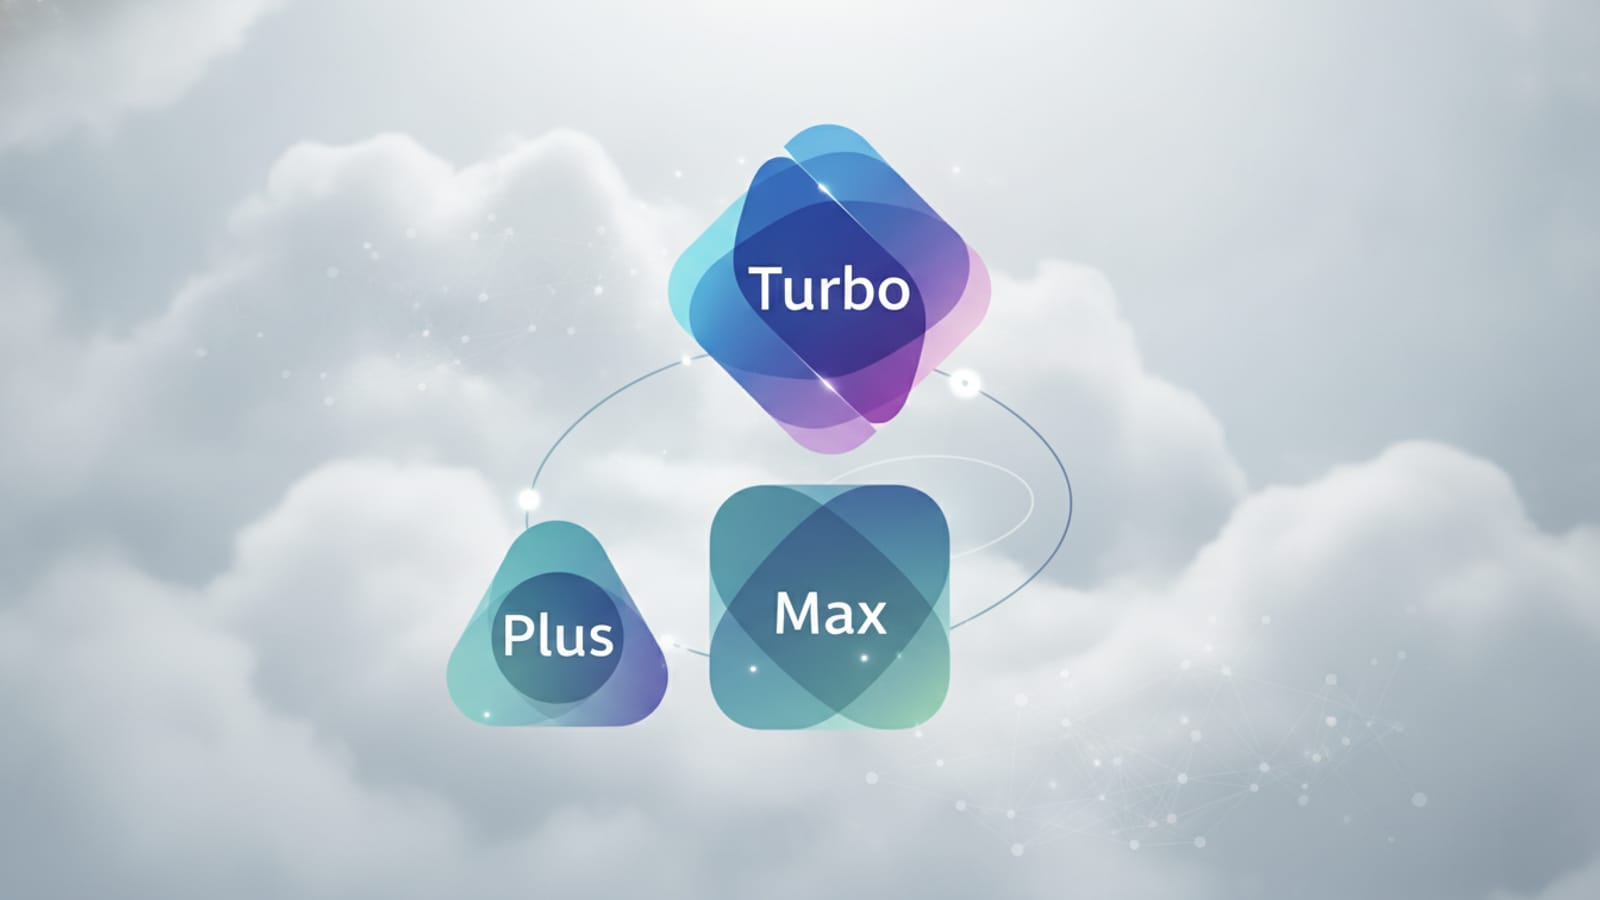
Das von Alibaba Cloud analysierte Qwen3.6-35B-A3B-Modell ist Mitglied der von Qwen entwickelten großen Sprachmodellfamilie von Qwen (Tongyi Qianwen). Die Qwen-Familie baut auf Transformer-basierten Architekturen auf und wird besonders durch ihre mehrsprachigen Fähigkeiten erkannt, insbesondere durch ihre starke Leistung in chinesischen und englischen Sprachaufgaben. Diese Variante mit 35 Milliarden Parametern des Modells enthält 40 MoE-Schichten und 256 Experten pro Schicht. Qwen-Modelle haben unterschiedliche Größen und Leistungsstufen wie Max, Plus und Turbo. MoE-Architektur wird jetzt in führenden Modellen wie Mixtral 8x7B von Mistral AI, Grok-1 von xAI, DeepSeek-V3 und Databricks verwendet.
Was ist die Gemeinschaft
Unterstützer
Den Befürwortern von Mixed-of-Experts (MoE) wird die Berechnungseffizienz und das Skalierbarkeitspotenzial hervorgehoben, das diese Strukturen nach traditionellen intensiven Modellen bieten. MoEs machen Modelle mit Trilyonen noch überschaubarer und bieten schnellere Trainings- und Nutzungszeiten. Auf diese Weise öffnet sich eine breitere Palette von größeren und talentierten BBDs.
Nachrichten
Einige Experten und Kritiker achten auf die Komplexität und Feinheiten der MoE-Modelle. Der korrekte Betrieb des Routingmechanismus (Routers) stellt eine anspruchsvolle technische Herausforderung dar, um sich effizient auf die Experten zu spezialisieren und das gesamte Modell zu optimieren. Auch die seltene Struktur von MoE-Modellen kann in einigen Hardware-Architekturen zu voller Effizienz führen.
Häufig gestellte Fragen
Warum sind MoE-Modelle so beliebt?
MoE-Modelle sind vor allem wegen der Fähigkeit, effiziente Modelle im Bereich der großen Sprachmodelle (BBD) in Bezug auf hohe Leistung und Berechnung zu erstellen, beliebt. Dank der Aktivierung des Kreuzes ermöglichen sie Milliarden von Parametern, mit weniger Ressourcen zu arbeiten und schnell zu entfernen.
Warum ist Modellkompression kritisch für BBDs?
Die Modellkompression ist entscheidend, um die hohen Berechnungs-, Speicher- und Energiekosten der heutigen riesigen BBDs zu reduzieren. Diese Techniken ermöglichen es Modellen, auf kleineren Geräten (z. B. Mobiltelefonen) zu arbeiten, und helfen künstlicher Intelligenz, ein breiteres Publikum zu erreichen, indem sie die Vertriebskosten senken.
Qwen3.6-35B-A3B welche Eigenschaften?
Qwen3.6-35B-A3B ist ein großartiges Sprachmodell der Qwen-Familie von Alibaba Cloud. Diese Variante mit 35 Milliarden Parametern ist für besonders effiziente und mehrsprachige Aufgaben mit Features wie 40 Mixture-of-Experts (MoE) Layer, 256 Experten pro Layer und "Top-8 Routing" konzipiert.
Was bedeutet Magnitude-Based Expert Masking?
Magnitude-Based Expert Masking ist eine weniger wichtige Technik für temporär oder dauerhaft deaktivierte Spezialisten, die die Bedeutung von Experten in MoE-Modellen nach der Größe der Gewichtswerte bewertet. Diese Methode hilft festzustellen, welche Experten in Modellkomprimierungs- und Optimierungsprozessen übertragen oder priorisiert werden können.
Die Zukunft großer Sprachmodelle wächst nicht nur, sondern gestaltet sie auch so, dass sie intelligenter und effizienter werden. Tiefenorientierte Präzisionsanalysen in MoE-Modellen können ein wichtiger Meilenstein auf diesem Weg sein. Das Verständnis des Leistungsbeitrags jeder Schicht und jedes Spezialisten sucht nach neuen Türen für Entwickler, um agilere, stärkere und nachhaltigere KI-Systeme zu entwickeln. Diese Forschung bietet wichtige Informationen, um die Integration von Technologien der künstlichen Intelligenz in unser tägliches Leben zu beschleunigen.
AdminABD Özel Şirketlere Siber Operasyon Yetkisi Verdi
Yapay Zeka Mühendisliği Olan Üniversiteler 2026