Warum kennt künstliche Intelligenz falsche Informationen?
Automatisch übersetzt
 Autor:in
In der Forschung mit großen Sprachmodellen (LLM) können Antworten in Workflows oder täglichen Lernprozessen sehr kompetent, fließend und überzeugend gesehen werden. Wenn jedoch der gegebene Text im Detail untersucht wird; Eine in der Quelle gezeigte akademische Studie kann ergeben, dass die Gerichtsentscheidung oder das historische Ereignis völlig fiktiv ist.
Diese Situation bringt eine kritische Frage an die Nutzer: Macht KI Fehler, ist künstliche Intelligenz zuverlässig?
Künstliche Intelligenz-Tools sind keine Kombination aus Genauigkeitskontrollmechanismus oder einer klassischen Suchmaschine. Die Kenntnis der Arbeitsprinzipien hinter diesen Systemen macht es einfacher, die Frage zu beantworten, was eine Halluzination künstlicher Intelligenz ist und die Ergebnisse der richtigen Siebe zu übergeben.
Was ist künstliche Intelligenz?
Künstliche Intelligenz Halluzinationen in der Technikliteratur; es ist die Bedingung, dass ein Modell der künstlichen Intelligenz in der Realität nicht existiert, logisch grundlegende oder verbal falsche Informationen sind äußerst zuversichtlich, konsistent und fließend mit einer Narration realisiert.
Anders als die Vernunft in der menschlichen Psychologie ist der Prozess hierin keine bewusste Illusion oder absichtliche Täuschung. Das Modell bricht vollständig von der Fallrealität ab, während es mathematisch das logischste Wortfeld konstruiert.
IBMs künstliche Intelligenz Halluzinationen Analyse Home im Rahmen; diese Modelle können das Falsche nicht mit dem Rechten wie im menschlichen Geist unterscheiden. Systeme berechnen nur, welche Satelliten auf die Bilder von Bildungsdaten (Muster) und füllen die Lücken durch die "Verwandlung" (Spiegel), wenn sie auf die Informationslücke stoßen. Im Falle eines Anwalts, der 2023 in den USA mit ChatGPT vorbereitet wurde, wurde das Modell identifiziert, dass die nicht vorhandenen Einsichten, Dateinummern und gefälschten Urteilsentscheidungen nicht realisiert werden. Da das Modell die Struktur realer Gesetzestexte unvollkommen imitiert, wurde der auf den ersten Blick erschienene gefälschte Text nicht unterschieden.
Unterschied zwischen künstlicher Intelligenz und gewöhnlichem Fehler
Jede falsche Reaktion auf künstliche Intelligenz wird nicht in der Halluzinationskategorie bewertet. Eine alte Population eines Modells ist im Rahmen des "kurzen Fehlers", die Informationen der Sprache in der Übersetzung anzugeben oder in einer technischen Berechnung widerzuspiegeln. Gewöhnliche Fehler können meist durch eine fehlende Daten- oder Transaktionsregel im Bildungssatz verfolgt und korrigiert werden.
Halusination ist das, obwohl es keine echten Daten auf dem Boden des Modells gibt und es mit einem präzisen Realitätston liefert. Dies macht die Erkennung von Halluzinationen viel schwieriger als gewöhnliche Fehler.
Warum kennt künstliche Intelligenz falsche Informationen?
Erstens, um zu verstehen, dass künstliche Intelligenz falsche Ausgaben erzeugt Grundlagen und Entwicklungsprozess der Künstlichen Intelligenz Sie müssen es wissen. Wenn die Modelle grundsätzlich verstanden werden, dass es eine Ein-Daten-Verarbeitungs- und Wahrscheinlichkeitsberechnungsarchitektur gibt, ist auch die Logik der Fehleranteile klar:
1. Statistische Prognose und möglicher Manik
Große Sprachmodelle arbeiten mit dem Prinzip der Vorhersage des nächsten Wortes (Token). Modell, "Dies ist das wahrscheinlichste, um zu welchem Wort statistisch nach dem Ausdruck zu kommen?" konzentriert sich auf die Beantwortung der Frage. Die sachliche Genauigkeit des Prioritätssatzes für das Modell ist nicht die Sprachstruktur und in Bezug auf den Bedeutungskern. Bei der logischen Ausführung tritt beim Überdachen eine statistische Wahrscheinlichkeit auf.
2. 2. Perfekte, instabile oder über Satellitisierte (überholende) Trainingsdaten
Modelle werden durch das Scannen von offenen Ressourcen, Artikeln und digitalen Texten in der Internetumgebung trainiert. Die falschen Informationen im Bildungspool werden als allgemeine Regeln nach dem Modell von Vorurteilen oder widersprüchlichen Aussagen übernommen. Darüber hinaus verliert das Modell, wenn es sich an die Bildungsdaten anpasst (Overfitting), die Fähigkeit, falsche Verbindungen durch regellose Korrelationen zu verallgemeinern und herzustellen.
3. Überwindung der Compliance bei Benutzereingaben
Beim Erstellen von Modellen werden sie so optimiert, dass sie eine ununterbrochene Reaktion auf den Befehl des Benutzers (Prompt) bieten. Anstatt zu erwähnen, dass es am häufigsten nicht bekannt ist, wird der Benutzer antworten, indem er die Genauigkeit des Problems akzeptiert. Zum Beispiel, wenn eine grundlegende oder fiktive Frage gerichtet wird, anstatt die Modellfrage abzulehnen, schreibt ein fiktives Szenario, das der Annahme des Problems entspricht.
4. Sicherheit im Freien und Manipulationen mit schlechten Zwecken (schnelle Injektion)
Künstliche Intelligenz produziert falsche oder irreführende Informationen ist nicht immer auf den Mangel an Bildung des Modells zurückzuführen. Auch die Manipulationen von außen können Halluzinationen auslösen. Mit feindlichen Angriffstechniken wie "Prompt"-Injektion können die Sicherheitsschichten des Modells manipuliert werden und sicherstellen, dass das System vollständig fiktive, geführte oder schädliche Ausgänge erzeugt. Um die Fragilität und Abwehrmechanismen gegen solche Eingriffe von Systemen der künstlichen Intelligenz zu verstehen Was ist KI-Sicherheit und kann hacken sollte umfassend angegangen werden. Sicherheitsfilter verschwinden schnell die Konsistenz von Informationen in Modellen, die gelöscht oder manipuliert werden.
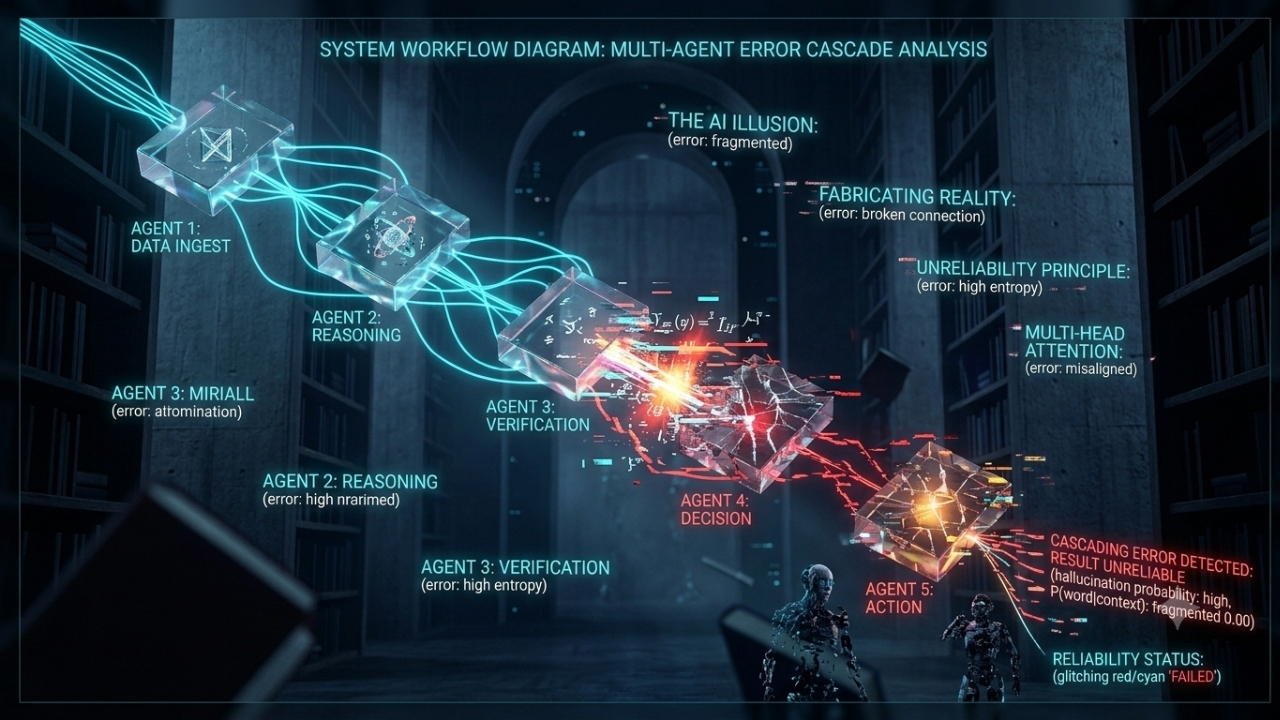
5. Zunahme von Fehlern in mehreren Agentensystemen (Kaskadierungshalluzinationen)
Heute arbeiten autonome Agenten der künstlichen Intelligenz in verketteten Workflows zusammen. Eine einzelne Halluzination, die vom ersten Agenten erzeugt wird, gilt als Tatsache, die von den nächsten Agenten verifiziert wird, und wird in die Entscheidungsprozesse einbezogen, sie wächst, indem sie operative und rechtliche Risiken hinzufügt.
ChatGPT Fehler Dos, ist das tägliche Leben zuverlässig?
Alle produktiven Systeme der künstlichen Intelligenz wie ChatGPT und so weiter können regelmäßig Fehler sein.
Die Textbearbeitung ist in Bereichen wie Ideenentwicklung, Erstellung von Codevorlagen, Sprachübersetzung und Zusammenfassung grundlegender Konzepte sehr effizient. Es ist jedoch wichtig zu wissen, wie die technischen Einstellungen wie Temperatur (Temperatur) oder Kugel p die Ausgangsqualität des Systems verbessern und die Zufälligkeit steuern. Erweiterte Skriptstrukturen, um die Konsistenz der vom Modell erhaltenen Befragten zu erhöhen und Würfel zu kontrollieren, die wieder fallen ChatGPT versteckte Codes und Parameter Home über zugegriffen werden kann.
In diesen Bereichen, die einen direkten Entscheidungsmechanismus erfordern, sollten die Ergebnisse künstlicher Intelligenz als endgültige Quelle bewertet werden:
Medizin und Gesundheit: Das Risiko, falsche oder spekulative Informationen über Dosierung, Symptome und Diagnose zu produzieren, ist hoch.
Gesetz: Wir können Nicht-Okklusionsgesetze oder gefälschte Einsichten produzieren.
Akademische Studien: Nicht vorhandene Schweißer, passende Schreiber und gefälschte DOI-Nummern sind die häufigsten Arten von Halluzinationen.
Finanzen: Es kann durch unbestätigte Markt- und Unternehmensdaten irreführend sein.
Methoden zur Verringerung des Halusinationsrisikos
Es kann mit den richtigen Nutzungstechniken minimiert werden, wenn es nicht möglich ist, den Fehleranteil der künstlichen Intelligenz vollständig zurückzusetzen. Ansätze wie Rollenerkennung, schrittweises Denken und Kontextbegrenzung bei der Minimierung des Inhalationsrisikos, grundlegende prompte technische Techniken Home direkt verbunden mit.
Strategie | Zweck | Sample Command Approach |
|---|---|---|
Rolle und Rahmenbestimmung | Der Spekulationsbereich ist eng. | " Antworten Sie im Rahmen der korrigierten resmî Gesetzgebung. " |
Unbekannte Anweisung melden | Verhindert Anpassen Reflex. | "Wenn Sie nicht sicher sind, ob Sie nicht sicher sind, Vorhersagen zu machen, geben Sie an." |
Welding Review und Kontextur | Löscht die Datenbankgrenzen. |
"Wenn Sie sich an den Text im Text halten, beantworten Sie die Fragen dazu."
Schritt Mental Execution
Erhöht die logische Konsistenz.
"Mit den Schritten, denen du folgst, bevor du im Moment ankommst."
Können Sie das Halusinationsproblem beheben?
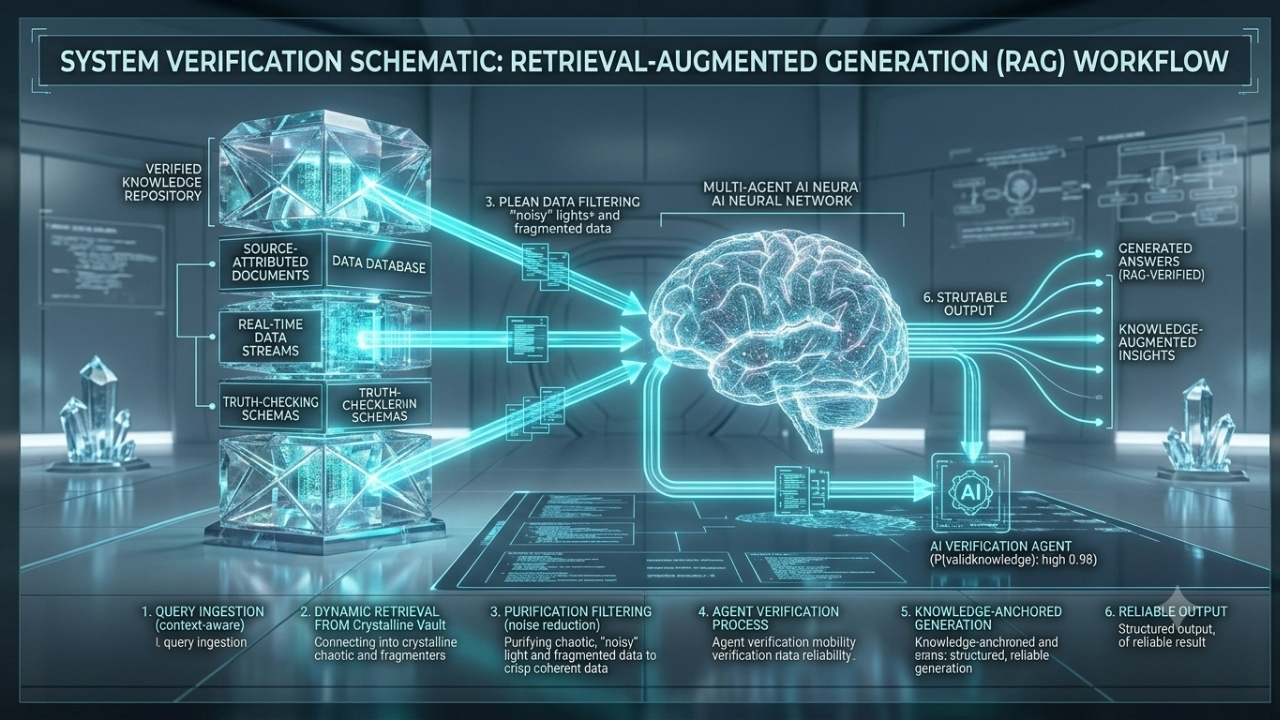
Um die Zuverlässigkeit von Modellen künstlicher Intelligenz zu verbessern und das Halluzinationsrisiko zu minimieren, werden intensive F&E-Studien sowohl in der akademischen Welt als auch in Technologieunternehmen durchgeführt. Heute zeichnet sich die gängigste und funktionalste architektonische Lösung in diesem Bereich als RAG (Retrieval-Augmented Generation / Repurified Production) aus. Das Sprachmodell in der RAG-Methode wird auf zuverlässige externe Informationsquellen angewendet, wie z. B. die direkte Verknüpfung der Taille mit den potenziellen Übereinstimmungen in ihrem geschlossenen parametrischen Speicher; sofortige Unternehmensdatenbanken abfragen, aktuelle Webverzeichnisse oder verifizierte resmî-Dokumente. Nachdem er die relevanten Rohdaten aus diesen Quellen zurückgezogen hat, konfiguriert er die Antwort, indem er seine erweiterte Sprachsynthesefähigkeit aktiviert. Somit wird der "Füllraum" -Reflex des Modells weitgehend kontrolliert und die Informationen werden auf einer verifizierten Basis platziert.
Neben der RAG-Architektur erhöht die neue Generation von Bildungstechniken, die über logische (Vernunft-)Schritte von Modellen transparent sind, das Feedback-Konsolidationslernen (RLHF - Reinforcement Learning from Human Feedback) und die automatischen Genauigkeitsfilter, die die Betreuer der künstlichen Intelligenz aktivieren, schrittweise ihre Genauigkeitsraten. Darüber hinaus werden die Mechanismen der Selbstproduktion (Selbstkorrektur), die Modelle ihre interne Logik testen, bevor sie die Antwort erzeugen, in das System integriert.
Trotz all dieser technologischen Fortschritte basieren die bestehenden großen Sprachmodelle im Wesentlichen auf der Vorhersage eines semantischen "Aning" oder "Coaching"; das statistische Token (kelime / hece) auf riesigen Datensätzen. Bei diesen möglichen Motoren, die mathematisch arbeiten, ist eine Nullfehler- oder absolute Genauigkeitsgarantie theoretisch nicht möglich. Die neu entwickelten Methoden setzen die Halluzinationsrate nicht zurück, sondern können nur erkannt, begrenzt und in einen überschaubaren Partner gezogen werden.
Künstliche Intelligenzsysteme sollten als unterstützende Assistenten positioniert werden, nicht als absolute Informationsbehörde oder der richtige Mechanismus; komplexe Arbeit beschleunigen, aber immer vom menschlichen Filter (Human-in-the-Loop) und kritischen Gedankenfilter genommen werden müssen.
Autor:inGemini Ücretli mi? Ücretsiz Sürüm ve Tüm Planlar (2026)
KVKK ve Yapay Zeka: Şirketler Ne Yapmalı?