Was ist Data Mining, warum wichtig? Methoden und Proben
Automatisch übersetzt
 Creator
Ja, Data Mining ist auch heute wichtig: Entscheidungen wie Betrugserkennung, Nachfrageprognose, Kundensegmentierung und Empfehlungssysteme durch das Aufdecken von Mustern und Beziehungen in großen Datenstapeln. Statistik verwendet maschinelles Lernen und Datenbankmethoden zusammen; Der Zweck besteht darin, Daten aus Daten zu entfernen, nicht die Daten selbst. Wenn Sie mit personenbezogenen Daten arbeiten, müssen Sie KVKK in der Türkei einhalten.
Letzte Aktualisierung: 23.10.2026
1. Was ist Data Mining?
Data Mining ist der Analyseschritt des „Information Discovery (KDD)-Prozesses in den „Daten: Die Formen in großen Datensätzen finden Statistiken, maschinelles Lernen und Datenbankmethoden. Der Name ist etwas irreführend; das Kratzen sind nicht die Daten selbst, sondern die Informationen in den Daten. Der Unterschied zur klassischen Datenanalyse ist die Suche nach unbekannten Formen, anstatt eine vorinstallierte Hypothese zu testen.
1.1. Zwecke des Data Mining
Deskriptive Analyse: Um den aktuellen Status, Gruppen und Verteilungen in den Daten anzugeben.
Prognosebasierte Analyse: Schätzen Sie einen zukünftigen Wert oder eine Klasse, indem Sie vergangene Daten modellieren.
Beziehungserkennung: Finden Sie Ereignisse und Regeln zusammen gesehen (z. B. Produkte zusammengenommen).
2. 2. Data Mining
Das bekannteste Framework in der Branche ist CRISP-DM, das 1996 entworfen und 1999 veröffentlicht wurde. Es besteht aus sechs Phasen und ist üblich, zwischen den Phasen zurückzukehren:
CRISP-DM-Stufe | Was tun? |
|---|---|
Business verstehen | Die Geschäftsfrage und die Erfolgskriterien werden festgelegt. |
Daten verstehen | Datenquellen werden gesammelt, erste Entdeckung und Qualitätskontrolle durchgeführt. |
Aufbereiten von Daten | Reinigung, Spleißen, Umwandlung; oft die Zeit-Raum-Stufe. |
Modellierung | Methoden wie Klassifikation, Clustering, Regression werden angewendet. |
Überprüfungen | Es wird kontrolliert, dass das Ergebnis die Geschäftsfrage nicht wirklich beantwortet. |
Empfangsschaltung | Modell oder Befunde werden zum Bericht, Board oder Produkt transportiert. |
Die folgenden Schritte sind das praktische Äquivalent dieses Verfahrens:
2.1 Datenerfassung
Die Datenerfassung ist der erste Schritt des Data Mining. In diesem Stadium werden Datenquellen ermittelt und Daten gesammelt. Die Datenquellen können Folgendes umfassen:
- Datenbanken
- Websites
Social Media Plattformen
- Umfragen und andere Forschungsmethoden Home
2.2. Vorläufige Datenverarbeitung
Die gesammelten Daten sind in der Regel roh und unregelmäßig. Datenvorbehandlung ist der Prozess, bei dem Daten für die Reinigung, Umwandlung und Analyse geeignet sind. Diese Phase umfasst:
- Ausfüllen fehlender Daten
- Erkennung und Korrektur von Aggregatwerten
- Normalisierung der Daten
2.3. Datenanalyse Home
Die Datenanalyse ist die kritischste Phase des Data Mining. In diesem Stadium werden Daten mit verschiedenen Techniken und Algorithmen analysiert. Gemeinsame Methoden umfassen:
- Klassifizierung: Die Daten werden in bestimmte Kategorien unterteilt.
Clustering: Es dient dazu, Daten mit ähnlichen Merkmalen zu gruppieren.
- Regression: Ein numerischer Wert (z. B. Verkaufsmenge oder Preis) modelliert die Beziehung zwischen Variablen zur Vorhersage.
2.4. Auswertung der Ergebnisse
Die Auswertung der Analyseergebnisse ist wichtig, um die Genauigkeit und Gültigkeit der erhaltenen Informationen zu kontrollieren. In diesem Stadium werden die Aussagekraft und Anwendbarkeit der Ergebnisse untersucht.
2.5. Interpretation und Berichterstattung über Ergebnisse
Die Interpretation der Ergebnisse ist der ultimative Zweck des Data Mining. Die daraus resultierenden Erkenntnisse sollen in Entscheidungsprozessen verwendet werden. In diesem Stadium werden die Ergebnisse anhand visueller Grafiken und Tabellen besser verstanden.
3. Data Mining-Methoden
Einige gängige Methoden im Data Mining sind:
3.1. Kategorie
Die Klassifizierung ermöglicht es Daten, bestimmte Klassen zu verlassen. Zum Beispiel können Klassifizierungsalgorithmen verwendet werden, um festzustellen, ob eine E-Mail-Nachricht Spam ist. Zu den gängigen Klassifizierungsalgorithmen gehören:
Entscheidungsbäume: Entscheidungsbäume bieten eine grafische Darstellung in der Baumstruktur, die den Entscheidungsprozess anhand bestimmter Datenmerkmale modelliert. Jeder Zweig stellt eine Entscheidung oder Bedingung dar, jedes Blatt zeigt eine endgültige Bedingung oder ein Ergebnis an.
Support Vector Machines (SVM) SVM ist ein Algorithmus, der darauf abzielt, eine Hyperebene zu finden, die Datenpunkte am besten unterscheidet. Diese Hyperebene ist in der Weise platziert, die verschiedene Klassen trennt, um den breitesten Bereich (Marge) zu ermöglichen.
Naive Bayes: Naive Bayes ist eine Klassifizierungsmethode, die auf Bayes teoremi installiert ist. Der Ausdruck "Naiv" (rein) kommt von der Tatsache, dass jedes Merkmal des Algorithmus unabhängig voneinander ist.
3.2. Clustering
Clustering wird verwendet, um Datenpunkte mit ähnlichen Merkmalen zu gruppieren. Diese Methode ist effektiv, um natürliche Gruppen im Datensatz zu erkunden. Zu den gängigen Clustering-Algorithmen gehören:
K-Mittel: K-Mittelwerte, Datenpunkte k Eine Anzahl von Clustern (Cluster) ist ein Algorithmus, der gruppiert ist. Jeder Satz wird durch den Durchschnitt (merkezi) von Datenpunkten in diesem Cluster dargestellt.
Collaborative Clustering: Konisches Clustering ist ein Algorithmus, der Datenpunkte, Ähnlichkeiten oder Abstände in der Baumstruktur (Dendrogramm) organisiert. Diese Methode erstellt eine Hierarchie, indem Datenpunkte in Untergruppen unterschieden werden.
DBSCAN : DBSCAN ist eine unkontrollierte Lernmethode, die Cluster erzeugt, indem Datenpunkte nach ihrer Dichte gruppiert werden. Dieser Algorithmus gruppiert Datenpunkte in diesen Bereichen, indem er dichte Zonen identifiziert und weniger dichte Zonen als Rauschen (Rauschen) auswertet.
3.3. Regression
Die Regretionsanalyse wird verwendet, um die Beziehung zwischen abhängigen und unabhängigen Variablen zu modellieren. Zum Beispiel kann eine Regressionsanalyse durchgeführt werden, um zu verstehen, wie sich der Preis eines Produkts mit der Anfrage ändert. Häufige Arten der Regression sind:
Lineare Regression
- Logistikregression (auch in Zwei-Faktor-Klassifikationen wie yes/nounce verwendet)
Polynomregression
3.4. Regeln für die Zusammenarbeit
Gemeinsam werden Regeln verwendet, um die Beziehungen zwischen Daten zu untersuchen. Zum Beispiel kann ein Kunde verwendet werden, um zu bestimmen, welche Produkte zusammen zum Kauf neigen. Der bekannteste Algorithmus in diesem Bereich ist Apriori, den Agrawal und Srikant 1994 empfehlen.
4. Data Mining-Anwendungen
Data Mining hat in vielen Bereichen unterschiedliche Anwendungsgebiete:
4.1. Einzelhandel
Im Einzelhandel wird Data Mining verwendet, um das Kundenverhalten zu analysieren, Verkaufsprognosen zu erstellen und das Bestandsmanagement zu optimieren. Zum Beispiel können Gewerkschaftsregeln verwendet werden, um zu bestimmen, welche Produkte zusammen in einem Markt gekauft werden.
4.2. Finanzsektor
Im Finanzsektor wird Data-Mining-Betrugserkennung verwendet, um Kreditrisikobewertung und Anlagestrategien zu entwickeln. Zum Beispiel können Klassifizierungsalgorithmen bei der Bewertung von Kreditanträgen verwendet werden.
4.3. Gesundheitswirtschaft
Im Gesundheitsbereich wird Data Mining zur Früherkennung von Krankheiten, zur Verbesserung von Behandlungsprozessen und zur Optimierung der Gesundheitsversorgung eingesetzt. Zum Beispiel kann Risikoanalyse durch Gesundheitsgeschichte von Patienten durchgeführt werden.
4.4. Soziale Medien
Social-Media-Plattformen profitieren vom Data-Mining, um das Nutzerverhalten zu analysieren, Content-Empfehlungen und Anzeigen-Targeting zu erstellen. Beispielsweise können Clustering-Methoden verwendet werden, um Inhaltsempfehlungen entsprechend den Interessen der Nutzer bereitzustellen.
Sie können Aufmerksamkeit erregen: 2024 Nobelpreis für künstliche Nervennetzwerke
5. Ethik und Datenschutz im Data Mining
Data Mining arbeitet oft an Daten über das Verhalten von Menschen, was das Risiko der Privatsphäre mit sich bringt. Bei der Verarbeitung personenbezogener Daten in der Türkei ist es notwendig, das Gesetz zum Schutz personenbezogener Daten (KVKK) Nr. 6698 einzuhalten: Sie müssen Daten aus offenen Einwilligungen oder anderen rechtlichen Gründen in Artikel 5 des Gesetzes sowie verarbeitete Daten verarbeiten, bis die betreffende Person beleuchtet ist (10. Klauseln) und allein ist.
5.1. Datenschutz
Private qualifizierte persönliche Daten (KVK 6. Substanz) wie Gesundheitsdaten unterliegen strengen Regeln. Wenn möglich, sagt Ihnen Anonymität oder Alias (Pseudonymisierung) deutlich, dass der Zugriff die Daten zu diesem Zweck einschränkt und sammelt. Bewahren Sie unnötige persönliche Daten auf, wenn das Modelltraining vorbei ist.
5.2 Ethikanwendung
Ethischer Gebrauch bedeutet, dass die erhaltenen Informationen nicht dazu verwendet werden, Menschen zu schaden. Wenn beispielsweise die Verzerrungen, die in früheren Daten vorhanden sind, in das Modell transportiert werden, können einige Gruppen bei Kredit- oder Rekrutierungsentscheidungen an den falschen Ort benachteiligt werden. Es ist also eine gute Gewohnheit, die Ergebnisse des Modells für verschiedene Gruppen zu überprüfen.
Schlussfolgerung
Data Mining ist weiterhin eine der wichtigsten Möglichkeiten, Daten in Entscheidungen umzuwandeln. Wenn Sie mit der richtigen Frage beginnen und einem Prozess wie CRISP-DM folgen, können Sie von großen Datensätzen profitieren. Bei der Arbeit mit personenbezogenen Daten ist es integraler Bestandteil der Arbeit, KVKK einzuhalten und Ergebnisse gegen Verzerrungen zu kontrollieren.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Data Mining und Datenanalyse?
Die Datenanalyse testet normalerweise eine vorinstallierte Hypothese oder beantwortet eine bekannte Frage. Data Mining konzentriert sich auf die Aufdeckung bisher unbekannter Muster und Beziehungen in großen Daten.
Ist es dasselbe, Maschine mit Data Mining zu lernen?
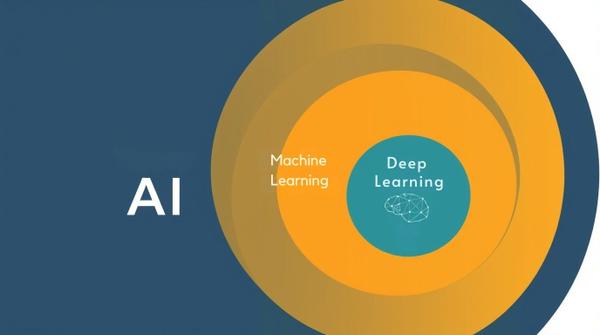
Nein, aber drinnen. Das maschinelle Lernen entwickelt Algorithmen, die aus Daten lernen; Data Mining verwendet diese Algorithmen (wie Meilenbäume, Clustering, Nervennetzwerke) zusammen mit Statistiken und Datenbanktechniken.
Welche Tools werden im Data Mining eingesetzt?
Wenn Sie den Code Python (Pandas, scikit-learn) und R schreiben, sind die häufigsten Optionen. Wenn Sie ohne das Schreiben von Code beginnen möchten, können Sie sich Open-Source-Tools wie KNIME, Orange und Weka ansehen. Um Daten zu gewinnen, müssen Sie SQL in fast jedem Projekt kennen.
Ist Data Mining legal?
Die Methode selbst ist legal; welche Daten sind wichtig. Wenn Sie personenbezogene Daten verwenden, halten Sie sich nicht an die KVKK Nr. 6698 in der Türkei, müssen Sie die Daten aus rechtlichen Gründen und den damit verbundenen Kontakten beleuchten. Überprüfen Sie die Nutzungsbedingungen dieser Website, während Sie Daten von anderen Websites sammeln.
Was sollten Sie wissen, um Data Mining zu lernen?
Grundlegende Statistiken, SQL und eine Programmiersprache (Python) sind ein guter Anfang. Versuchen Sie dann Klassifizierungs-, Clustering- und Regressionsmethoden mit einem echten Datensatz, der schneller als die Theorie lehrt.
Quelle: CRISP-DM-ProzessmodellTags Gesetz Nr. 6698
Creator2025'te Robotik Devrimi: Endüstriyel Üretimde 10 Büyük Değişim
10 Yeni Yapay Zeka Trendi: Sanatta AI’nın Yükselişi