Was ist Generative AI? Arbeitsprinzip und Modelltypen
Automatisch übersetzt
 Creator
Generative AIEs ist eine Art künstliche Intelligenz, die neue Inhalte (Text, Visual, Audio, Video oder Code) erzeugt, die Formen ähneln, die aus großen Datensätzen lernen. Klassische künstliche Intelligenz klassifiziert oder prognostiziert oft einen Wert; produktive künstliche Intelligenz schafft einen neuen Output. Heute sind die am häufigsten verwendeten Typen Large Language Models (LLM), Diffusionsmodelle, GANs und VAEs.
Letzte Aktualisierung: 18.10.2026
Short date eliza wurde 1966 aus den ersten chat-programmen veröffentlicht, aber es arbeitete mit fertigen regeln; es war heute kein produktives modell. Asıl leap VAE (2013), GAN (2014), kam mit Transformator-Architektur (2017) und Diffusionsmodelle. Die Idee der Diffusion wurde 2015 empfohlen, weit verbreitet mit der DDPM-Arbeit im Jahr 2020. Diese Technologie kommt in vielen Werken aus dublajdan Bildungsinhalten zum Einsatz; die Risiken wie Deepfake, Copyright, Bias und Model Fitting (Halüsination) stehen nach wie vor auf der Agenda.
Was genau ist diese Generative AI? Wie funktioniert das und was sind die Modelle? Hier Einzelheiten:
Was ist Generative AI?
Generative Künstliche Intelligenz ist ein KI-Feld, das sich auf die Erstellung von Algorithmen und Modellen konzentriert, die neue und realistische Daten erzeugen können, die Mustern im Bildungsdatensatz ähneln. Einfach ausgedrückt bezieht sich generative KI auf eine Klasse von KI-Systemen, die völlig neue Daten produzieren. Diese Systeme oder Modelle werden trainiert, um aus großen Datensätzen zu lernen und basierend auf diesen Informationen etwas völlig Neues zu schaffen. So wird der Begriff "generativ" (produziert) verwendet.
Generative KI hat viele Anwendungen in der Kunst, Bildsynthese, Produktion natürlicher Sprache, Musikkomposition, Kodierung und vielen weiteren Bereichen. Die meisten traditionellen Arten von künstlicher Intelligenz sind darauf ausgelegt, vorhandene Daten zu klassifizieren oder zu kategorisieren, der Zweck von generativen KI-Modellen ist es, völlig originelle Werke zu produzieren, die noch nie zuvor gesehen wurden.
Diskriminative KI (Permanente Künstliche Intelligenz) und Generative KI-Unterschiede
Das Verständnis der Unterschiede zwischen Diskriminativer KI (Permanent Artificial Intelligence) und Generativer KI (Manufacturer Artificial Intelligence) hilft uns, verschiedene Anwendungen künstlicher Intelligenz besser zu erfassen.
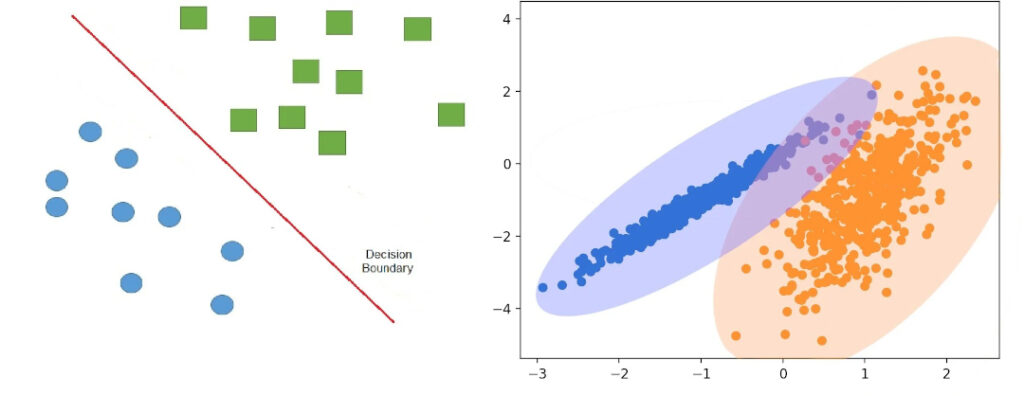
Diskriminierende KI Modell HomeSie sind darauf trainiert, Muster in Datensätzen zu erkennen und neue Beispiele anhand dieser Muster vorherzusagen oder zu klassifizieren. Zum Beispiel kann ein Diskriminator-KI-Modell, das auf einem Datensatz mit Katzen- oder Hundebildern trainiert wird, neue Bilder basierend auf Mustern, die sie aus Eingabedaten lernen, als Katze oder Hund klassifizieren. Solche Modelle werden oft mit Überwachungslerntechniken trainiert und sind für bestimmte Aufgaben sehr effektiv. Sie werden hauptsächlich zur Lösung spezifischer Probleme wie Klassifizierung oder Vorhersage verwendet.
Generative AI Wenn es entworfen ist, um die zugrunde liegenden Muster in den Datensätzen zu lernen und diese Informationen ähnlich dem ursprünglichen Datensatz zu erzeugen, aber nicht ganz die gleichen neuen Beispiele. Zum Beispiel kann ein Hersteller, der auf dem KI-Algorithmus für Katzenbilder geschult ist, neue Katzenbilder produzieren, die dem ursprünglichen Datensatz ähneln, aber ohne vollständige Kopien. Bei der Erstellung von Modellen lernen Sie weitgehend aus unbeschrifteten Daten selbstgesteuerte (selbstüberwachte) Methoden; zum Beispiel wird ein Sprachmodell trainiert, indem das nächste Stück im Text vorhergesagt wird. Chat-assistenten nehmen eine feine anpassung mit menschlichem feedback darauf vor. Dies macht die Hersteller-KI besonders nützlich in Anwendungen, in denen konfigurierte oder regulierte Daten schwer zu erschrecken oder zu erhalten sind.
Algorithmen für maschinelles Lernen zur Überwachungwenn gekennzeichnete Daten nicht verfügbar sind. Stattdessen wird der Algorithmus mit einer Anzahl unstrukturierter Datensätze angegeben. Der Algorithmus betrachtet unstrukturierte Daten und versucht, Muster und Strukturen ohne Anweisungen oder Vorkenntnisse selbstständig zu identifizieren. Clustering und Anomalieerkennung sind Beispiele für unüberwachte Lerntechniken.
Semi-Reviewed Machine Learning AlgorithmenWenn einige beschriftete Daten für das Training verfügbar sind, werden sie jedoch verwendet, wenn es nicht ausreicht, um ein vollständiges Modell zu trainieren. Der Algorithmus definiert Muster und Strukturen innerhalb der Daten unter Verwendung von markierten Daten mit nicht markierten Daten. Halbüberwachungslernen kann als hybrider Ansatz zwischen Überwachung und unbeaufsichtigten Lerntechniken betrachtet werden.
Im Allgemeinen entwickelt die immissive KI die Fähigkeit, ein breiteres Verständnis und neue Datenproben zu erstellen, während sie lernt, ein bestimmtes Problem zu lösen. Das Verständnis dieser beiden Arten von KI hilft uns zu erkennen, welche Situationen und wie sie effektiv genutzt werden können.
Grundunterschied zwischen künstlicher Intelligenz und klassischer künstlicher Intelligenz
Der grundlegende Unterschied ist: Das klassische Modell (Sektor) gibt Ihnen einen Tag, eine Punktzahl oder eine Vorhersage; Das produktive Modell erzeugt einen neuen Inhalt. Die folgende Tabelle fasst den Unterschied zusammen.
Merkmal | Klassische (auch) künstliche Intelligenz | Künstliche Intelligenz (Generative AI) |
|---|---|---|
Was macht das? | Es klassifiziert Daten, Scores, Schätzungen | Produziert neue Inhalte, die Daten ähneln |
Output | Tag, Wahrscheinlichkeit, Zahl (z. B. "Spam" oder "Spam") | Text, Bild, Audio, Video, Code |
Stichprobenaufgaben | Spamfilter, Kreditrisiko-Score, Produktvorschlag, Fehlervorhersage Home | Chat, Textschreiben, visuelle und Videogenerierung, Codeschreiben |
Probensysteme | E-Mail-Filter, Empfehlungsmaschinen, Klassifikatoren | ChatGPT, Gemini, Claude, Midjourney, Stable Diffusion |
Kurz gesagt, wenn Sie "generative KI nicht-menschliche Intelligenz" sagen, können Sie die Systeme denken, die entscheiden oder vorhersagen, aber keine neuen Inhalte produzieren.
Arbeitsprinzip für generische KI
Generative AI kann als eine KI-Version betrachtet werden, die die kreativen Prozesse des menschlichen Gehirns nachahmt. In diesem Bereich ist es mit verschiedenen Techniken wie Nervennetzwerken und Deep-Learning-Algorithmen möglich, bestimmte Muster zu identifizieren und basierend auf ihnen neue Ergebnisse zu erzielen.
Der Trainingsprozess von Generative AI beginnt normalerweise mit einem großen Datensatz. Dieser Datensatz kann Beispiele wie Bilder, Text, Audio oder Videos enthalten. Das Modell versucht, die Grundregeln für die Verwaltung des Inhalts durch die Analyse von Mustern und Beziehungen in Eingabedaten herauszufinden. Als nächstes produzieren wir neue Daten, indem wir Beispiele aus der Verteilung der Möglichkeiten ziehen, die Sie lernen. Es versucht ständig, das Potenzial zu maximieren, um die richtige Ausgabe zu erzeugen, indem es seine Parameter anpasst.
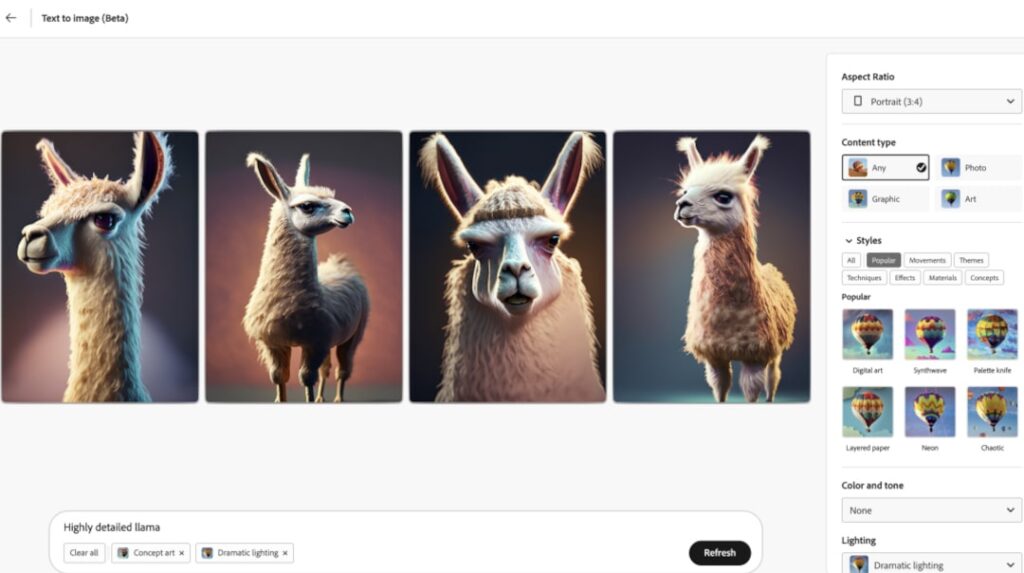
Beispielsweise kann ein generatives Modell, das auf einem aus Lamabildern bestehenden Datensatz trainiert wird, neue Lamabilder erstellen, indem Beispiele aus der gelernten Verteilung hervorgehoben und dann die Ausgabe mit einem Prozess namens "Papier" verfeinert werden. Beim Entfernen passt die Modellausgabe besser an die gewünschte Ausgabe an oder behebt Fehler. Dies stellt sicher, dass die erzeugte Ausgabe realistischer ist und besser zu dem passt, was der Benutzer sehen möchte.
Generative KI hat das Potenzial, die kreative Content-Produktion zu revolutionieren. Mit Kunst, Musik, Literatur und sogar wissenschaftlichen Entdeckungen kann es die Tür zu unausweichlichen Innovationen öffnen. Die in diesem Bereich geleistete Arbeit ermöglicht es der KI, sich in eine Technologie zu verwandeln, die nur ein analytisches Werkzeug sein kann, menschliche Kreativität nachahmt oder sogar unterstützt.
Was sind Generative AI-Modelle?
Generative KI-Modelle sind nicht der einzige Typ. Heute wurde diese Art von künstlicher Intelligenz als unterschiedliche Modelle von verschiedenen Unternehmen der künstlichen Intelligenz eingeführt. Hier sind die bekanntesten von diesem Typ:
Modelltyp | Wie funktioniert das? | Stark | Bekannte Beispiele |
|---|---|---|---|
GAN (2014) | Der Separator mit dem Generator wird gegeneinander trainiert | Schnelle und scharfe visuelle Produktion in einem Schritt Home | StyleGAN, CycleGAN |
AaUppercase | Komprimiert Daten aus dem versteckten Raum, regeneriert von dort | Kontrollierte Variation, Kompression | Image Encoder-Breaker auf Stable Diffusion |
Fusion (2015, 2020) | Es schafft Visuals, indem es den Lärm Schritt für Schritt reinigt | Hohe visuelle Qualität, Textführung | E 2, Stable Diffusion |
Transformator basiertes LLM (2017) | Es erzeugt Text durch Vorhersage des nächsten Stücks (Token) | Text, Code, Chat, mehrsprachige Nutzung m | GPT, Gemini, Llama |
Flow-basiert (Glow, 2018) | Es verwendet umgekehrte Conversions | Vollständige Berechnung des Potenzials | Glow; Stable Diffusion 3 mit Flow Matching |
Generative Adversarial Networks (GANs)
Generative Adversarial Networks (GANs) ist ein künstliches Intelligenzmodell, das aus zwei Nervennetzwerken besteht: einem Generator und einem Separator. Wenn Sie beispielsweise aufgefordert werden, Katzenbilder zu erstellen, erzeugt der Generator ein neues Katzenbild mit einem zufälligen Eingabevektor.
Diese Bilder können anfangs einfach sein, aber es wird im Laufe der Zeit realistisch. Der Separator arbeitet, um echte oder gefälschte zu klassifizieren, indem er sowohl echte Katzenbilder als auch gefälschte Bilder macht.
Beide Netzwerke entwickeln sich kontinuierlich, indem sie miteinander konkurrieren: Machen Sie den Separator besser, der Generator lernt, inkonduktivere Bilder zu erstellen. Diese Wettbewerbsstruktur hat die Verwendung von "gegnerischen" Ausdruck verursacht, der das Modell genannt wird.
Trainingsprozess von GANs
Der Trainingsprozess von GANs (Generative Adversarial Networks-produced Traction Networks) ist ein ziemlich interessanter und innovativer Ansatz. Dieses Verfahren besteht aus folgenden Schritten:
Start TagsGenerator (Generator) und Unterscheidung (Diskriminator) werden mit zufälligen Gewichten gestartet. Die Grundidee dabei ist, dass zwei Netzwerke miteinander konkurrieren.
TrainingszyklusDer Generator wird auf die Kombination von unverwechselbaren realen und gefälschten Daten beim Erstellen von gefälschten Datengemeinschaften trainiert. Die Wiege gibt einen Optionswert zwischen 0 und 1 an, der angibt, ob die Eingabedaten echt oder gefälscht sind.
Back Spread ()Zuhause): Das Fehlersignal vom Shutter breitet sich zurück, um das Gewicht des Netzwerks zu aktualisieren. Dann wird der Generator auch mit dem Fehlersignal aus der Unterscheidung trainiert und sein Gewicht aktualisiert.
ProbenahmeNachdem das Modell trainiert wurde, kann der Generator neue Datenproben aus der gelernten Verteilung erzeugen.
GANs wurden für verschiedene Anwendungen wie die Herstellung realistischer Bilder, Videos und Gespräche verwendet. Einer der Vorteile von GAN ist, dass sie dank ihrer Fähigkeit, komplexe und multimodale Verteilungen zu lernen, qualitativ hochwertige und verschiedene Beispiele produzieren können.
Das Training von GANs kann jedoch schwierig sein und sie können unter Problemen wie Mod-Kollaps (Mode-Crash) leiden, hier produziert der Generator begrenzte und sich wiederholende Beispiele. Verschiedene Modifikationen und Verbesserungen wurden empfohlen, um diese Probleme anzugehen, wie Wasserstein GANs und StyleGANs.
Anwendungsbereiche von GAN
GAN (Generative Adversarial Networks) ist eine Technologie der künstlichen Intelligenz, die aus zwei Netzwerken besteht und innovative Anwendungen in verschiedenen Bereichen ermöglicht. Diese:
Bild- und Videoproduktion/Manipulation: Displays und Deep Fakes (Deep Fakes).
Stilübertragung und Video von Bildübersetzung: Konvertieren Sie Bilder durch Anwendung verschiedener Stile.
Datenwiederherstellung und Synthetisierung: Verbessert die Leistung von kontrollierten Lernmodellen.
Synthesis and Image Subtitle from Text: Visualisieren Sie geschriebenen Text oder fügen Sie Untertitel zu Bildern hinzu.
3D-Objektproduktion und -design: Erstellen realistischer Avatare und virtueller Umgebungen.
Sound Transformation und Sound Synthesis: Sound und Musikproduktion.
Spielentwicklung und Design: Erstellen Sie neue Levels und Charaktere.
Kreative Anwendungen: Kunst, Musik, Literaturproduktion.
Security & Privacy: Fake Datengenerierung und tiefe Fälschungserkennung.
Wissenschaftliche Forschung und Simulation: Simulieren Sie komplexe Systeme und machen Sie wissenschaftliche Vorhersagen.
CycleGAN ist ein GAN-Beispiel für die Übersetzung von Bild zu Bild und kann Bilder ohne unübertroffene Trainingsdaten konvertieren. Die Wirksamkeit von GAN hängt von der Qualität der Bildungsdaten, der Komplexität der zugrunde liegenden Verteilung und Faktoren wie der Architektur des Modells ab.
Variable Automatic Encoder (VAEs)
Variable Automatic Encoder (VAEs) sind regenerative Modelle, die im Bereich der künstlichen Intelligenz eingesetzt werden. Diese Modelle können neue Ausgaben erzeugen, die Datensätzen ähnlich sind, insbesondere sind sie effektiv bei der Erforschung der richtigen Variationen bestimmter Richtungen innerhalb der Daten. VAEs arbeiten durch zwei Nervennetzwerke, die einen Encoder und ein Lösungsmittel enthalten, um ein Bild aufzunehmen.
Der Codierer wandelt das Bild in eine kleine Darstellung um, die als "Hid Space" bezeichnet wird, und erzeugt mit dieser Darstellung des Lösungsmittels ein neues Bild, das dem Original ähnelt. Die Besonderheit von VAE besteht darin, dass es außergewöhnliche Modelle verwendet, um die unter Bildungsdaten liegende Verteilung zu lernen. Auf diese Weise können sie Unsicherheiten besser erfassen und in Daten variieren. VAEs birgt großes Potenzial für innovative Anwendungen in Bereichen wie visuelle Kunst und Datensimulation.
Trainingsprozess von VAEs
Variable Automatic Encoder (VAEs) ist eine weit verbreitete Methode im maschinellen Lernen und ist besonders effektiv in Anwendungen wie Datengenerierung, Kompression, Rauschentfernung und Eigenschaftsextraktion. Der Trainingsprozess von VAEs besteht aus den folgenden Schritten:
Codierung (Encoding): Eingangsdaten werden dem Encodernetzwerk (Encoder) zugeführt. Dieses Netzwerk komprimiert Daten in einen niedrigeren "latenten" Raum. Dieser verborgene Raum basiert auf der Annahme der Gaußschen Verteilung.
Sampling (Sampling): Eine zufällige Stelle im verborgenen Raum aus der Gauß-Verteilung gelernt.
Code Solving (Decoding): Code Solvent Network (Decodierer), nimmt den abgetasteten Punkt und konvertiert ihn in einen neuen Datenpunkt. Code-Lösungsmittel wird trainiert, um die ursprünglichen Eingabedaten unter Verwendung von Hidden Space-Darstellung neu zu konfigurieren.
Lost Calculator (Loss Calculation): Die Verlustfunktion für VAEs besteht aus Restrukturierungsverlust und Verlust der KL-Divergenz (Headback-Leibler-Abweichung). Restrukturierungsverlust misst, wie gut das Code-Lösungsmittel die ursprünglichen Eingabedaten umstrukturieren kann. Auf der anderen Seite misst der KL-Divergenzverlust den Unterschied zwischen der Verteilung des gelernten Geheimraums.
Back Spread (Backpropagation): Das Fehlersignal von der verlorenen Funktion breitet sich über das Netzwerk aus, um die Gewichtung von Encoder und Decoder zu aktualisieren.
Nachdem das Training abgeschlossen ist, kann VAE neue Daten durch Probenahme aus der Verteilung des gelernten geheimen Raums erzeugen. VAEs können auch in anderen Anwendungen wie Datenkomprimierung, Rauschentfernung und Eigenschaftsentfernung verwendet werden. Beispielsweise kann die Anwendung zur Entfernung von Bildrauschen mit automatischen Kodierern erfolgen.
Anwendungsgebiete von VAE
Variable Automatic Encoders (VAEs) ist eine auf künstlichen Nervennetzwerken basierende Technologie, die einen wichtigen Platz im Bereich der künstlichen Intelligenz und des maschinellen Lernens einnimmt. Diese Technologie wird in vielen Bereichen eingesetzt, insbesondere bei der Datengenerierung und -manipulation. Hier sind einige der Anwendungsgebiete von VAEs:
Bildproduktion und Manipulation: VAEs können neue und realistische Bilder erzeugen oder bestehende Bilder verändern. Dies bietet neue Kreativität im Bereich Kunst und Design.
Videoproduktion und -vorhersage: VAEs können verwendet werden, um Videoinhalte zu erstellen und zukünftige Quadrate vorherzusagen.
Data Compression and Noise Removal: VAEs sind sehr effektiv bei der Reduzierung von Daten durch Kompression und Rauschen, erfordern daher weniger Speicherplatz und erhöhen die Datenqualität.
Abnormalitätserkennung und Ausgrabungswert: VAEs können verwendet werden, um abnormale oder illegale Elemente in Datensätzen zu erkennen und zu entfernen.
Empfehlungssysteme und Personalisierung: Verwendet VAEs, um maßgeschneiderte Inhalte und Produktempfehlungen nach persönlichen Vorlieben bereitzustellen.
Feature Extraction and Representation: VAEs werden verwendet, um aussagekräftigere und nützlichere Darstellungen von Daten zu lernen.
Herstellung realistischer 3D-Modelle und Umgebungen: VAEs können verwendet werden, um 3D-Modelle und virtuelle Umgebungen zu erstellen, die der realen Welt ähneln.
Verarbeitung natürlicher Sprache: VAEs spielen eine wichtige Rolle bei der Verarbeitung natürlicher Sprache, einschließlich Textproduktion und maschineller Übersetzung.
Biomedizinische Datenanalyse und Drug Discovery: VAEs werden bei der Analyse von biomedizinischen Daten und der Entdeckung neuer pharmazeutischer Kandidaten verwendet.
Simulation und Prognose in Physik und anderen Wissenschaften: VAEs werden zur Simulation und Prognose in verschiedenen Wissenschaftszweigen verwendet.
Diffusionsmodelle
Diffusionsmodelle kommen zu uns als innovativer Schritt im Bereich der künstlichen Intelligenz. Diese Modelle fügen den Basisdaten Rauschen hinzu, um qualitativ hochwertige synthetische Daten zu erzeugen und durch Entfernen dieses Rauschens zu lernen. Dank des Rauschextraktionsprozesses ermöglichen Diffusionsmodelle ein besseres Verständnis von Datenmustern und -strukturen.
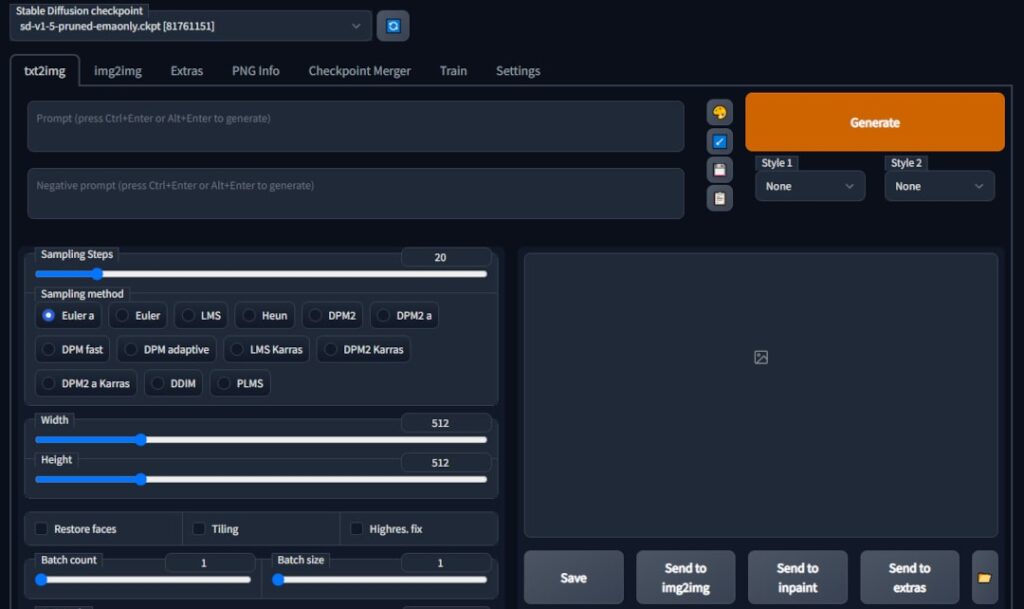
Diese Modelle sind besonders erfolgreich bei der Erstellung von Bildern. Das Modell im Training lernt, das den Daten hinzugefügte Rauschen vorherzusagen, dieses einfache Ziel macht das Training stabiler als zwei Netzwerkwettbewerbe in GAN. Bedeli ist langsamer Betrieb aufgrund der Produktion ist sehr schrittweise. Das DALL·E 2-Modell von OpenAI (2022) und Stable Diffusion (latente Diffusion), die in einem komprimierten versteckten Raum vor dem Bild arbeiten, sind ein Beispiel für Diffusionsmodelle, die visuell aus Text erzeugen. Die erste DALL·E (2021) war keine Diffusion, sondern ein autoregresific Transformatormodell.
Weitere Generative AI-Modelle
Wir haben Generative AIs gesehen, die hauptsächlich in 3 verschiedene Modelle unterteilt sind. Aber auch innovativere und experimentellere Generative AI-Modelle sind verfügbar. Diese Modelle sind unten im Detail aufgeführt.
Autoregresific Modelle
Autoregresif-Modelle sind die Möglichkeiten von prädiktiven Modellen, die auf den vorherigen Elementen basieren, wobei jedes Element wiederum ein Datenarray erzeugt. Im Bereich Natural Language Processing (NLP) werden sie häufig bei Aufgaben wie Textproduktion und Sprachübersetzung eingesetzt. Diese Modelle prognostizieren den nächsten Wert, indem sie frühere Werte in einer Zahl betrachten. Zum Beispiel kann der Preis des nächsten Tages basierend auf den Preisen der vorherigen Tage in der Zeitreihenanalyse der Aktienkurse vorhergesagt werden.
Große Sprachmodelle (LLMs) erzeugen mit solchen autoregresiven Modellen menschenähnliche Reaktionen auf Befehle. Sie werden in großen Textdatensätzen wie Büchern, Artikeln und Websites geschult und sollen neue Texte in Stil und Inhalt erzeugen, die den tatsächlichen Daten ähneln. LLMs haben erfolgreiche Ergebnisse in vielen Sprachen wie Sprachmodellierung, maschinelle Übersetzung, Fragestellung und Textabstraktion erzielt.
Es ist auch wichtig für kreative Arbeiten wie hochwertige Textgenerierungsfunktionen, Chat-Assistenten, Code-Typisierung, Abstraktion und Social-Media-Posts. Wie man LLMs Home trainiert Was ist das Big Language Model (LLM), wie man ausgebildet wird? In unserem Artikel haben wir ausführlich erklärt.
Transformerbasierte Modelle
Die Transformer-Architektur wurde 2017 mit dem Artikel "Attention Is All You Need" der Google-Forscher eingeführt; heute sind auf dieser Architektur große Sprachmodelle wie GPT, Gemini und Llama installiert. Transformer ist eine Art nervöse Netzwerkarchitektur, die auf einem eigenen Aufmerksamkeitsmechanismus basiert. Wenn eine Eingabe gegeben wird, ermöglicht der Mechanismus dem Modell, Gewichte parallel zu verschiedenen Teilen des Eingabefelds zuzuweisen.
Dann bestimmt das Modell die Beziehung zwischen diesen Abschnitten und erzeugt die entsprechende Ausgabe für den speziellen Eingang. Transformer werden häufig für NLP-Aufgaben wie Sprachübersetzung, Produktion und Fragestellung verwendet. Wenn sie jedoch nicht speziell für die Erstellung neuer Inhalte geschult sind, können sie nicht nur als generative Modelle betrachtet werden.
Flow-basierte Modelle
Flow-basierte Modelle sind eine Art generative KI-Modelle und konzentrieren sich auf das Erlernen der Organisation von Daten in einem Datensatz. Diese Modelle funktionieren, indem sie die Möglichkeiten von Werten/Ereignissen im Datensatz verstehen und identifizieren, was häufig auftritt. Bei der Erstellung neuer Datenpunkte schützen sie die statistischen Eigenschaften und Eigenschaften vorhandener Daten. Das Merkmal dieser Modelle ist, dass sie vorhandene Daten anwenden, die durch eine "einfache Umkehrumwandlung" leicht rückgängig gemacht oder umgekehrt werden können.
Da die Konvertierung umgekehrt wird, können diese Modelle die Möglichkeit einer Daten vollständig berechnen und die Probe aus einer einfachen Startverteilung (z. B. Zufallsrauschen) erzeugen. Glow, das 2018 veröffentlicht wurde, sind die bekannten Beispiele für diesen Ansatz. Nachteilig ist die Zurückhaltung der Architektur der Anforderung, dass jede Schicht umgekehrt werden muss.
Die Idee des Fließens ist heute auf unterschiedliche Weise zurück: Stable Diffusion 3 wurde 2024 als Transformatormodell eingeführt, das nach der Fließanpassungsmethode "rectified flow" trainiert wurde. So werden Diffusions- und Strömungsansätze in aktuellen visuellen Modellen importiert. Für Details Stable Diffusion3 Siehe unseren Artikel.
Wenn Sie künstliche Intelligenz-Tools während der Produktion ausprobieren möchten Visual Building Guide für künstliche Intelligenz mit MidjourneyTags Wie benutzt man DALL·E 2 Artificial Intelligence Image Creation Tool? und Erstellen von Visual und Video mit künstlicher Intelligenz Sie können unsere Artikel durchsuchen. Zur allgemeinen Definition von künstlicher Intelligenz Was ist künstliche Intelligenz? Unser Artikel ist ein guter Anfang.
Häufig gestellte Fragen
Was bedeutet Generative AI?
Generative AI bedeutet im Englischen "natürliche Intelligenz". Es erzählt von neuen Text-, visuellen, Audio-, Video- oder Code-generierenden Systemen der künstlichen Intelligenz, die Daten ähneln, die sie lernen.
Was ist der Hauptunterschied zwischen klassischer künstlicher Intelligenz mit Generativer KI?
Classic klassifiziert oder prognostiziert die Daten mit künstlicher Intelligenz; generative KI produziert neue Inhalte. Zum Beispiel, Spam-Filter "Spam" Tags, ein Sprachmodell, schreibt Ihnen eine neue E-Mail.
Was sind Beispiele für künstliche Intelligenz ohne Generative AI?
Systeme wie Spamfilter, Kreditrisiko-Score, Produktempfehlungssysteme, Fehlervorhersage und Objekterkennung im Bild sind Beispiele für nicht professionelle künstliche Intelligenz. Diese entscheiden oder prognostizieren, produzieren keine neuen Inhalte.
Was ist Generative Adversarial Networks (GAN)?
GAN ist ein produktives Modell, das 2014 eingeführt und gegen zwei Nervennetzwerke trainiert wurde. Der Generator produziert gefälschte Beispiele, der Separator versucht, sie von ihren Wahrheiten zu trennen, was diese Konkurrenz realistischer macht.
ChatGPT ist eine generative KI?
Ja. ChatGPT ist eine produktive Anwendung für künstliche Intelligenz, die mit großen Sprachmodellen auf der Grundlage von Transformator-Architektur arbeitet; es erzeugt neuen Text, indem es die nächsten Wortteile gemäß dem von Ihnen angegebenen Befehl vorhersagt.
CreatorMeta’nın Çığır Açan Yeni AI Uygulaması: Duygusal Anlamda İletişim!
GenAI: Çok Yönlü Yapay Zeka Platformunuz