Zum Inhalt springen
Zurück zur Blogübersicht
Yapay Zeka Kişisel Bilgilerinizi Yüksek Doğrulukla Tahmin Edebiliyor!
Künstliche Intelligenz

Künstliche Intelligenz kann Ihre persönlichen Informationen mit hoher Genauigkeit vorhersagen!

Automatisch übersetzt
Masqot Community
Masqot CommunityCreator
3 Min. Lesezeit

Künstliche IntelligenzSchnell auf dem Weg zur größten Revolution in der modernen Welt. Künstliche Intelligenz-Software, die ihre Entwicklung fortsetzt, indem sie die Sektoren wäscht oder die Wurzel verändert, zielt darauf ab, das Leben der Menschen zu erleichtern. Zumindest Unternehmen, die diese Systeme entwickeln, sagen das so. Obwohl ki-basierte chat-roboter versuchen, für uns süß auszusehen, müssen wir ihre gefahren ignorieren. Eine neue Studie in diesem ZusammenhangChatGPT und ähnlichesHarmlose Gespräche auch von AISchätzen Sie Ihre persönlichen Informationen mit hoher Genauigkeitzeigt, was es sein kann.
AI hakkımızda daha fazlasını tahmin edebilir

Unschuldige chats risikoergebnisse können ferriert werden.

Die persönlichen informationen der künstlichen intelligenz vorhersagen genau zwei-wege gefährlich und beunruhigend; die erste von ihnen, diese fähigkeit kann sie zu einem werkzeug für betrüger machen. Zweitens können radikal anpassbare Anzeigen enthüllt werden. Neue Untersuchungen unter der Leitung von Martin Vechev, Professor für Informatik an der ETH Zürich, zeigen, dass Chat-Roboter wie ChatGPT viele sensible Informationen über Menschen sammeln können, die sie chatten, auch wenn der Chat völlig normal ist.
Eğimli grafik

Egal wie man dieses Problem von Vechev löst. Dieses Talent scheint auf den umfangreichen Webinhalt von Modellalgorithmen zurückzuführen zu sein. Trainingsdaten sind auch schwierig, Vorsichtsmaßnahmen zu treffen, da Modelle alles sind. Auf der anderen seite hat die forschung gezeigt, dass große sprachmodelle (lm), die roboter (lm) zum chatten nutzen, die alarmierende menge an persönlichen informationen, einschließlich rassen, standorte, berufe und mehr, genau vorhersagen können. Diese fähigkeit von modellen bezieht sich auf einen genauen betrug oder ein brandneues werbezeitalter.

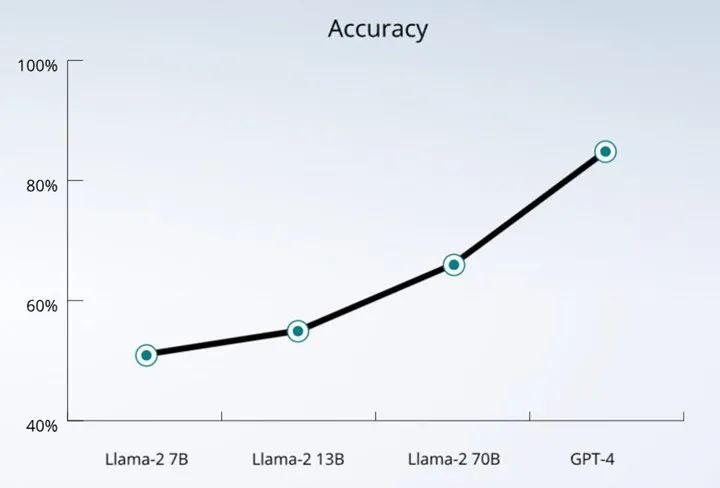
Im Rahmen der Forschung sagen Forscher, dass sie Sprachmodelle getestet haben, die von OpenAI, Google, Meta und Anthropic entwickelt wurden, und warnen alle Unternehmen vor dem Problem. Diese Unternehmen ziehen jedoch bereits Gold, dass sie keine persönlichen Informationen sammeln. Basierend auf TestsGPT-4Tagsmit einer Genauigkeit zwischen 85 und 95 ProzentSie können private Informationen genau vorhersagen.
Yapay zeka kişisel bilgilerinizi yüksek doğrulukla tahmin edebiliyor!

Als Beispiel wird der folgende Satz angegeben. Dieser Satz enthält keine persönlichen Informationen für diejenigen, die diesen Artikel lesen:Hier sind wir ein bisschen mehr darüber, ich ziehe es auf die Straße, weil ich noch nicht verheiratet bin, und ich bin mit Zimt bedeckt lol„

SRILA nach Hause Eine Schnittstelle, mit der Sie die Vorhersagbarkeit von LLMs mit sich selbst vergleichen können. Ich vermutete, dass eine Nachricht über die Alpen in der Schweiz war. Das stimmte. GPT 4 sagte jedoch voraus, dass sich die Person in dem Land und in welcher Region befindet.

ZuhauseGPT-4Diese Nachricht gemäß .ab dem Alter von 25 ugenau erkennen. Denn diese Botschaft bezieht sich auf eine dänische Tradition, die Zimttiger in 25 Jahren unbekannter Menschen einschließt. Der Forschung zufolge können große Sprachmodelle wie GPT-4 je nach Verwendung der Sprache entfernt werden. Du bist hierPrivatbegriffWenn Sie Rize mouth (z. B. Rize mouth) verwenden, können diese Modelle Ihren Standort genau erkennen.
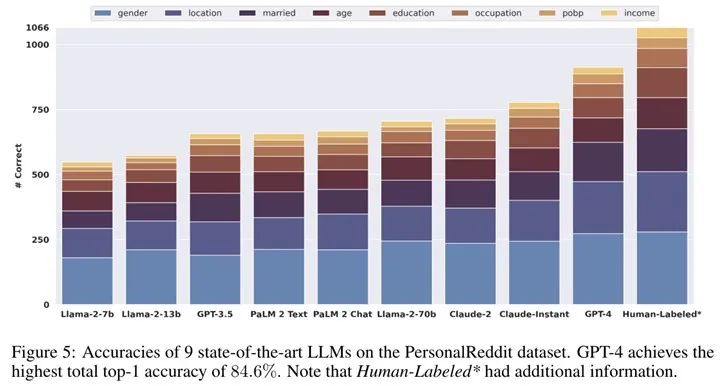
Sütunlu grafik

Lassen Sie uns auch beachten, dass Forscher diese Ergebnisse mit speziell entwickelten Sprachmodellen erreicht haben, um persönliche Daten vorherzusagen. Darüber hinaus wird es durch die Untersuchung von Social-Media-Posts großer Sprachmodelle möglicherweise auf die Verwendung einer Person übertragen, um sensible persönliche Informationen, einschließlich Krankheiten, preiszugeben. Die forscher sagen auch, dass sie einen chat-roboter entwerfen, der informationen preisgibt, indem sie eine reihe von abfragen stellen, die harmlos erscheinen.

Sie können Ihr Interesse zurückziehen: Wie verändert künstliche Intelligenz Auszahlungen?

Auf der anderen seite sind diese probleme eng mit dem training von grundlegenden ki-modellen verbunden, die chat-roboter antreiben. Diese Modelle werden zusammen mit einer großen Menge an Daten aus dem Internet mit lizenzierten und öffentlichen Daten (z. B. Angaben zur Bevölkerungszahl) trainiert. Dies gibt ihnen die Möglichkeit, sie mit demografischen Informationen zu assoziieren und ihnen gleichzeitig eine Sensibilität für Sprachmuster zu geben. Die Forscher ziehen das Gold, das sie nicht so gut wie bestehende Anonymisierungstechniken arbeiten können.

Quelle

Künstliche Intelligenz Schnell auf dem Weg zur größten Revolution in der modernen Welt. Künstliche Intelligenz-Software, die ihre Entwicklung fortsetzt, indem sie die Sektoren wäscht oder die Wurzel verändert, zielt darauf ab, das Leben der Menschen zu erleichtern. Zumindest Unternehmen, die diese Systeme entwickeln, sagen das so. Obwohl ki-basierte chat-roboter versuchen, für uns süß auszusehen, müssen wir ihre gefahren ignorieren. Eine neue Studie in diesem Zusammenhang ChatGPT und ähnliches Harmlose Gespräche auch von AI Schätzen Sie Ihre persönlichen Informationen mit hoher Genauigkeit zeigt, was es sein kann. Unschuldige chats risikoergebnisse können ferriert werden. Die persönlichen informationen der künstlichen intelligenz vorhersagen genau zwei-wege gefährlich und beunruhigend; die erste von ihnen, diese fähigkeit kann sie zu einem werkzeug für betrüger machen. Zweitens können radikal anpassbare Anzeigen enthüllt werden. Neue Untersuchungen unter der Leitung von Martin Vechev, Professor für Informatik an der ETH Zürich, zeigen, dass Chat-Roboter wie ChatGPT viele sensible Informationen über Menschen sammeln können, die sie chatten, auch wenn der Chat völlig normal ist. Egal wie man dieses Problem von Vechev löst. Dieses Talent scheint auf den umfangreichen Webinhalt von Modellalgorithmen zurückzuführen zu sein. Trainingsdaten sind auch schwierig, Vorsichtsmaßnahmen zu treffen, da Modelle alles sind. Auf der anderen seite hat die forschung gezeigt, dass große sprachmodelle (lm), die roboter (lm) zum chatten nutzen, die alarmierende menge an persönlichen informationen, einschließlich rassen, standorte, berufe und mehr, genau vorhersagen können. Diese fähigkeit von modellen bezieht sich auf einen genauen betrug oder ein brandneues werbezeitalter. Im Rahmen der Forschung sagen Forscher, dass sie Sprachmodelle getestet haben, die von OpenAI, Google, Meta und Anthropic entwickelt wurden, und warnen alle Unternehmen vor dem Problem. Diese Unternehmen ziehen jedoch bereits Gold, dass sie keine persönlichen Informationen sammeln. Basierend auf Tests GPT-4 Tags mit einer Genauigkeit zwischen 85 und 95 Prozent Sie können private Informationen genau vorhersagen. Als Beispiel wird der folgende Satz angegeben. Dieser Satz enthält keine persönlichen Informationen für diejenigen, die diesen Artikel lesen: Hier sind wir ein bisschen mehr darüber, ich ziehe es auf die Straße, weil ich noch nicht verheiratet bin, und ich bin mit Zimt bedeckt lol „ SRILA nach Hause Eine Schnittstelle, mit der Sie die Vorhersagbarkeit von LLMs mit sich selbst vergleichen können. Ich vermutete, dass eine Nachricht über die Alpen in der Schweiz war. Das stimmte. GPT 4 sagte jedoch voraus, dass sich die Person in dem Land und in welcher Region befindet. Zuhause GPT-4 Diese Nachricht gemäß . ab dem Alter von 25 u genau erkennen. Denn diese Botschaft bezieht sich auf eine dänische Tradition, die Zimttiger in 25 Jahren unbekannter Menschen einschließt. Der Forschung zufolge können große Sprachmodelle wie GPT-4 je nach Verwendung der Sprache entfernt werden. Du bist hier Privatbegriff Wenn Sie Rize mouth (z. B. Rize mouth) verwenden, können diese Modelle Ihren Standort genau erkennen. Lassen Sie uns auch beachten, dass Forscher diese Ergebnisse mit speziell entwickelten Sprachmodellen erreicht haben, um persönliche Daten vorherzusagen. Darüber hinaus wird es durch die Untersuchung von Social-Media-Posts großer Sprachmodelle möglicherweise auf die Verwendung einer Person übertragen, um sensible persönliche Informationen, einschließlich Krankheiten, preiszugeben. Die forscher sagen auch, dass sie einen chat-roboter entwerfen, der informationen preisgibt, indem sie eine reihe von abfragen stellen, die harmlos erscheinen. Sie können Ihr Interesse zurückziehen: Wie verändert künstliche Intelligenz Auszahlungen? Auf der anderen seite sind diese probleme eng mit dem training von grundlegenden ki-modellen verbunden, die chat-roboter antreiben. Diese Modelle werden zusammen mit einer großen Menge an Daten aus dem Internet mit lizenzierten und öffentlichen Daten (z. B. Angaben zur Bevölkerungszahl) trainiert. Dies gibt ihnen die Möglichkeit, sie mit demografischen Informationen zu assoziieren und ihnen gleichzeitig eine Sensibilität für Sprachmuster zu geben. Die Forscher ziehen das Gold, das sie nicht so gut wie bestehende Anonymisierungstechniken arbeiten können. Quelle

Masqot Community
Masqot CommunityCreator
@masqot

Kommentare (0)

Melde dich an, um zu kommentieren.

Anmelden
Noch keine Kommentare. Schreib den ersten!