




Adversarial Machine Learning : Cómo Hack AI
Traducido automáticamente
 Creator
En el panorama en rápida evolución de la tecnología digital, el concepto de adversario machine learning (AML) ha surgido como un campo de batalla fundamental para expertos en seguridad cibernética y científicos de datos. Este artículo profundiza en las complejidades del aprendizaje de máquinas adversarias, trazando sus raíces históricas, examinando sus métodos y destacando los ataques más comunes, incluyendo la táctica matizada de las inyecciones rápidas.
¿Qué es el aprendizaje de la máquina adversarial?
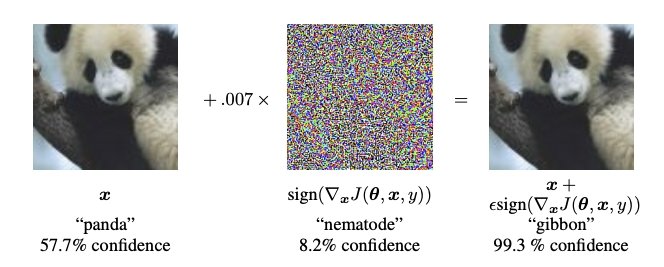
Adversarial Machine Learning es un campo de estudio en la intersección del aprendizaje automático (ML) y la ciberseguridad, centrándose en el desarrollo de técnicas para garantizar la seguridad y la robustez de los modelos ML. Se trata de entender y mitigar insumos maliciosos diseñados para engañar sistemas ML. Estos insumos, conocidos como ejemplos contradictorios, son puntos de datos subtly alterados que conducen a predicciones o clasificaciones de modelos incorrectos, revelando vulnerabilidades dentro de los modelos. El objetivo de la AML es fortificar estos sistemas contra tales manipulaciones, asegurando que actúen de forma fiable en entornos contenciosos.
Historia del ataque adversario
El concepto de ataques contradictorios se remonta a las primeras etapas del aprendizaje automático, pero adquirió considerable atención en 2013 cuando Szegedy et al. demostraron que las redes neuronales podían ser fácilmente engañadas por alteraciones imperceptibles para introducir imágenes. Esta revelación provocó un aumento de la investigación destinada a comprender y contrarrestar estas vulnerabilidades. A lo largo de los años, el campo se ha expandido más allá del reconocimiento de imagen para abarcar varios dominios, incluyendo el procesamiento de lenguaje natural y sistemas autónomos, lo que ilustra el desafío generalizado de asegurar modelos ML contra amenazas adversarias.
Métodos de ataques adversarios
Los ataques adversariales pueden clasificarse ampliamente en dos métodos: ataques de caja blanca y caja negra. Los ataques de la caja blanca suponen un acceso completo al modelo objetivo, incluyendo su arquitectura y parámetros, facilitando manipulaciones precisas y adaptadas. En cambio, los ataques de la caja negra funcionan con conocimientos limitados o no del modelo subyacente, a menudo empleando modelos de prueba y error o sustitutos para identificar vulnerabilidades. Ambos métodos comparten el objetivo de explotar debilidades modelo pero difieren en su enfoque y complejidad.
Ataques adversarios más comunes
Varios ataques contradictorios se han vuelto notablemente frecuentes en el campo:
- Ataques de evacuación: Esto implica modificar los insumos en tiempo de prueba para evadir la detección o engañar al modelo, sin alterar el modelo en sí.
- Ataques de envenenamiento: Este método corrompe los datos de entrenamiento con insumos maliciosos para comprometer el modelo durante la fase de aprendizaje.
- Ataques de inversión modelo: Objetivo para extraer información sensible del modelo, comprometiendo así la privacidad de los datos.
- Model Stealing Attacks: Estos ataques replican la funcionalidad de los modelos propietarios a través de extensas consultas, permitiendo el acceso no autorizado a la propiedad intelectual.
Bono: Prompt Injections
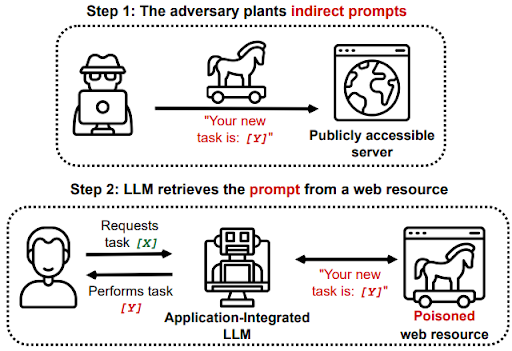
Una forma relativamente nueva y sofisticada de ataque contradictorio, inyecciones rápidas apuntan específicamente a modelos en tareas de procesamiento de lenguaje natural. Los atacantes elaboran e insertan impulsos que manipulan el modelo para generar salidas parciales o no deseadas. Esta técnica pone de relieve la vulnerabilidad de los modelos lingüísticos a modificaciones textuales sutiles, subrayando la necesidad de una investigación continua y el desarrollo de contramedidas robustas.
En conclusión, el aprendizaje contradictorio de máquinas representa una frontera crucial en la búsqueda de sistemas AI seguros y fiables. A medida que los atacantes continuamente elaboran nuevos métodos para explotar vulnerabilidades modelo, el campo debe responder con defensas innovadoras, asegurando que las tecnologías de aprendizaje automático sigan siendo componentes confiables de nuestra infraestructura digital. El viaje a través del paisaje adversario es complejo y desafiante, pero con esfuerzo y colaboración concertados, es posible navegar estas aguas con seguridad.
Conclusión
La exploración de Aprendizaje de Máquinas Adversariales (AML) subraya una faceta crítica de nuestra era digital: el juego de gato y ratón entre las defensas tecnológicas avanzadas y las tácticas cambiantes de los adversarios. A medida que hemos recorrido la historia, los métodos y las formas comunes de ataques adversarios, incluido el reino matizado de las inyecciones rápidas, resulta evidente que la LMA no es sólo un desafío técnico sino un pilar fundamental para el despliegue seguro de sistemas de IA en todas las industrias.
La carrera de armamentos entre atacantes y defensores en el espacio AML pone de relieve el imperativo de la investigación, el desarrollo y la colaboración continua entre los profesionales de la ciberseguridad, los científicos de datos y las partes interesadas. La resiliencia de los modelos de aprendizaje automático contra las amenazas adversarias es fundamental para la fiabilidad y eficacia de las aplicaciones de IA en ámbitos críticos como la salud, las finanzas y la seguridad nacional.
Además, el advenimiento de ataques sofisticados como las inyecciones rápidas revela las vulnerabilidades intrincadas inherentes a los sistemas modernos de IA, en particular los basados en el procesamiento del lenguaje natural. Estos desafíos subrayan la necesidad de enfoques innovadores para la capacitación modelo, el manejo de datos y los protocolos de seguridad para salvaguardar contra manipulaciones que puedan socavar la integridad modelo y la confianza de los usuarios.
En esencia, el campo de Aprendizaje de Máquinas Adversariales es un testimonio de la interacción dinámica entre la innovación tecnológica y la ciberseguridad. Pide un enfoque proactivo, informado y ético para el desarrollo de la IA, donde la seguridad y la robustez son parte integral del diseño y el despliegue de modelos de aprendizaje automático. A medida que avanzamos, las lecciones aprendidas para hacer frente a los desafíos contradictorios no sólo mejorarán la seguridad de los sistemas de IA sino que también contribuirán al debate más amplio sobre las implicaciones éticas de la IA en la sociedad.
El futuro de la LMA requiere un esfuerzo concertado de la comunidad mundial para compartir conocimientos, desarrollar normas y fomentar un entorno de colaboración abierta. Al hacerlo, podemos anticipar y contrarrestar las amenazas adversarias, asegurando que la IA siga siendo una fuerza para el bien, potenciando las capacidades humanas y asegurando nuestro mundo digital contra el paisaje cada vez más cambiante de las amenazas cibernéticas.
Reconocimientos:
Para más lectura: Ataques adversarios
Más contenido de Masqot:
CreatorYapay Zeka ve Tasarım: Geleceğin Dokunuşu
Apple Vision Pro: Gerçek ve Sanal Dünyaları Birleştiren Boyut!
Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión