



Análisis de sensibilidad orientado hacia la profundidad en los modelos MoE
Traducido automáticamente
 Admin
Los modelos de lenguaje grande (BBD) son críticos para mantener el rendimiento y la eficiencia al tiempo que se vuelven más complejos cada día. Aunque las arquitecturas Mixture-of-Experts (MoE) proporcionan este equilibrio, la importancia relativa de cada capa MoE sobre el modelo no fue suficientemente comprendida. Especialmente en el contexto de la compresión modelo (presión modelo) hubo una falta de análisis en profundidad. Una nueva investigación publicada en agosto de 2026 ofrece un análisis completo de precisión basado en capas sobre el modelo Qwen3.6-35B-A3B llenando esta brecha y está dando un paso significativo para la optimización futura de los BBD.
¿Qué es el análisis de sensibilidad orientado hacia la profundidad en los modelos MoE?
"Derinlik Oriented Sensitivity Analysis es una metodología que examina sistemáticamente el efecto de diferentes capas de modelos de mezcla de productos (MoE) y expertos en estas capas (expertos) sobre el rendimiento general del modelo. El objetivo es explorar las formas de crear modelos más pequeños o más rápidos sin pérdida de rendimiento determinando qué partes del modelo son más críticas. Este análisis revela su importancia en estructuras complejas MoE como Qwen3.6-35B-A3B, basadas en valores de peso (magnitud) de cada capa y especialista.
Mixture-of-Experts (MoE) Architecture and Working Principle
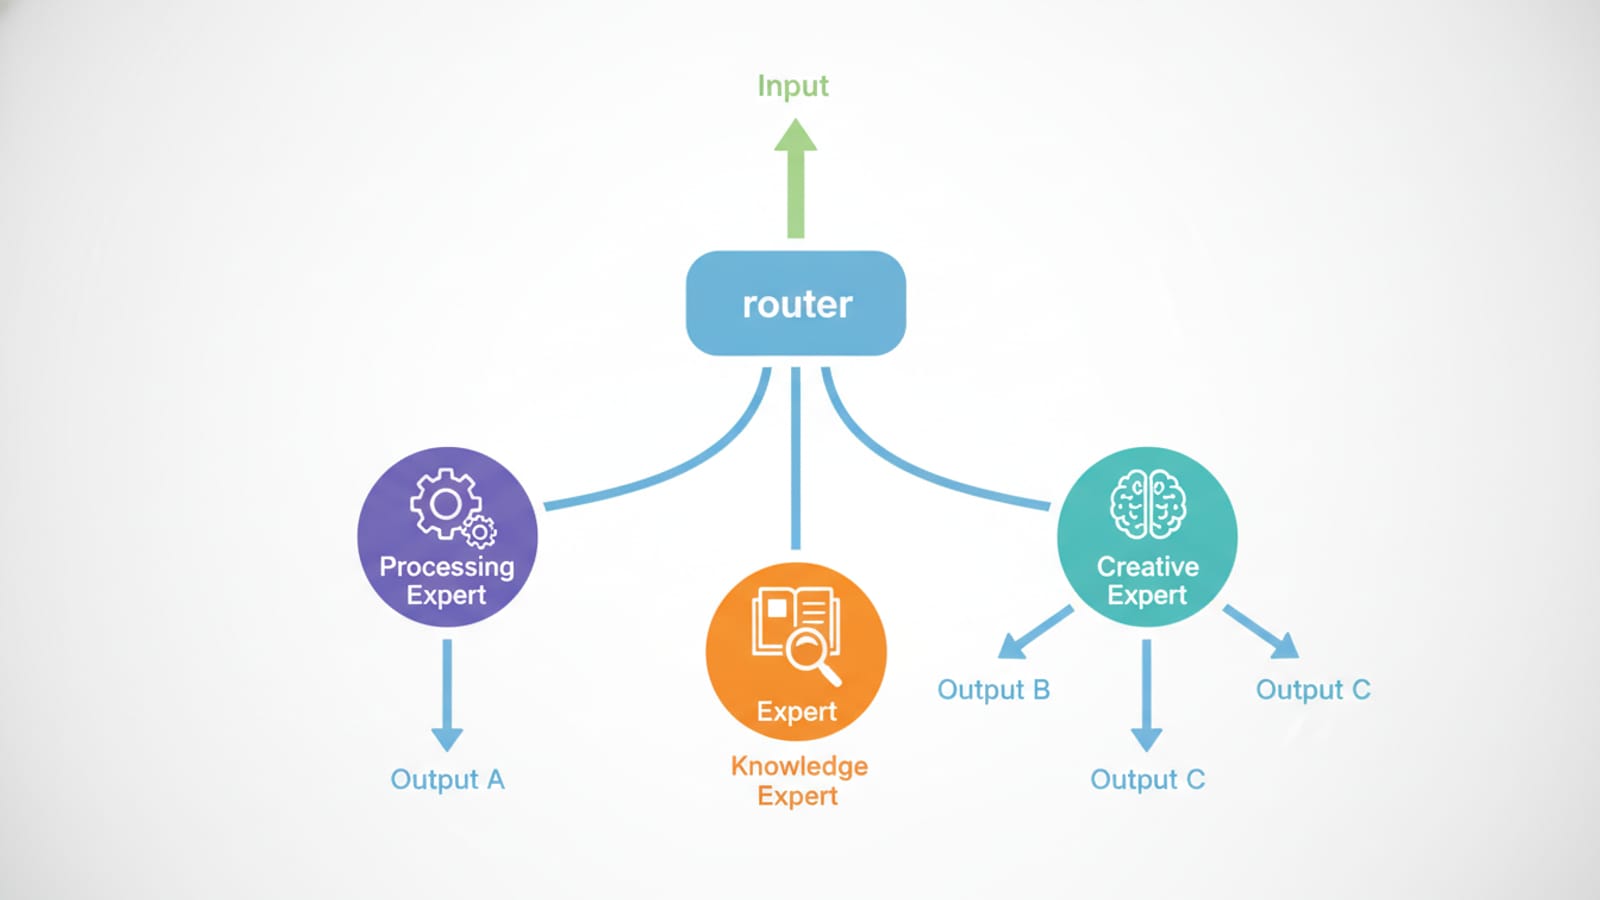
MoE es una estructura innovadora que divide un gran modelo de inteligencia artificial en múltiples pequeñas subredes especializadas (redes comunitarias). Cada entrada (por ejemplo, una pieza de texto) se dirige únicamente a las redes especializadas más relevantes a través de un mecanismo de redirección (router). El enfoque de esta rara activación (activación de la parra) aumenta el número total de parámetros del modelo, no aumenta el costo del cálculo proporcionalmente. Tradicional (intencional) proporciona menor costo de cálculo y más rápido entrenamiento/grainabilidad al 70% que BBDs. Por ejemplo, el modelo Qwen3.6-35B-A3B, 40 capa MoE, 256 expertos por capa y tiene la estructura "top-8" donde se seleccionan los mejores 8 expertos para cada ficha. Los expertos a menudo se especializan en trabajos más finos, como procesos lingüísticos o tareas significativas.
Importancia de la compresión en modelos de lenguaje grande (BBD)
Hoy los BBD exhiben increíbles talentos alcanzando billones de parámetros. Sin embargo, este tamaño crea altos costos de cálculo, energía y memoria que hacen la distribución de modelos en aplicaciones mundiales reales. Las técnicas de compresión modelo son vitales para aliviar estos desafíos y asegurar que los BBD trabajen más eficazmente con menos recursos. Los principales métodos de compresión incluyen:
Quantumization (Quantization): Tipos de datos de precisión más bajos de parámetros (por ejemplo. El tamaño y la velocidad del modelo se mejoran mediante la conversión de FP16 a INT-8.
Budama (Pruning): Los parámetros o conexiones menos importantes del modelo se eliminan permanentemente. Esto reduce la complejidad y la utilización de recursos del modelo.
Destilación de información (destilación de conocimiento): El conocimiento de un modelo "estudiante" más grande es proporcionado por compresión transfiriendo a un modelo "estudiante" más pequeño.
Sensitivity Analysis and Magnitude-Based Expert Maskin g
El artículo pretende determinar qué capas o expertos de MoE tienen el mayor impacto en el rendimiento del modelo para el análisis de precisión basado en capas, compresión modelo y optimización del rendimiento. Estos tipos de análisis son importantes para comprender el funcionamiento interno del modelo y detectar los componentes más críticos. La expresión "Magnitude-Based Expert Masking" se refiere a una técnica de cálculo o análisis, que incluye enmascarar o desactivar otros menos importantes evaluando la importancia de los valores de peso según el tamaño de los expertos. Este enfoque es una manera de optimizar la característica actual del silencio en los modelos MoE o crear más dilución.
Contexto sectorial: Qwen3.6-35B-A3B y MoE Usage
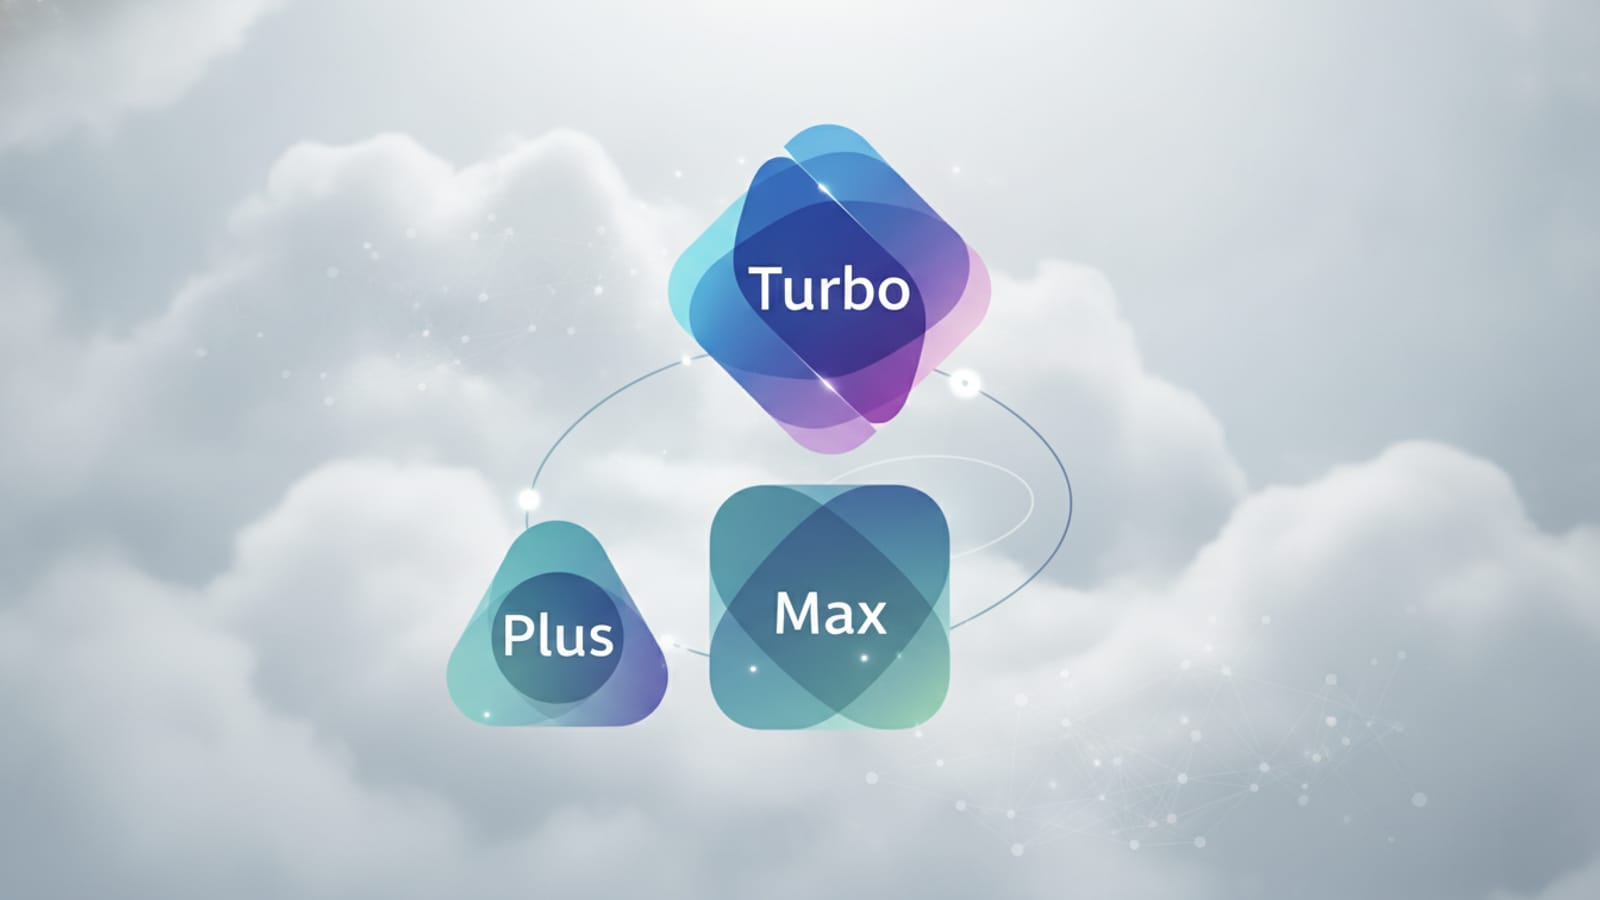
El modelo Qwen3.6-35B-A3B analizado por Alibaba Cloud es miembro de la familia modelo de lenguaje grande de Qwen (Tongyi Qianwen) desarrollada por Qwen. La familia Qwen está construida sobre arquitecturas basadas en Transformer y es especialmente reconocida por sus capacidades multilingües, en particular con un fuerte desempeño en las tareas de idioma chino e inglés. Esta variante con 35 mil millones de parámetros del modelo contiene 40 capas MoE y 256 expertos por capa. Los modelos Qwen tienen diferentes niveles de tamaño y rendimiento como Max, Plus y Turbo. La arquitectura MoE se utiliza ahora en modelos líderes como Mixtral 8x7B de Mistral AI, Grok-1 de xAI, DeepSeek-V3 y Databricks.
Qué es la Comunidad
Supporters
Los partidarios de la mezcla de productos (MoE) se destacan el potencial de eficiencia y escalabilidad del cálculo que estas estructuras ofrecen según modelos intensivos tradicionales. MoEs hace modelos con trilyons aún más manejables, proporcionando tiempos de entrenamiento y explotación más rápidos. De esta manera, se abre una amplia gama de uso de BBDs más grandes y talentosos.
Noticias
Algunos expertos y críticos prestan atención a la complejidad y sutilezas de los modelos MoE. El funcionamiento correcto del mecanismo de enrutamiento (router) crea un reto de ingeniería difícil para especializar eficientemente en los expertos y optimizar todo el modelo. Además, la rara estructura de los modelos MoE puede dar lugar a una eficiencia total en algunas arquitecturas de hardware.
Preguntas frecuentes
¿Por qué son tan populares los modelos MoE?
Los modelos MoE son populares especialmente debido a la capacidad de crear modelos eficientes en el campo de los modelos de lenguaje grande (BBD) en términos de alto rendimiento y cálculo. Gracias a la activación de la cruz, permiten miles de millones de parámetros trabajar con menos recursos y eliminar rápidamente.
¿Por qué la compresión Modelo es crítica para BBDs?
La compresión del modelo es fundamental para reducir los altos costos de cálculo, memoria y energía de los enormes BBD de hoy. Estas técnicas permiten a los modelos trabajar en dispositivos más pequeños (por ejemplo, teléfonos móviles) y ayudar a la inteligencia artificial a llegar a un público más amplio reduciendo los costos de distribución.
Qwen3.6-35B-A3B ¿Qué características tiene?
Qwen3.6-35B-A3B es un Gran Modelo de Lengua de la familia Qwen de Alibaba Cloud. Esta variante con 35 mil millones de parámetros está diseñada para tener éxito en tareas particularmente eficientes y multilingües con características como 40 capa Mixture-of-Experts (MoE), 256 expertos por capa y "top-8 routing".
¿Qué quiere decir Magnitude-Based Expert Masking?
Masking de expertos basado en la magnitud es menos importante especialistas temporalmente o permanentemente técnica discapacitada, evaluando la importancia de los expertos en los modelos MoE según el tamaño de los valores de peso. Este método ayuda a determinar qué expertos en los procesos de compresión y optimización modelo pueden ser transmitidos o priorizados.
El futuro de los grandes modelos de idiomas no sólo está creciendo su tamaño, sino que también los moldea para que sean más inteligentes y eficientes. El análisis de precisión orientado hacia la profundidad en los modelos MoE puede ser un hito importante en esta carretera. Comprender la contribución de rendimiento de cada capa y especialista está buscando nuevas puertas a los desarrolladores para construir sistemas de IA más ágiles, más fuertes y sostenibles. Tal investigación ofrece información crítica para acelerar la integración de las tecnologías de inteligencia artificial en nuestras vidas cotidianas.
AdminABD Özel Şirketlere Siber Operasyon Yetkisi Verdi
Yapay Zeka Mühendisliği Olan Üniversiteler 2026
Artículos relacionados
Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión