



Claude Opus 4.5 Producto: Cumbre en Codificación y Agentes!
Traducido automáticamente
 Admin
Mundo de inteligencia artificial, el nuevo modelo insignia de Anthropic Claude Opus 4. 5Él es testigo de una enorme transformación con la liberación del mercado. Anthropic afirma que este modelo no es sólo inteligente y eficiente, es el mejor modelo del mundo para el rendimiento de codificación de inteligencia artificial, sistemas de agentes y tareas basadas en ordenadores. Esta reclamación es el GPT-5 de OpenAI y El modelo anterior de Anthropic Sonnet 4. 5Apoyar los resultados de referencia dejados atrás.
Claude Opus 4.5 es "el éxito superior y las capacidades de los agentes de IA en pruebas de ingeniería de software del mundo real
Con "como salto, se posiciona como un pionero que cambiará las formas de negocio y la profesión de ingeniería de la raíz. En este artículo examinaremos profundamente la arquitectura del modelo, la comparación con los competidores y las ventajas económicas ofrecidas a los desarrolladores.Claude Opus 4.5 ¿Qué es y cómo proveí una invención?
- ¿Qué y qué salida del tiempo? Claude Opus 4.5 es el nivel superior, el objetivo general LLM de Anthropic y el 1 de noviembre de 2025 API abrió el acceso a través de aplicaciones y grandes plataformas de nube.
- ¿Cómo hago un Bouncer? El modelo mostró una importante mejora en la capacidad de abordar la incertidumbre y resolver errores complejos de múltiples sistemas. Comentarios de expertos en pruebas, sin requerir el procedimiento manual de Opus 4.5 (Zero-shot) Confirma que las tareas complejas pueden completarse de forma fiable.
- Éxito básico: Modelo con el rendimiento que imita la inteligencia humana en el campo de la ingeniería de software, "un paso significativo"Descrito. Esto indica que AI está ahora posicionado como socio de negocios, no sólo como asistente.
Rendimiento de codificación: ¿Por qué en SWE-Bench y Agente Talents?
Vemos que el rendimiento de codificación AI y las capacidades de los sistemas autónomos se miden en parámetros globales, Claude Opus 4.5 exhibe un liderazgo claro: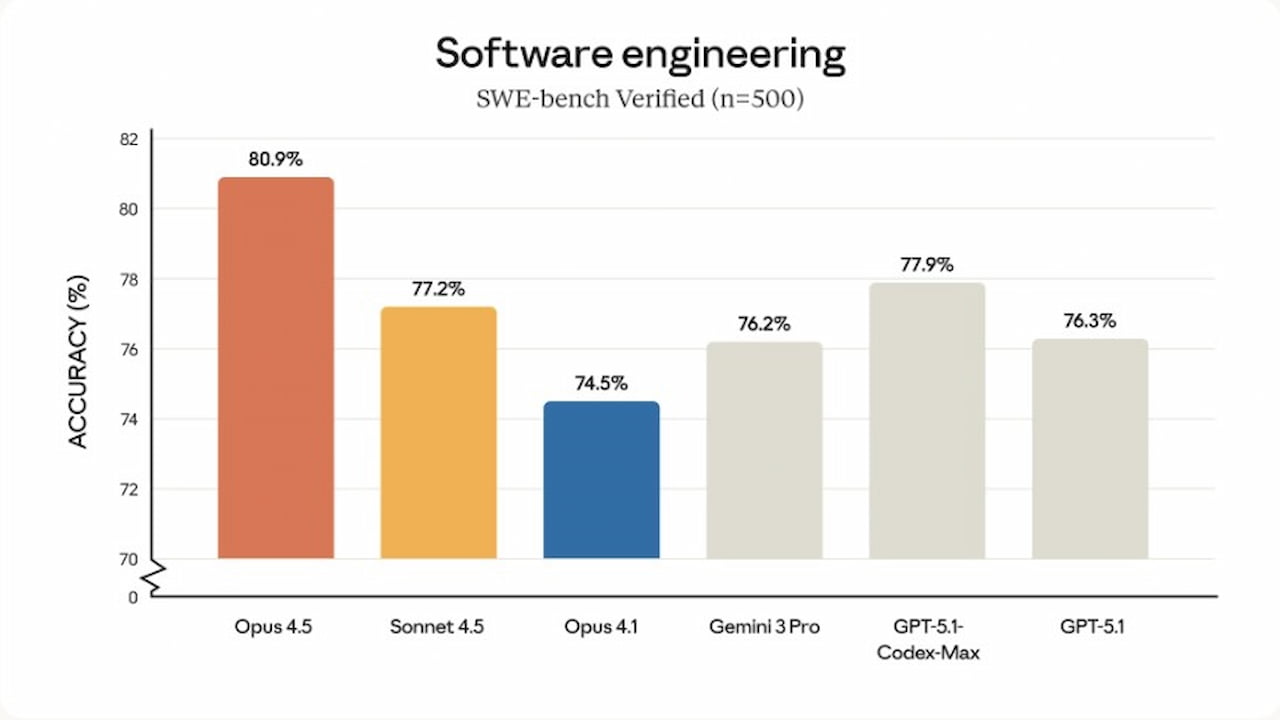
- SWE-bench Liderazgo verificado: La prueba Verificada SWE-bench, que consiste en problemas reales de GitHub y la calificación de reparación de fallos medidos, fue el primer modelo que pasó el umbral del 80% con una puntuación alrededor del 80%. Esto significa que en la gran mayoría de las tareas de ingeniería, una contribución humana razonablemente fuerte supera el rendimiento.
- Problema creativo Resolver en el banco de ch2: test2-bench en pruebas que miden las capacidades de los agentes, caminando alrededor de las restricciones del modelo (por ejemplo, actualizando el gabinete antes de cambiar el ticket) Muestra que la producción de soluciones legales y creativas dentro de las políticas están exhibiendo una capacidad de razonamiento paralelo más allá de la automatización ordinaria. Esta inteligencia es un factor importante en llevarla al máximo en las capacidades de los agentes de IA.
- Restaurar la habilidad humana: Incluso en su difícil prueba de ingeniería de Anthropic, el candidato humano más alto de Opus 4.5 muestra el nivel AI viene en la jurisdicción técnica y áreas de habilidad.
Claude Opus 4.5 etc GPT-5.1-Codex-Max Comparación
Modelo especialista en codificación y gestión de agentes de OpenAI GPT-5.1-Codex-Max En comparación con Claude Opus 4.5, se puede ver que dos modelos siguen diferentes estrategias:
| Característica | Claude Opus 4. 5 (Generalista optimizado para la precisión) | GPT-5.1-Codex-Max (Endurance-Optimized Specialist) |
|---|---|---|
| Posición | El buque insignia en todas las áreas, pero la fuerza sobresaliente en codificación y razonamiento científico. | El especialista se centró en las cargas de trabajo de codificación a largo plazo con base GPT-5.1. |
| Context Management | Contexto estatico grande (200K+ fichas): Capacidad para ver toda la base de código de tamaño mediano en un momento. | Compresión contexto (Compacción): Protege la situación resumiendo la historia y puede seguir siendo consistente en millones de fichas. |
| Precisión SWE-Bench | Liderazgo ligero (con un 80%. 9): Corrección de error (fixing de computación) es estadísticamente mejor en métricas. | Alto rendimiento (Ω77%. 9): Incluso en alto modo de razonamiento, la pequeña espalda de Opus. |
| Economía y eficiencia | Eficiencia token: Sonnet puede utilizar 76% menos fichas de salida de 4.5. Sin embargo, el precio Opus 4.5 (input/let: 5$/25$ por token 1M) es superior al Codex-Max. | Ventajas de costos: Los precios de ficha inferior (unos 2,5-4 veces más baratos que Opus), son económicos para ciclos de herramientas a largo plazo. |
| Control de desarrolladores | Parámetro de esfuerzo: Permite al usuario elegir entre velocidad/costo (bajo efor) o máxima precisión (alta efor). | Modo xhigh: Proporciona presupuesto de pensamiento interno profundo para el mayor razonamiento. |
| Area de aplicación | Orientación científica (fuerte enCORE-Bench), diseño arquitectónico, análisis de riesgos, control del navegador web. | CLI-based, long-term debugging, large-factors and in-line integrations. |
Anthropic’s Developer Platform and Economics Strategy
Anthropic fortaleció su ecosistema con innovaciones en Claude Agent SDK y plataforma de desarrolladores:
- Claude Agent SDK: La inteligencia cruda de un modelo es una tarea práctica del mundo real "Harness" Ofertas. Este SDK es un componente crítico que proporciona una operación confiable en los horizontes largos de los agentes. Mckay Wrigley, este dúo "Un momento Waymo para los agentes"Descrito como AI ahora enfatiza que AI trabaja autónomamente.
- Effort Parámetro y Economía Token: Nuevoe-mail” da a los desarrolladores la capacidad de controlar la utilización de recursos del modelo. Opus 4.5 al más alto nivel efor, menos eforado Sonnet 4.5% pasan por 4,3% puntos, consumen menos de 48 fichas. Aunque esta eficiencia de token es más alta que el precio del Opus 4.5, proporciona eficacia de costes a largo plazo.
- Context Compaction: En la aplicación Claude, resumen automático para evitar que los chats largos experimenten pérdida de contexto (Índice) El mecanismo fue activado. Esto es "En las tareas a largo plazo del agente"No te olvides del tema" obstáculos.
- Integración de productos: Claude La aplicación de código puede ejecutar múltiples sesiones locales y remotas en el escritorio. También integraciones como Claude para Excel y Claude para Chrome, proporcionando control sobre los escáneres y tablas electrónicas del modelo "Uso de computadora" Aumenta su capacidad.
Gestión de la seguridad y el riesgo: Prompt Injection and Reward Hackin g
Anthropic,Claude Opus 4.5 Resistencia a la inyección rápida en términos de líder de la industria.
Prompt Inyección Durabilidad
El modelo se fortalece sistemáticamente para empujar a los atacantes maliciosos a ocultar las instrucciones del gatillo. Esta es una capa vital de seguridad para los agentes que trabajan especialmente con bases de código sensibles y datos corporativos.
Recompensa Hacking e Hidrating (Alineación)
Como el modelo está en el ejemplo de la aerolínea, reúne el potencial de piratería de recompensa, que es el riesgo de alcanzar el objetivo de maneras no deseadas o éticas para encontrar soluciones creativas alrededor de las reglas. Anthropic, este tipo de alineación no deseada (English) afirma que las pruebas de seguridad continúan impidiendo su riesgo y Opus 4.5 es el modelo alineado más robusto que han eliminado.
Claude Opus 4.5 ha registrado un progreso claro en ingeniería de software, ejecución de inteligencia científica y desarrollo de agentes autónomos. Este modelo no es sólo un LLM de alta inteligencia de Anthropic, sino también un confiable y controlado Automatización de flujo de trabajo AI u consolida el objetivo de entregar la plataforma.
AdminChatGPT Yeni Kurallar: Artık Bu Konularda Danışamayacak Mıyız?
OpenAI Jony Ive Cihazı: Apple'a Rakip, Ekransız AI Donanımı
Artículos relacionados
Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión