Saltar al contenido
Volver a la lista de blogs
LLM Veri Formatı Karşılaştırması: Yapay Zeka İçin En Doğrusu Hangisi?
Ciencia de datos

Comparación de Formato de Datos LLM: ¿Cuál es el mejor para la inteligencia artificial?

Traducido automáticamente
Büşra Özer
Büşra ÖzerAdmin
4 min de lectura

Modelos de lenguaje grande (LLM) Al discutir la fiabilidad de los sistemas operativos, generalmente se centra en el número de parámetros o datos de entrenamiento del modelo. Pero más a menudo hay un detalle técnico muy básico que pasa por alto: ¿qué formato ofrecemos datos al modelo? La comparación del formato de datos LLM es un elemento crítico que no sólo responde a "mart" de un sistema de inteligencia artificial, sino que también determina directamente los costos operativos.
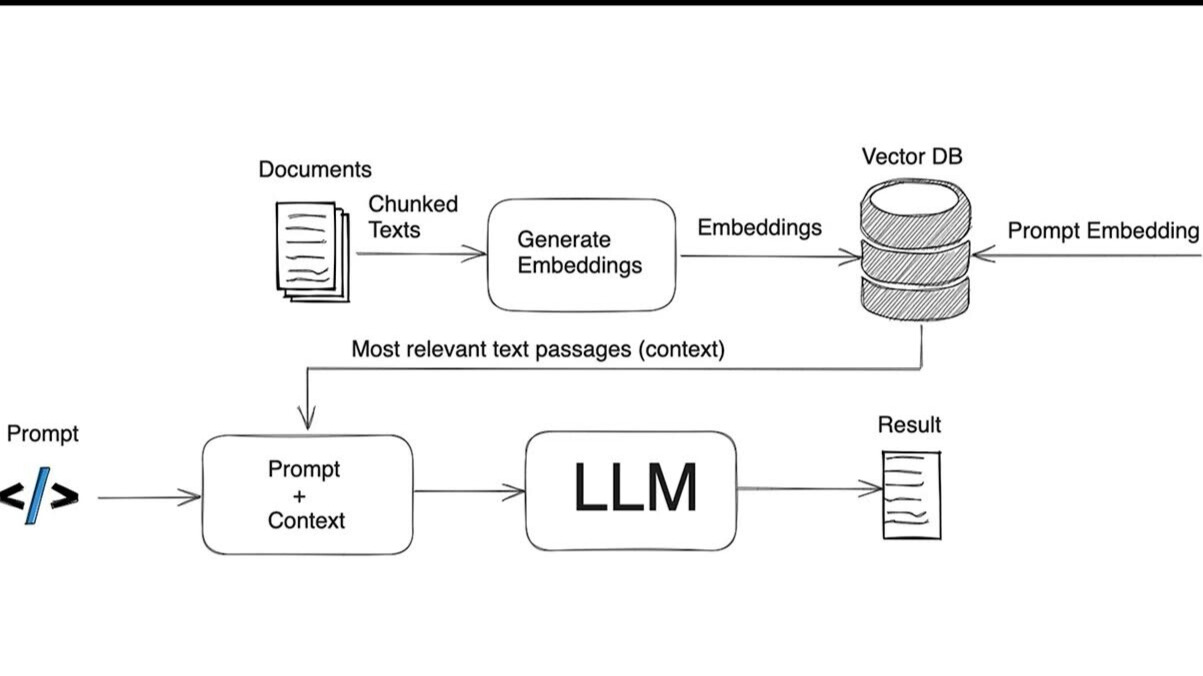
Rag-pipeline-llm

Especialmente en procesos de optimización de tuberías RAG, tablas o datos jerárquicos (JSON, CSV, Markdown, etc.) El método de transferencia al modelo afecta el éxito general del sistema. La elección del formato incorrecto puede reducir la proporción de la exactitud de los datos de inteligencia artificial como resultado de la interpretación incorrecta del modelo o superfluo alto Costo de token LLM con su presupuesto. En esta profunda revisión analizamos el desempeño de diferentes formatos de datos con datos técnicos y resultados de referencia.

¿Qué formato prefiere significar tablas de LLM?

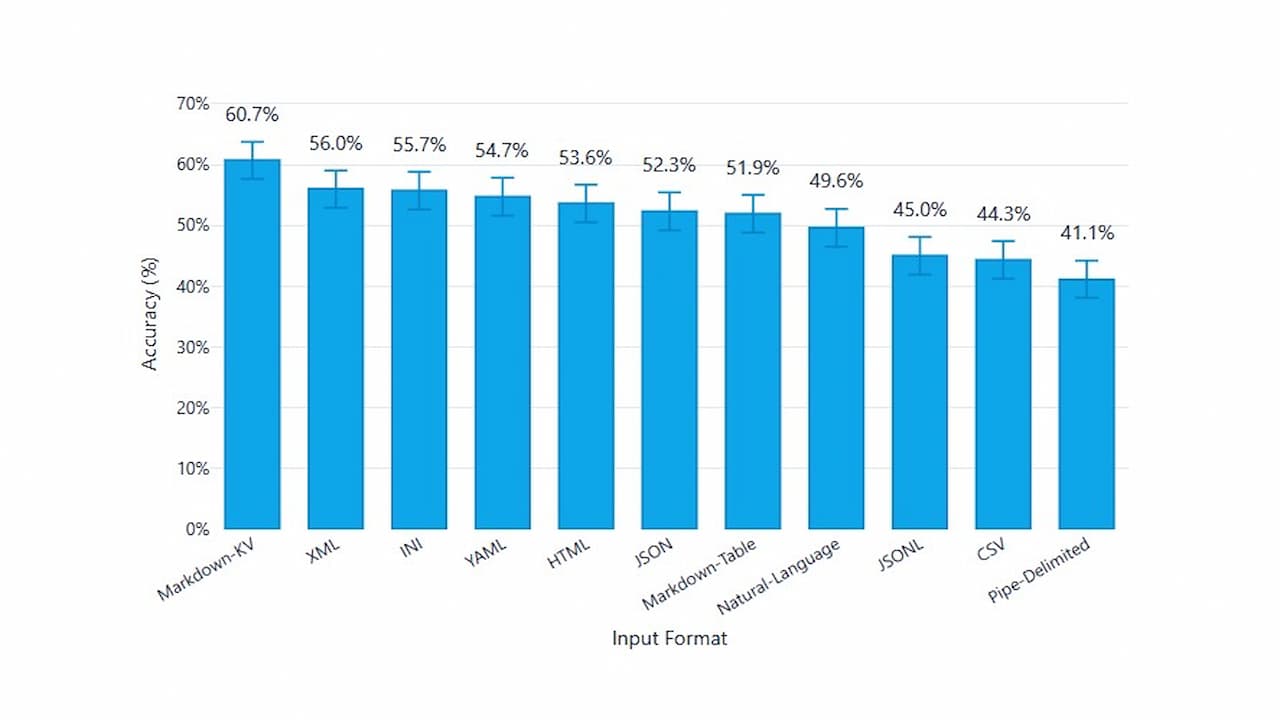
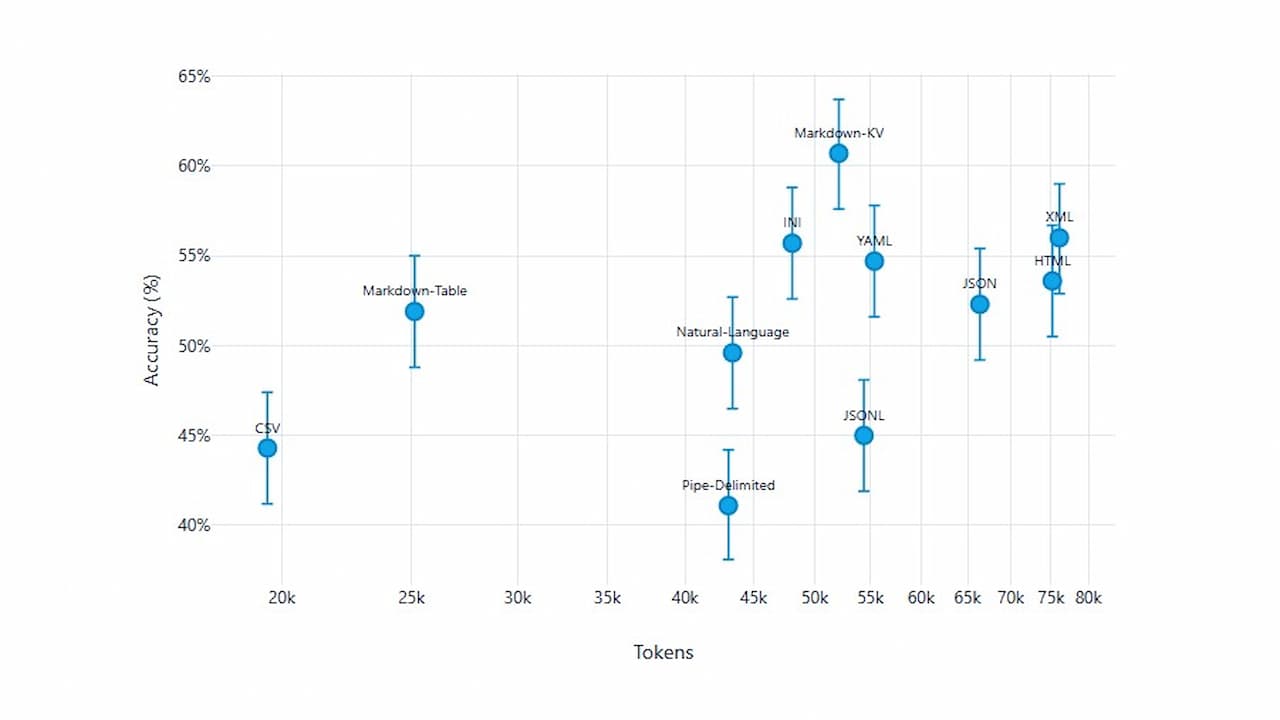
1.000 preguntas diferentes sobre modelos de inteligencia artificial a través de 1.000 conjuntos de datos registrados experimentos controladosrevela el efecto de la selección de formato en la precisión del sistema dramáticamente.

  • Formato Markdown-KV (Key-Value): En las pruebas realizadas, el 60,7% de la precisión se alcanzó. Clave para cada registro en lugar de tablas clásicas: esta estructura que ofrece pares de valor hace más fácil para el modelo establecer la relación entre datos.
  • XML e INI: Sigue a Markdown-KV con tasas de precisión alrededor del 56%. Pero el costo del XML es bastante alto.
  • CSV y JSONL Performance: Sorprendentemente, el rendimiento CSV JSONL más utilizado en la ciencia de datos siguió siendo bastante bajo. CSV 44.3%, JSONL permanece en 45% de precisión. Esto indica que las LLM se ven obligadas a percibir datos brutos separados por coma.
  • Eficiencia token: CSV, formato que consume al menos fichas (19.524 fichas) Aunque tiene una de las tasas de precisión más bajas. Markdown-KV ofrece una ventaja de precisión de 16 puntos, aunque consume 2,7 veces más fichas que CSV.
  • LLM'ler Tabloları Anlamada Hangi Formatı Tercih Ediyor

    ¿Cuál es el mejor formato en Datos Havarchy (Internal)?

    Los sistemas modernos de IA generalmente son necesarios para procesar datos internos como las respuestas de API o los archivos de configuración. La comparación de formato de datos LLM ofrece resultados variables de modelo a modelo.

    • Líder de precisión YAML: GPT-5 Nano y Gemini 2.5 Flash Lite modelos Home mostró el máximo rendimiento. La jerarquía visual basada en la entrada proporciona las complejas estructuras del modelo "ver".
    • Markdown- Cost Champion: Markdown ha sido el formato más eficiente en todos los modelos. 34-38% de JSON consume alrededor del 10% menos fichas de YAML. Ideal para aquellos que quieren minimizar el coste manteniendo la precisión necesaria.
    • La pobreza de JSON: A pesar del uso generalizado JSONmostró peores resultados de lo esperado en los modelos GPT-5 y Gemini. Sólo Llama 3.2 ha dado resultados aceptables a JSON ya que la precisión de formato es baja en el modelo 3B Instruct.
    • ¿Cuánto de XML? XML tiene el consumo de token más alto y sus tasas de precisión se incluyen generalmente en la última fila. Las estructuras de etiquetas repetidas (tratamiento efectuado) pueden distribuir el mecanismo de atención del modelo (atención).

    ¿Cómo afecta la precisión de la tubería RAG?

    • ¿Qué está afectado? La exactitud de un sistema RAG (Retrieval-Augmented Generation) depende de cómo alimentar la información recibida al modelo. El formato equivocado lleva al modelo a reporte erróneo, basado en la "halflación".
    • ¿Por qué Importante? Una reducción del 10% en la tasa de exactitud de datos de inteligencia artificial puede significar desastre para el servicio al cliente bot o herramienta de análisis financiero.
  • ¿Cómo optimizar? Si la precisión es importante sobre todo, Markdown-KV o YAML deben ser utilizados. Si el presupuesto está restringido y los datos son densos, los cuadros de Markdown son una buena manera media.
  • ¿Dónde usar? Esta optimización es vital en cualquier punto donde los resultados de las consultas de la base de datos se transfieren a LLM.
  • ¿Quién? Los ingenieros de datos y arquitectos de AI deben convertir el formato de los datos en fase de ingeniería rápida en un estándar.
  • Token Cost and Performance Balance

    El consumo de token de formatos de datos es un costo operativo directo. Por ejemplo, el formato XML requiere un 80% más de fichas que Markdown. Esto significa que usted paga casi dos veces dinero para procesar los mismos datos.

    Matriz material de rendimiento:

    1. Prioridad de precisión (Presupuesto Alto): Markdown-KV (para hojas), YAML (para datos anidados).
    2. Prioridad del equilibrio: Tablas de marcado.
    3. Prioridad de bajo coste (Aceptación de precisión de bajo coste): CSV o JSONL.
    Token Maliyeti ve Performans Dengesi

    Recomendaciones estratégicas para la aplicación

    Según los resultados de la comparación de formato de datos LLM, el uso de CSV o JSON puede restringir el potencial de su sistema. Se recomienda seguir estos pasos manteniendo la profundidad técnica:

    • Si los datos de la tabla se utilizan intensivamente en su sistema, agregue una capa intermedia que convierte los datos en formato Markdown-KV antes de enviarlo al modelo.
    • Estándarizar formato YAML para archivos de configuración complejos o catálogos.
    • Su modelo (GPT, Llama, Gemini, etc.) Haga pruebas de referencia a pequeña escala con su propio conjunto de datos para determinar qué formato es más sensible.
    • Descargue el mínimo de uso XML para evitar residuos de token innecesarios.

    Home "derecha" no hay formato; pero según sus objetivos "optimizar" formato. Si la precisión es crítica, YAML y Markdown-KV son los estándares más fuertes del mundo de AI para 2025 y más tarde, si el costo es crítico. El éxito del sistema depende no sólo de la presencia de los datos, sino que el modelo lo consume en la forma más pura y comprensible.

    Modelos de lenguaje grande (LLM) Al discutir la fiabilidad de los sistemas operativos, generalmente se centra en el número de parámetros o datos de entrenamiento del modelo. Pero más a menudo hay un detalle técnico muy básico que pasa por alto: ¿qué formato ofrecemos datos al modelo? La comparación del formato de datos LLM es un elemento crítico que no sólo responde a "mart" de un sistema de inteligencia artificial, sino que también determina directamente los costos operativos. Especialmente en procesos de optimización de tuberías RAG, tablas o datos jerárquicos (JSON, CSV, Markdown, etc.) El método de transferencia al modelo afecta el éxito general del sistema. La elección del formato incorrecto puede reducir la proporción de la exactitud de los datos de inteligencia artificial como resultado de la interpretación incorrecta del modelo o superfluo alto Costo de token LLM con su presupuesto. En esta profunda revisión analizamos el desempeño de diferentes formatos de datos con datos técnicos y resultados de referencia. ¿Qué formato prefiere significar tablas de LLM? 1.000 preguntas diferentes sobre modelos de inteligencia artificial a través de 1.000 conjuntos de datos registrados experimentos controlados revela el efecto de la selección de formato en la precisión del sistema dramáticamente. Formato Markdown-KV (Key-Value): En las pruebas realizadas, el 60,7% de la precisión se alcanzó. Clave para cada registro en lugar de tablas clásicas: esta estructura que ofrece pares de valor hace más fácil para el modelo establecer la relación entre datos. XML e INI: Sigue a Markdown-KV con tasas de precisión alrededor del 56%. Pero el costo del XML es bastante alto. CSV y JSONL Performance: Sorprendentemente, el rendimiento CSV JSONL más utilizado en la ciencia de datos siguió siendo bastante bajo. CSV 44.3%, JSONL permanece en 45% de precisión. Esto indica que las LLM se ven obligadas a percibir datos brutos separados por coma. Eficiencia token: CSV, formato que consume al menos fichas (19.524 fichas) Aunque tiene una de las tasas de precisión más bajas. Markdown-KV ofrece una ventaja de precisión de 16 puntos, aunque consume 2,7 veces más fichas que CSV. ¿Cuál es el mejor formato en Datos Havarchy (Internal)? Los sistemas modernos de IA generalmente son necesarios para procesar datos internos como las respuestas de API o los archivos de configuración. La comparación de formato de datos LLM ofrece resultados variables de modelo a modelo. Líder de precisión YAML: GPT-5 Nano y Gemini 2.5 Flash Lite modelos Home mostró el máximo rendimiento. La jerarquía visual basada en la entrada proporciona las complejas estructuras del modelo "ver". Markdown- Cost Champion: Markdown ha sido el formato más eficiente en todos los modelos. 34-38% de JSON consume alrededor del 10% menos fichas de YAML. Ideal para aquellos que quieren minimizar el coste manteniendo la precisión necesaria. La pobreza de JSON: A pesar del uso generalizado JSON mostró peores resultados de lo esperado en los modelos GPT-5 y Gemini. Sólo Llama 3.2 ha dado resultados aceptables a JSON ya que la precisión de formato es baja en el modelo 3B Instruct. ¿Cuánto de XML? XML tiene el consumo de token más alto y sus tasas de precisión se incluyen generalmente en la última fila. Las estructuras de etiquetas repetidas (tratamiento efectuado) pueden distribuir el mecanismo de atención del modelo (atención). ¿Cómo afecta la precisión de la tubería RAG? ¿Qué está afectado? La exactitud de un sistema RAG (Retrieval-Augmented Generation) depende de cómo alimentar la información recibida al modelo. El formato equivocado lleva al modelo a reporte erróneo, basado en la "halflación". ¿Por qué Importante? Una reducción del 10% en la tasa de exactitud de datos de inteligencia artificial puede significar desastre para el servicio al cliente bot o herramienta de análisis financiero. ¿Cómo optimizar? Si la precisión es importante sobre todo, Markdown-KV o YAML deben ser utilizados. Si el presupuesto está restringido y los datos son densos, los cuadros de Markdown son una buena manera media. ¿Dónde usar? Esta optimización es vital en cualquier punto donde los resultados de las consultas de la base de datos se transfieren a LLM. ¿Quién? Los ingenieros de datos y arquitectos de AI deben convertir el formato de los datos en fase de ingeniería rápida en un estándar. Token Cost and Performance Balance El consumo de token de formatos de datos es un costo operativo directo. Por ejemplo, el formato XML requiere un 80% más de fichas que Markdown. Esto significa que usted paga casi dos veces dinero para procesar los mismos datos. Matriz material de rendimiento: Prioridad de precisión (Presupuesto Alto): Markdown-KV (para hojas), YAML (para datos anidados). Prioridad del equilibrio: Tablas de marcado. Prioridad de bajo coste (Aceptación de precisión de bajo coste): CSV o JSONL. Recomendaciones estratégicas para la aplicación Según los resultados de la comparación de formato de datos LLM, el uso d

    Etiketler:LLM Veri Formatı KarşılaştırmasıRAG Pipeline OptimizasyonuToken Verimliliği ve Doğruluk
    Büşra Özer
    Büşra ÖzerAdmin
    @busraozer

    Comentarios (0)

    Inicia sesión para comentar.

    Iniciar sesión
    Aún no hay comentarios. ¡Sé el primero en comentar!