



DeepSeek V3.1 ¿Qué es el modelo abierto de inteligencia artificial soldada?
Traducido automáticamente
Iniciativa de inteligencia artificial basada en China DeepSeekEl nuevo modelo del 21 de agosto de 2025 anunció DeepSeek V3.1. Este modelo de inteligencia artificial de código abierto, que llama la atención con su arquitectura híbrida, capacidad de contexto de 128K y acceso a API de bajo coste, no sólo está en el campo tecnológico, sino también en el entorno de economía e innovación global.
DeepSeek V3.1 ¿Qué?
DeepSeek V3. 1 Es el modelo de lenguaje más nuevo desarrollado por DeepSeek de las crecientes iniciativas de inteligencia artificial en China y publicado como un modelo de inteligencia artificial de código abierto. La frase “fuente abierta” aquí significa que el código, los parámetros y las directrices de uso del modelo están abiertos a todos. Esta situación democratiza los procesos de desarrollo de inteligencia artificial; significando no sólo empresas de tecnología gigante, universidades, investigadores independientes e iniciativas pequeñas también son capaces de utilizar esta tecnología.
DeepSeek V3.1 es un enorme modelo de inteligencia artificial con 671 mil millones de parámetros. El parámetro es el nombre dado a las variables establecidas en el proceso de aprendizaje de la inteligencia artificial. A medida que el número de parámetros de un modelo aumenta la capacidad de aprender relaciones más complejas. Sin embargo, DeepSeek utiliza sólo 37 mil millones activos en lugar de ejecutar todos estos parámetros simultáneamente. Este método es conocido como Mixture of Experts (MoE) en la literatura de inteligencia artificial.
En la arquitectura MoE, diferentes redes especializadas se activan en ciertas tareas. Este modelo funciona tanto más rápido como eficientemente. Por ejemplo, cuando un usuario pide una pregunta de programación, sólo se activa el especialista en codificación; el idioma y el verano trabaja cuando viene la pregunta de literatura. Esta estructura es posible realizar un rendimiento similar o superior con menor consumo de energía que los competidores de DeepSeek V3.1.
DeepSeek V3.1 Características
DeepSeek V3.1 no es sólo fuente abierta porque es un modelo que atrae la atención en el mundo de la inteligencia artificial, sino que también tiene características técnicas innovadoras. Muchos detalles de la arquitectura modelo a la ventana contextual están diseñados para responder a diferentes necesidades.
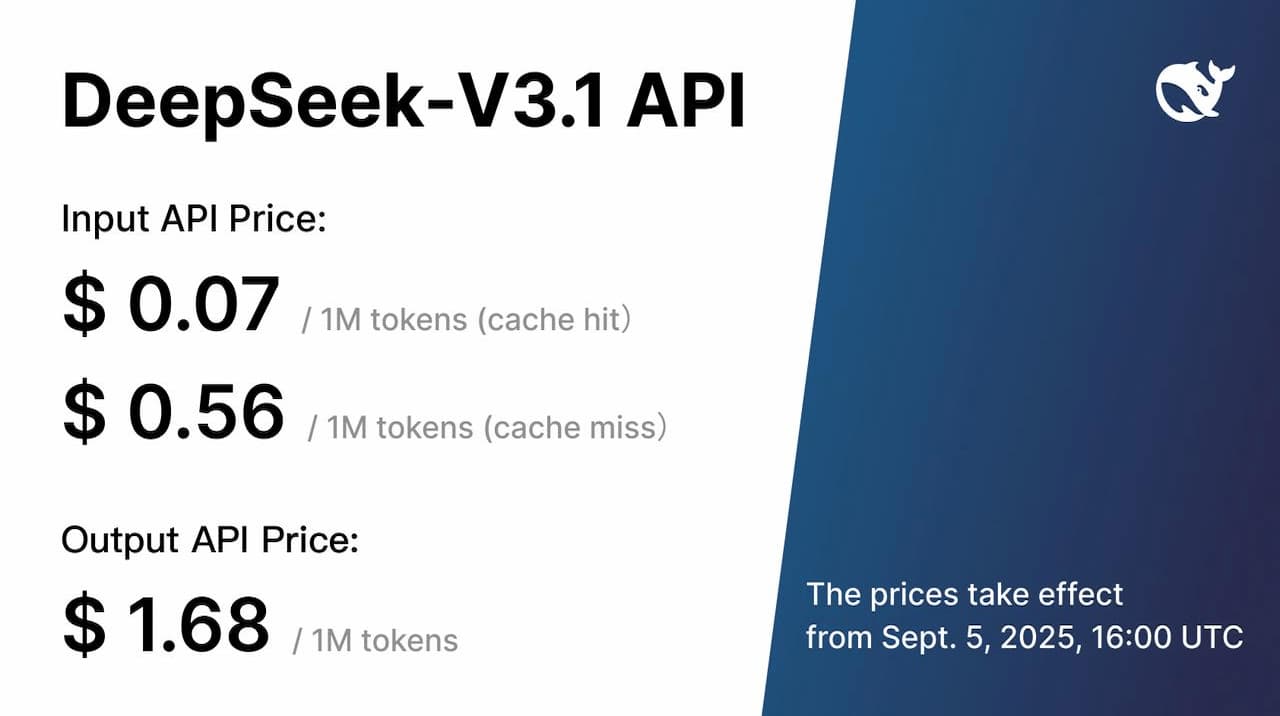
Una de las características más habladas de DeepSeek V3.1, sistema de modo híbrido. El modelo tiene dos modos de trabajo diferentes:
Modo de pensamiento (modo de caída): El modelo pasa por el proceso de “pensamiento interno” antes de resolver una pregunta compleja. Esto significa los pasos lógicos para simular la mente antes de producir la respuesta de AI. El modo de pensar es más lento, pero produce respuestas más profundas y coherentes.
Modo no pensado (modo de respuesta intencionada): El modelo produce una respuesta rápida directamente. Este modo es preferido en preguntas más superficiales o charlas diarias. Esta función proporciona a los usuarios una gran flexibilidad. Por ejemplo, un desarrollador de software puede elegir el modo “pensar” para un problema complejo de depuración, una empresa que ha establecido el chatbot de soporte al cliente puede responder rápidamente eligiendo el modo “no-pensar”.
Otra característica del modelo es el método MoE – Mixture of Experts (Experts Mix). En este sistema existen numerosos submodels especializados en diferentes asuntos. Cuando el usuario da un comando, el modelo activa sólo los necesarios de estos submodels. Este enfoque tiene dos ventajas importantes:
No se gasta energía de procesamiento innecesaria, por lo que el costo se reduce.
Gracias a la combinación de modelos especializados, la tasa de precisión de las respuestas aumenta.
DeepSeek V3.1, especialmente como LLM (Modelo de Idioma Grande) NLP (Procesamiento del lenguaje natural) fuerte en el campo. Esto significa que el modelo tiene la capacidad de entender, producir y convertir el lenguaje humano. Los usuarios pueden utilizar DeepSeek en muchos campos diferentes, como resumen de texto, traducción, pregunta-cevap, análisis de sentimientos o escritura de código. Especialmente el apoyo multilingüe es una ventaja importante para diferentes grupos de usuarios a escala mundial.
DeepSeek V3.1 pasó un proceso de entrenamiento mucho más grande que versiones anteriores. Formación de ventana contextual de 32K: ejecutar en 630 mil millones de fichas ( hilo bálsamo). Esto significa 10 veces más datos de entrenamiento de la versión V3.
Capacitación de ventana de contexto 128K: entrenada con 209 mil millones de fichas. Esta es 3,3 veces más que versiones anteriores. “Bağlam ventana (ventana de texto) se refiere a la longitud de texto que el modelo puede recordar al mismo tiempo. 128K context support permite analizar simultáneamente un libro de unas 400 páginas. Esta es una ventaja seria en áreas donde se procesan textos muy largos como derecho, academia, medicina y software.
DeepSeek V3.1 funciona a un costo mucho menor en comparación con sus competidores gracias a su estructura híbrida y el sistema MoE. Según pruebas independientes con base en China, el modelo ofrece más de 40 costos de comercio más baratos que algunos competidores. Esta situación crea una gran ventaja de la accesibilidad, especialmente para las pequeñas empresas o desarrolladores individuales.
DeepSeek V3.1 Update: Terminus Version u
DeepSeek ha actualizado el modelo V3.1 “DeepSeek V3.1-Therminus” en septiembre de 2025 y ha presentado mejoras significativas para mejorar el rendimiento y la estabilidad del modelo. Esta actualización destaca como una versión optimizada de la arquitectura V3.1 existente en lugar de un modelo completamente nuevo.
Junto con la versión terminus, el modelo ha aportado mejoras notables en la calidad del procesamiento de idiomas y la producción de productos. Se eliminan en gran medida las confusiones de lenguaje y las expresiones poco consistentes en versiones anteriores, el modelo se ha producido textos más fluidos y precisos.
Otro aspecto importante de la actualización es el desarrollo de sus capacidades de agente (ajan). En particular, el crecimiento del rendimiento se observa en sistemas utilizados en procesos de producción de códigos y búsqueda de información. Esto indica que DeepSeek V3.1 no es sólo una herramienta de producción de texto, sino también un sistema de inteligencia artificial que puede realizar tareas más avanzadas.
También con la versión terminus, se aumenta la estabilidad general del modelo, se producen productos más consistentes y fiables. Estas mejoras aumentan significativamente las preferencias de DeepSeek en entornos de uso y producción corporativos.
En resumen, la actualización DeepSeek V3.1-Therminus ofrece un desarrollo importante en términos de rendimiento, precisión y fiabilidad de uso sin cambiar la base técnica del modelo.
DeepSeek V3.1 Usos del modelo de inteligencia artificial de código abierto
Desarrollo de software: escritura de código, depuración, descripción de algoritmos. |
Estudios académicos: El artículo resume, análisis de literatura, preparación de tesis. |
Producción de contenidos: escritura de noticias, creación de escenarios, historias creativas. |
Integraciones Corporativas: Chatbots de Atención al Cliente, automatización de procesos empresariales. |
Investigación: Análisis de datos grandes, investigación bioinformática y científica social. |
En resumen, DeepSeek V3.1 no es sólo para los entusiastas de la tecnología, sino también una poderosa herramienta para soluciones industriales e investigación académica.
DeepSeek V3.1 Precios y planes
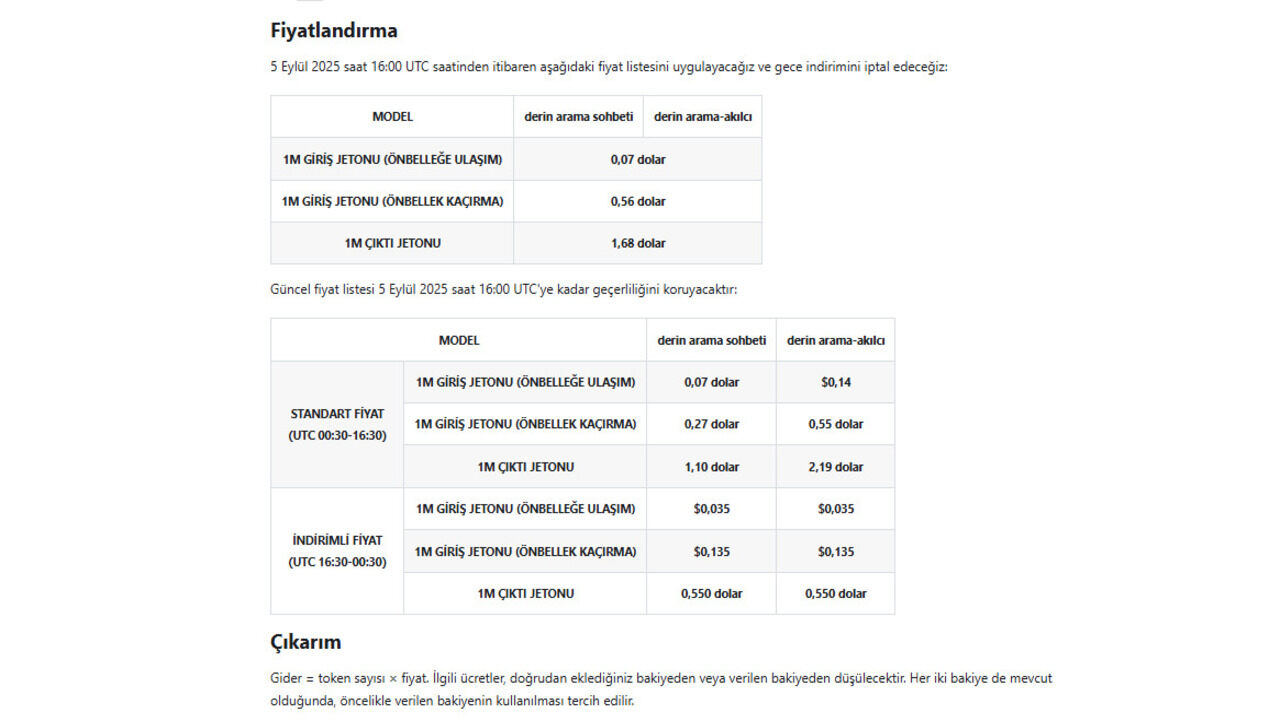
DeepSeek V3.1 ofrece un sistema de precios flexible y transparente diseñado de acuerdo a las diferentes necesidades de los usuarios. El costo del modelo se calcula tanto en el texto enviado por el usuario (input jet / input token) como en las respuestas generadas por el modelo (out jet / output token).
Cache hit significa una reutilización de una consulta previamente procesada y reduce el costo. Cache miss se refiere a nuevas transacciones cada vez y aumenta el costo.
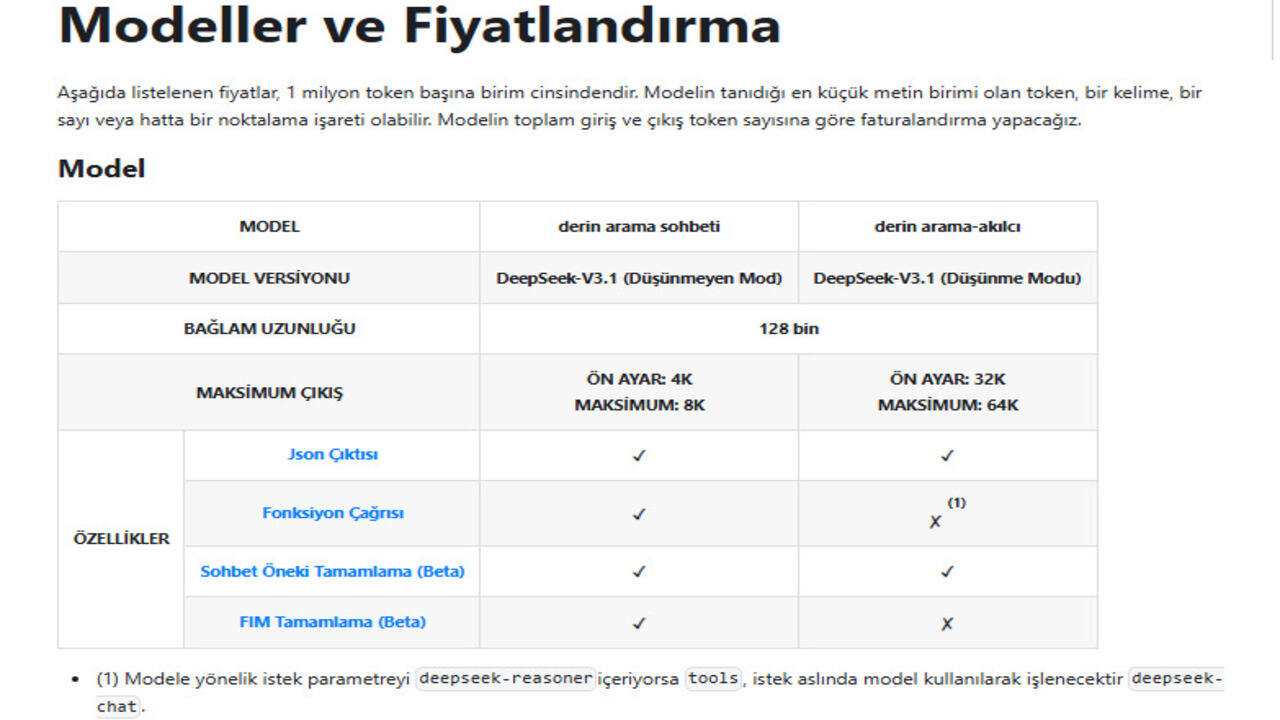
DeepSeek V3.1
Por precio:
Chat de DeepSeek:
Input jet (cache hit) = 0,07 $ / 1M token
Input jet (cache miss) = 0,56 $ / 1M token
jet de salida = 1,68 $/1M token
DeepSeek-Akıllı:
Henüz fiyat detayları açıklanmamıştır; kullanıcıların güncellemeleri takip etmesi önerilmektedir.
Önemli Kavramlar ve Maliyet Hesaplama
Giriş Jetosu (Input Token): Kullanıcının modele gönderdiği metin, soru veya komut.
Çıkış Jetosu (Output Token): Modelin ürettiği yanıt metni.
Önbelleğe Ulaşım (Cache Hit): Daha önce işlenmiş bir sorgunun tekrar kullanılması → maliyet avantajı sağlar.
Önbellek Kaçırma (Cache Miss): Yeni işlem yapılması → daha yüksek maliyet.
Maliyet Hesaplama Formülü: Toplam Maliyet = (Giriş Jetosu Sayısı × Giriş Jetosu Fiyatı) + (Çıkış Jetosu Sayısı × Çıkış Jetosu Fiyatı)
Ödeme Seçenekleri
DeepSeek, kullanıcıların ödemelerini kolayca yönetmesini sağlıyor:
Ücretler, kullanıcının eklenmiş veya promosyon bakiyesinden düşülür; promosyon bakiye varsa öncelikle bu kullanılır.
Ödeme yöntemleri arasında kredi kartı, banka havalesi ve PayPal yer alır.
Kurumsal müşteriler için fatura bazlı ödeme seçeneği mevcuttur.
Detaylı bilgi ve en güncel fiyatlandırma planları için DeepSeek’in resmi web sitesinin takip edilmesi önerilmektedir.
DeepSeek V3.1 Ve Rakipleri
DeepSeek V3.1, yalnızca kendi başına güçlü bir model olmakla kalmıyor; aynı zamanda mevcut büyük dil modelleri (LLM) ve yapay zeka sistemleriyle karşılaştırıldığında öne çıkan bazı avantajlar sunuyor. En bilinen rakipleri arasında OpenAI’nin GPT-4 serisi, Anthropic’in Claude modelleri ve Meta’nın LLaMA modelleri bulunuyor.
Kullanım Amaçları
DeepSeek V3.1: Akademik araştırma, uzun metin analizi, yaratıcı yazarlık, kodlama, kurumsal chatbotlar.
GPT-4 / Claude: Genel amaçlı sohbet, metin üretimi, kodlama, araştırma. Ancak uzun bağlamlarda ve düşük maliyetli yerel kullanımda DeepSeek daha avantajlı.
LLaMA: Daha çok araştırma ve deneysel kullanım odaklı, ticari API entegrasyonu sınırlı.
Performans Karşılaştırması
Parámetro de codificación de ayudantes: DeepSeek V3.1 valorado 1% más alto que Claude Opus 4. Esto proporciona superioridad especialmente en capacidades de codificación y solución de algoritmos.
Procesamiento de texto largo: La ventana de contexto token de 128K de DeepSeek, la capacidad de 32-64K de GPT-4 y Claude, lo que le permite procesar textos mucho más largos simultáneamente. Esto es una gran ventaja para conjuntos de datos largos, como proyectos de ley, academia y software.
Comprensión y producción de lenguaje natural: DeepSeek V3.1 en tareas NLP (text outlined, translation, feeling analysis) tiene tasas de precisión similares con sus competidores, pero funciona más rápido y eficientemente en energía.
Comparación de costos
Una de las ventajas más fuertes de DeepSeek V3.1 es el costo. En uso a través de la API, el costo de 20-40 veces menor que los modelos OpenAI y Anthropic aparecen.
Gracias al modo Think y a la arquitectura MoE, el consumo de energía se minimiza porque no funciona parámetro innecesario. Esto también proporciona una importante ventaja de ahorro para las empresas.
Flexibilidad y personalización
La fuente abierta es una de las características más grandes que distinguen a DeepSeek de sus competidores. Con Hugging Face y GitHub, es posible acceder a los códigos modelo, que ofrece personalización y uso local.
Los modelos de competidores están generalmente encerrados y son accesibles sólo a través de la API. Esto puede ser limitante para algunos desarrolladores e investigadores.
Instrucciones positivas y negativas
Instrucciones positivas | Instrucciones negativas |
Open Welded – Modelo está abierto a todos bajo licencia MIT. Esto permite a los desarrolladores revisar y personalizar de forma transparente. | Riesgos de seguridad – Los modelos de código abierto se pueden utilizar para la dezenformación o ataques cibernéticos por personas maliciosas. |
Precio Ventajas – 20-40 veces más barato que los competidores, completamente gratis si están en el local.
Requisitos de hardware – Hay fuertes GPUs y la gran memoria necesita funcionar localmente.
Arquitectura híbrida – Puede adaptarse a diferentes escenarios con modos Think y no-think.
Problemas de soporte de idiomas – No tan fuerte como los modelos OpenAI, especialmente en los idiomas turco y regional.
Alto rendimiento – Claude y competidores basados en GPT en pruebas de Benchmark.
Regulación Especificación – Dado que el control de la inteligencia artificial de código abierto es difícil, las discusiones de regulación del gobierno pueden aumentar.
Capacidad de bonificación amplia – Con soporte de token 128K, el texto equivalente a 400 páginas se puede procesar simultáneamente.
La lentitud del modo de pensar – Aunque produce respuestas más precisas, el modo de pensar puede conducir a demoras en aplicaciones en tiempo real.
Área de Uso Flexible – Desarrollo de software, academia, periodismo, servicio al cliente.
OpenAI: ChatGPT Erotik İçerik Sunmaya Hazırlanıyor
Tasarım Yapay Zeka ile Nasıl Kullanılır?
Artículos relacionados



Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión