



DeepSeek V4 Introducido: 1 millón de fichas y 1.6T ¡Parámetro!
Traducido automáticamente
China Based DeepSeekCon el modelo V4, 1 millón de contextos token y 1,6 trillones parámetros redefinidos escala, eficiencia y equilibrio de costes en inteligencia artificial.
¿Qué es DeepSeek V4 y por qué es importante?
La competencia en el campo de la inteligencia artificial no es sólo a través de la precisión del modelo; mientras que la longitud del contexto se redefine a través de parámetros tales como coste de procesamiento y escalabilidad, el modelo DeepSeek V4 introducido por DeepSeek se posiciona como uno de los ejemplos más concretos de esta conversión. La pregunta “¿Qué es DeepSeek V4?” no sólo se limita a una nueva definición de modelo, sino que también se refiere a la fractura de la arquitectura técnica de modelos de lenguaje grande (LLM). La capacidad de contexto de 1 millón de toneladas del modelo, procesamiento largo de texto, análisis de códigos y una expansión radical en tareas de razonamiento multietapa, escala de parámetro de 1,6 billones representa el nuevo umbral que la inteligencia artificial alcanza en el poder de cálculo.
Este desarrollo es posible gestionar más información en una sola sesión en finanzas, derecho, ingeniería de software e investigación académica, especialmente en industrias intensivas de datos. Los procesos de análisis que se adhieren al límite de contexto de los modelos tradicionales pueden realizarse continuamente en grupos de datos mucho más amplios. Esto significa no sólo el aumento del rendimiento, sino también el rediseño de los flujos de trabajo.
La serie DeepSeek V4 significa no sólo crecimiento de escala sino también rediseño arquitectónico. La familia modelo desarrollada por DeepSeek se presenta con dos estructuras diferentes, incluyendo DeepSeek-V4-Pro y DeepSeek-V4-Flash. Fuente abierta en la colección oficial Hugging Face El modelo lanzado como estándar de contexto 1M tiene como objetivo hacer de la industria una nueva norma.
1 Millón de Token Inteligencia Artificial: Límites de Grant
La capacidad de contexto de 1 millón de toneladas, una de las innovaciones más notables de DeepSeek V4, se considera uno de los mayores saltos técnicos que se han encontrado en modelos de inteligencia artificial. Mientras que la ficha se define como una de las unidades más pequeñas que se pueden procesar a partir de un texto, significa que la capacidad alcanza 1 millón; cientos de documentos de página se pueden analizar en un momento de bases de código grandes o conjuntos de datos multicapa.
Este desarrollo crea una ventaja seria, especialmente en las tareas que requieren un contexto largo. Por ejemplo; el análisis de todo el texto de una ley, procesos como la depuración en proyectos de software a gran escala, o la comparación extensa de artículos académicos se puede realizar en todo el camino, no en partes. Esto elimina enormemente el problema del modelo “continencia de la luz”.
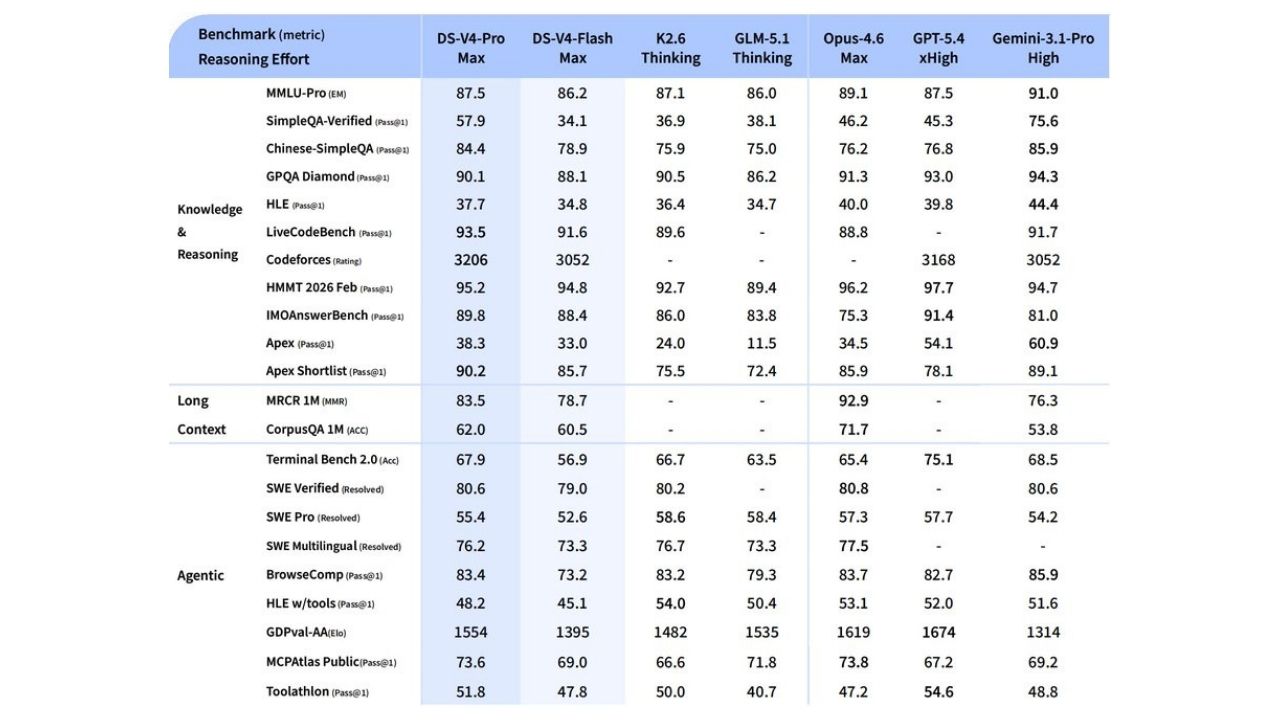
DeepSeek V4, Arquitectura de atención híbrida Gracias a su largo proceso de contexto, ofrece serios aumentos de eficiencia. El modelo con la combinación de Atención al Espesor Comprimido (CSA) y Atención Heavily Compresed (HCA) puede trabajar con costos de cálculo mucho más bajos que las generaciones anteriores. En particular, se indica que el uso de caché KV en el escenario de token de 1M se reduce considerablemente.
Mixture of Experts Architecture: Scalable Intelligence Approach
Mixture of Experts (MoE) architecture, ubicada en la columna técnica de DeepSeek V4, destaca como el mecanismo básico, que permite al modelo trabajar eficientemente a pesar del elevado número de parámetros. Esta arquitectura permite que todo el modelo sea activado sólo subredworks “especiales” relacionados para ciertas tareas en lugar de correr al mismo tiempo.
Este enfoque ofrece una ventaja de cálculo seria en comparación con los modelos intensivos clásicos. En lugar de utilizar todo el modelo con parámetros de 1,6 billones, sólo se activan las partes necesarias; tanto reduciendo el coste del procesamiento como optimizando el tiempo de respuesta. Esta situación destaca especialmente como un factor crítico que afecta directamente el equilibrio de rendimiento de los costos en el uso de API.
La arquitectura MoE también proporciona tasas de precisión más altas, permitiendo que el modelo sea experto en diferentes tipos de tareas. Esto hace que DeepSeek V4 no solo sea grande sino también un modelo de escala inteligente.
Los modelos Pro y Flash en la arquitectura DeepSeek V4 se dividen en diferentes niveles de parámetros activos. DeepSeek-V4-Pro 1.6T está trabajando con un parámetro activo 13B en el parámetro total de 49B, DeepSeek-V4-Flash 284B. Esta estructura es la principal ventaja de la arquitectura MoE “cálculo tanto como sea necesario” implementa el principio directamente.
Estructura de Hyper-Connections (mHC) Manifold-Constrained (mHC) ubicada en la arquitectura de DeepSeek V4, permite al modelo proteger el poder de expresión al estabilizar el flujo de información entre capas. Además, el uso optimizado de Muon ofrece una convergencia más rápida y una dinámica de aprendizaje más estable en el proceso educativo.
Eficiencia de Caché KV: Fuerza Secreta de Long Connect
Otro elemento crítico para el uso práctico de la capacidad contextual larga es la optimización KV Cache (Key-Value Cache). KV La eficiencia de caché desarrollada en DeepSeek V4 reduce significativamente la carga de procesamiento al permitir que el modelo utilice fichas anteriores sin recalculación.
Esta mejora técnica afecta directamente al desempeño en aplicaciones que requieren diálogos prolongados y flujo continuo de datos. Por ejemplo, un sistema de inteligencia artificial con interacción a largo plazo con un usuario puede producir respuestas rápidas y coherentes sin tener que reprocesar toda la historia en cada nueva entrada.
La optimización KV Cache también juega un papel crítico en términos de eficiencia energética. El menor requisito de cálculo significa un menor consumo de energía; esta situación afecta directamente los costos operacionales en los centros de datos a gran escala.
DeepSeek V4-Pro está trabajando con aproximadamente un 10% de uso de caché KV en escenarios de contexto 1M en comparación con DeepSeek-V3.2, el lado de inferencia FLOPs también ofrece una estructura más eficiente a nivel 27%. Esta optimización proporciona un aumento significativo del rendimiento, especialmente en aplicaciones basadas en chat largo y en agentes.
DeepSeek V4 Pro Características: Desempeño en nivel corporativo
DeepSeek V4 Pro se posiciona como la versión más fuerte de la familia modelo y se centra en escenarios de uso corporativo especialmente. Capacidades avanzadas de razonamiento, gestión de contextos largos y altas tasas de precisión hacen de esta versión ideal para proyectos que requieren un procesamiento de datos grande.
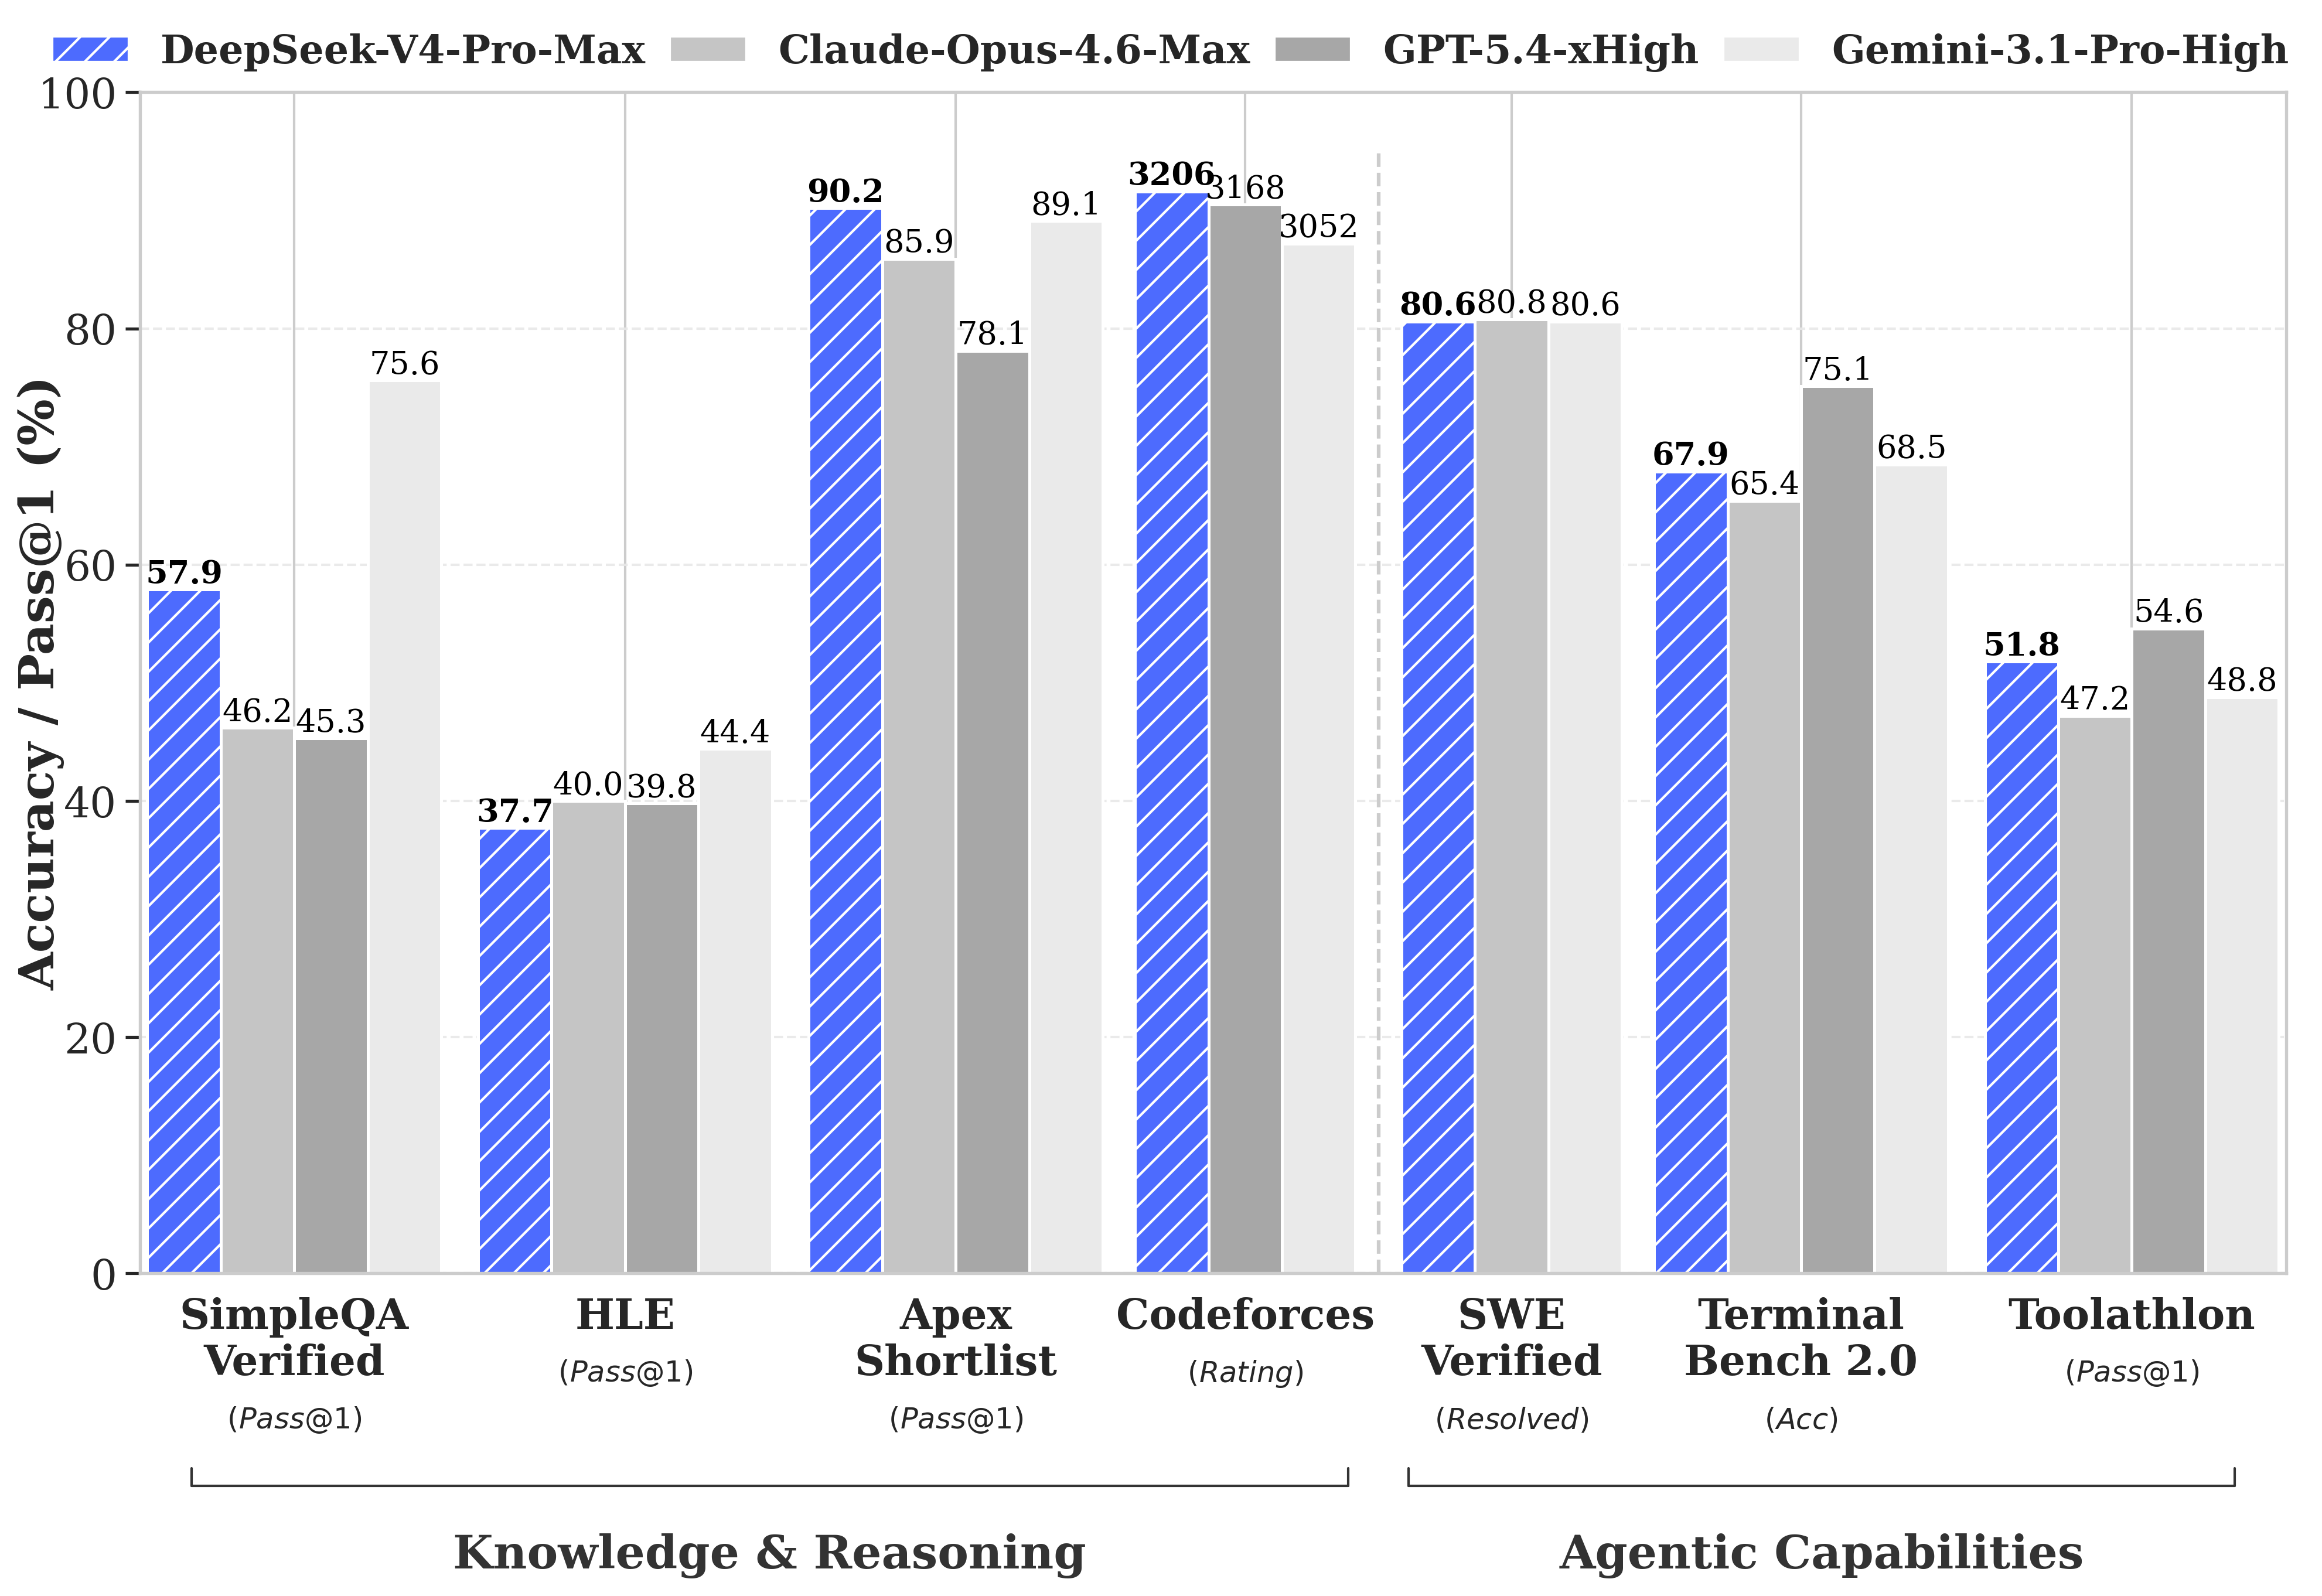
Una de las características más importantes de la versión Pro puede producir resultados más consistentes en tareas complejas. Solución de problemas paso a paso, producción de códigos avanzados y tareas analíticas, el rendimiento del modelo es prominente. Además, gracias a la estructura flexible ofrecida a través de la API, las empresas pueden integrar el modelo según sus necesidades.
DeepSeek V4 Flash vs Pro: Performance and Cost Balance
Las versiones Flash y Pro incluidas en la familia DeepSeek V4 están posicionadas para abordar diferentes escenarios de uso. Versión Flash, al tiempo que ofrece menor latencia y ventaja de costo; la versión Pro está trabajando con el máximo rendimiento y precisión.
El modelo Flash está optimizado para aplicaciones en tiempo real como chatbots, servicio al cliente y producción de contenido rápido. El modelo Pro correspondiente es preferido en tareas más pesadas y complejas. Esta distinción permite a los desarrolladores elegir el modelo adecuado según sus necesidades.
El modelo Flash ofrece menor latencia gracias a su estructura de parámetro activo más pequeña en comparación con la versión Pro, mientras que las tareas de agente simple pueden realizar cerca del nivel Pro. El modelo Pro opuesto es un razonamiento particularmente complejo, búsqueda clara de tareas de codificación y solución de problemas científicos resultados más fuertes producir.
DeepSeek V4 API Precios: Estrategia competitiva
DeepSeek V4 API pricing se evalúa como una estrategia de competencia agresiva, considerando la capacidad técnica del modelo. Debido a su arquitectura MoE, los costos de procesamiento reducidos se reflejan como una experiencia API más asequible para el usuario.
Esta situación destaca como un factor que afecta directamente a la competencia con grandes jugadores como OpenAI y Google en el mercado. Contexto más largo, menor costo y alta combinación de rendimiento hacen que DeepSeek consiga una posición fuerte en la carrera de inteligencia artificial global.
DeepSeek V4 API está trabajando con OpenAI ChatCompletions y estructura compatible con Anthropic. Los usuarios sólo tienen el nombre modelo deepseek-v4-pro o deepseek-v4-flash Puede integrarse en los sistemas existentes cambiando. Home “Modo de pensamiento” y apoyar diferentes niveles de razonamiento como “modo no pensado”.
New Balance in Global Artificial Intelligence Race
La introducción de DeepSeek V4 no es sólo un desarrollo técnico sino que también crea un nuevo punto de equilibrio en la competencia mundial de inteligencia artificial. La rápida progresión en esta área de las empresas chinas se está enojando más con los gigantes tecnológicos estadounidenses.
En este contexto, el rendimiento de los modelos desarrollados en infraestructuras NVIDIA también atrae la atención. La optimización de la integración de hardware y software es uno de los factores que juegan un papel decisivo en el futuro de la IA.
Escala, eficiencia y perspectivas futuras
DeepSeek V4 se considera no sólo modelos más grandes en inteligencia artificial; sistemas más eficientes, más escalables y más accesibles como un mensajero de una nueva era. 1 millón de token context capacity, 1.6 trillion parameter and advanced architecture optimizations; este modelo sólo muestra que este modelo formará estándares de inteligencia artificial en los próximos años.
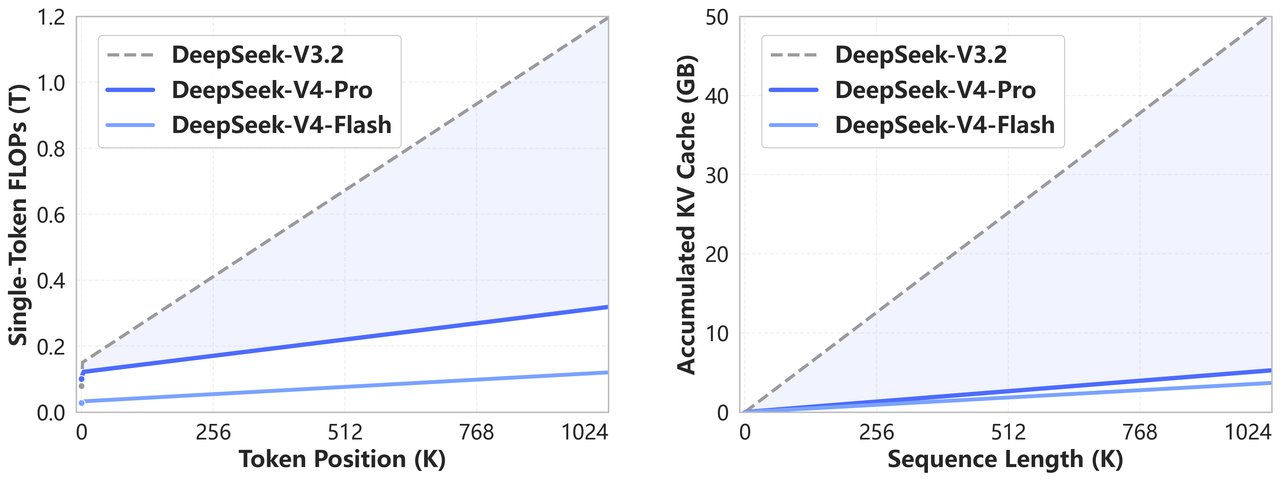
Este desarrollo revela no sólo para las empresas tecnológicas de inteligencia artificial; una vez se convierte en una infraestructura estratégica para todos los sectores. Junto con DeepSeek V4, el concepto de “modelo mayor” deja el paradig “modelo más inteligente y eficiente”.
DeepSeek V4, especialmente en la carrera mundial de IA un punto de ruptura importante en el lado de código abierto crear. La publicación del modelo con pesos abiertos fortalece el potencial de crear un ecosistema alternativo a sistemas cerrados.
JP Morgan Raporu: İnsansı Robotlarda Dönüm Noktası
Robotlara Beyin Geldi: Gemini Robotics-ER 1.6 ile Tanışın!
Artículos relacionados



Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión