Cómo mejorar la inteligencia artificial de voz con ElevenLabs en tiempo real?
Traducido automáticamente
 Autor
En aplicaciones de inteligencia artificial, las interacciones basadas en texto están recibiendo experiencias de conversación más naturales. Sistemas de voz AI, que los usuarios pueden realizar transacciones directamente en lugar de escribir un comando, especialmente servicio al cliente, capacitación, asistentes digitales y nuevas instalaciones de uso en campos de automatización. Sin embargo, no se limita a simplemente convertir el texto en audio que la experiencia es exitosa. También es necesario entender que el usuario dice correctamente, gestionar la cola del discurso, reaccionar cuando se combina y voz sin esperar la respuesta.
ElevenLabs, Con once modelos en tiempo real desarrollados para esta necesidad, Once ofrece a los desarrolladores una nueva infraestructura que puede crear aplicaciones de voz AI en tiempo real. El sistema basado en el enfoque de habla a voz; reconocimiento de habla, modelo de lenguaje, gestión de secuencias de discursos y producción de audio. Así, los desarrolladores tienen como objetivo reducir la necesidad de diferentes tecnologías de audio individualmente.
¿Qué es ElevenLabs en tiempo real?
ElevenLabs En tiempo real es una familia modelo Speech-to-Speech diseñada para mejorar los agentes de voz AI en tiempo real. En asistentes de voz tradicionales, la conversación del usuario se convierte en texto primero, luego procesada por un modelo de lenguaje y finalmente el texto se traduce en audio de nuevo. El tiempo total de respuesta del sistema puede ser espacio cuando cada uno de estos procesos se ejecuta a través de diferentes servicios.
Once en tiempo real combina estos componentes en un sistema optimizado que funcionará en armonía entre sí. El reconocimiento de voz, el procesamiento de lenguaje natural, la gestión de secuencias de discursos y la síntesis de audio se pueden configurar a través de una selección de un solo modelo.
El objetivo principal aquí es quemar la interacción entre el usuario y la inteligencia artificial en lugar de una conversación escrita. Por ejemplo, cuando el usuario pide un asistente de servicio al cliente, el sistema esperará el final de toda la conversación primero, entonces no necesita ejecutar una larga cadena comercial. Es posible responder al flujo del discurso y gestionar situaciones tales como cortar la palabra del usuario.
La nueva familia modelo de ElevenLabs se puede integrar en diferentes aplicaciones con más de 90 idiomas de soporte y más de 17.000 opciones de audio en la plataforma.
¿Cómo funciona Once en tiempo real?
Uno de los elementos importantes que determinan el rendimiento de los sistemas de IA de voz en tiempo real es el tiempo de demora. Si el usuario tiene que esperar un largo tiempo para el inicio de la respuesta después de hacer una pregunta, el sistema no es suficiente solo para producir respuestas técnicamente precisas.
Once en tiempo real se propone abordar este problema mediante la optimización de componentes en la cadena de procesamiento del habla.
Speech-to-Speech Architecture
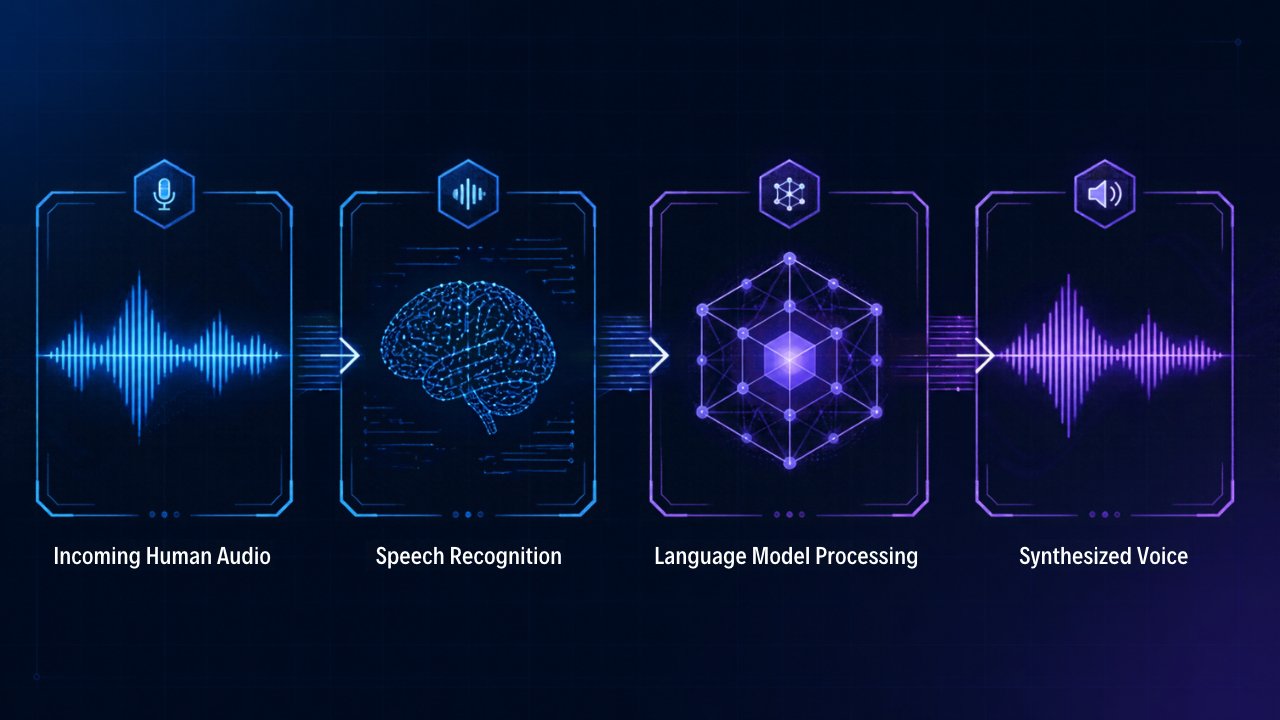
Speech-to-Speech se refiere a la creación de salida de voz mediante el procesamiento de entrada de voz. Cuando el usuario habla con el micrófono, el sistema toma esta entrada, resuelve el discurso, evalúa el contexto de la solicitud y produce una voz de respuesta adecuada.
En este proceso se destacan cuatro componentes básicos:
Discurso a texto: Convierte el contenido textual reconociendo el discurso del usuario.
Modelo de idioma (LLM): Responde a la solicitud del usuario, conversaciones previas e instrucciones del sistema.
Turn-Taking: Se maneja cuando el usuario está hablando, cuando se detiene, y cuando la inteligencia artificial debe responder.
Text-to-Speech: La respuesta creada convierte al discurso a través de audio seleccionado.
Una de las características importantes de Once Realtime es que estos componentes no se quedan como servicios independientes y configurados aleatoriamente. ElevenLabs ejecuta componentes con una arquitectura optimizada de extremo a extremo.
Aquí hay un importante detalle técnico: Once en tiempo real, No todas las etapas se definen como un modelo que actúa en una sola red nerviosa integrada. Según la descripción de ElevenLabs, el sistema utiliza una arquitectura gradual (cascada) donde los componentes separados se optimizan juntos. Este enfoque también le permite monitorear las interetapas en el proceso del discurso.
Bajo retraso y flujo de voz natural
El retraso en las aplicaciones de voz en tiempo real AI es uno de los indicadores básicos de la experiencia del usuario. En particular, puede interrumpir la naturalidad del discurso incluso unos segundos de espera en el servicio al cliente o aplicaciones personales auxiliares.
Once en tiempo real se centra no sólo en acelerar la producción de sonido, mejorando todo el flujo del discurso. El corte de palabras del usuario está entre las interacciones que pueden evaluar el sistema, como pensar por un corto tiempo o orientar una nueva pregunta durante la conversación.
Esta característica revela la diferencia entre los agentes de voz más avanzados de inteligencia artificial con los asistentes de audio tradicionales basados en scripts. En lugar de esperar un script específico del usuario, los sistemas móviles basados en el contexto del discurso pueden crear interacciones más flexibles.
Diferencias entre once en tiempo real v1 Mini y v1 Max
ElevenLabs ofrece una familia modelo en tiempo real con dos opciones según diferentes necesidades. Los modelos Mini y Max comparten el mismo enfoque básico de interacción de voz, se dividen en complejidad de procesos y áreas de uso de objetivos.
Once en tiempo real v1 Mini: conversaciones naturales y rápidas
Once Realtime v1 Mini fue desarrollado para aplicaciones que requieren bajo coste y experiencias de habla natural. En particular, los asistentes diarios de inteligencia artificial, las aplicaciones educativas y los personajes interactivos están entre las áreas de uso que los objetivos modelo.
Los relieves del modelo mini son:
Concéntrate en el flujo de habla natural.
Puede gestionar el flujo de habla cuando el usuario entra.
Optimizado para interacciones mutuas rápidas.
Apoyo al discurso en más de 90 idiomas.
ElevenLabs se puede utilizar en la biblioteca de audio.
En los resultados de prueba compartidos por ElevenLabs, el primer sonido para v1 Mini se indica como 620 milisegundos. Resultado de evaluación de banco completo-Duplex es 95,8 por ciento. La puntuación del Agente Arena Elo es 988.
Este modelo crea un punto de partida adecuado para aplicaciones donde las cadenas comerciales complejas son muy rápidas y la comunicación natural es importante.
Once en tiempo real v1 Max: Voz Inteligencia Artificial Para tareas complejas
Once Realtime v1 Max se centra en los agentes de voz AI que necesitan seguir instrucciones más complejas y realizar operaciones multietapa.
El soporte al cliente no es suficiente para entender sólo la conversación en aplicaciones como la evaluación potencial del cliente y la planificación de citas. El sistema necesita completar el proceso evaluando el propósito del usuario, recopilando la información necesaria y realizando llamadas de vehículo cuando sea necesario.
El modelo max ofrece capacidades de razonamiento más avanzadas para tales tareas.
El primer tiempo de producción de sonido para v1 Max según los resultados de la prueba anunciados por ElevenLabs 570 milisegundos. 98,8 por ciento en Big Bench Audio rating y 87,1 por ciento resultado se logra.
Los datos de rendimiento de los modelos mini y Max se basan en diferentes criterios de evaluación. Por lo tanto, no es cierto decir que uno es más exitoso en cualquier condición comparando los resultados de dos modelos directamente.
¿Qué modelo debería ser preferido?
Usage scenario | Modelo recomendado |
|---|---|
Asistente de voz diaria | v1 Mini |
Aplicaciones de educación y aprendizaje de idiomas | v1 Mini |
caracteres interactivos | v1 Mini |
Servicios al cliente Inicio | v1 Max |
Evaluación potencial del cliente | v1 Max |
Tareas multietapa
v1 Max
Operaciones que requieren llamadas de vehículos
v1 Max
En la selección de modelos, es necesario prestar atención no sólo a la velocidad de respuesta, sino también al procesamiento previsto de la aplicación. Para un asistente que responda a preguntas simples, el Mini puede ser suficiente, mientras que la conexión con múltiples sistemas y max puede ser una opción más conveniente para un agente que realiza transacciones.
Cómo mejorar la inteligencia artificial de voz con ElevenLabs en tiempo real?
ElevenLabs ofrece desarrolladores para utilizar la tecnología en tiempo real de dos maneras diferentes: plataforma OnceAgents y API en tiempo real. Si bien estos dos métodos se benefician de capacidades de interacción de voz similares, difieren en los procesos de desarrollo y distribución.
Crear Voice AI Agent de ElevenAgents
OnceAgents ofrece una plataforma para desarrolladores que quieren crear agentes de voz AI reduciendo el proceso de codificación tanto como sea posible.
En este método, los desarrolladores pueden crear un nuevo agente o editar un agente existente. A continuación, puede identificar uno de los modelos de v1 Mini o v1 Max pasando la opción en tiempo real de los modelos.
El proceso de desarrollo básico consiste en:
La cuenta ElevenLabs se ha conectado a la plataforma ElevenAgents.
Se crea un nuevo agente de voz o se abre el agente existente.
El modo de sonido del agente se determina como en tiempo real.
El modelo Mini o Max se selecciona según el propósito del uso.
Se configuran instrucciones del sistema, voz del discurso y herramientas necesarias.
El agente es probado y publicado en canales de distribución adecuados.
Los agentes desarrollados a través de ElevenAgents pueden integrarse en canales de comunicación como sitios web, sistemas telefónicos y WhatsApp. Las características necesarias en el entorno de producción, como la base de información, las normas de seguridad, los escenarios de prueba y la vigilancia del habla, también se encuentran entre las instalaciones que ofrece la plataforma.
Integración con API en tiempo real
Los desarrolladores que están planeando integrar la tecnología ElevenLabs en una aplicación de inteligencia artificial de voz existente.
Una de las características notables de ElevenLabs, API en tiempo real utiliza un protocolo compatible con OpenAI API en tiempo real. De esta manera, los desarrolladores con la integración SDK existente OpenAI en tiempo real pueden probar la infraestructura ElevenLabs cambiando la dirección de enlace y la configuración del modelo en lugar de escribir toda la aplicación.
Pero hay un detalle importante para el funcionamiento seguro de la integración: la clave API no necesita ser colocada directamente en el navegador. Una clave de cliente de corta duración (secreto de cliente) se crea a través del servidor de backend de la aplicación y se debe dar al cliente sólo con estas credenciales temporales.
También la conexión API existente de ElevenLabs funciona mediante WebSocket. El soporte WebRTC necesita cambiar directamente en la capa de enlace de una aplicación existente que utiliza WebRTC porque aún no está disponible. Las operaciones de captura y reproducción de voz a través de WebSocket también deben ser gestionadas por el desarrollador.
¿Dónde puede la inteligencia artificial en tiempo real disponible?
ElevenLabs En tiempo real ofrece una variedad de usos para equipos que quieren desarrollar aplicaciones basadas en el habla en diferentes industrias.
Servicios al cliente y centros de llamadas
Los agentes de Voice AI se pueden utilizar para satisfacer las demandas de los clientes, responder preguntas frecuentes y automatizar ciertos procesos.
Por ejemplo, cuando desea aprender el estado de una orden de usuario, puede recibir datos de la base de información relevante o sistemas conectados. Puede guiar al usuario llamando las herramientas necesarias en procesos más complejos.
Prácticas de educación y aprendizaje de idiomas
Voz en tiempo real AI es capaz de desarrollar aplicaciones educativas que los estudiantes pueden practicar hablando mutuamente con una inteligencia artificial.
Especialmente la práctica, los estudios de pronunciación y las simulaciones de diálogo en el aprendizaje del idioma extranjero crean importantes áreas de uso. Los estudiantes pueden hacer una conversación natural con inteligencia artificial en lugar de elegir entre opciones pre-hechas.
Auxiliares digitales y auxiliares personales
Los agentes de Voice AI se pueden utilizar en tareas como la gestión del calendario, la investigación de información, la creación de recordatorios y diversos procesos digitales.
En este punto, la función de llamada del vehículo también es importante. Es necesario completar un proceso interactuando con los sistemas permitidos, no sólo responde a la inteligencia artificial.
Juegos y personajes interactivos
Los desarrolladores de juegos pueden crear experiencias que los jugadores pueden realizar conversaciones naturales con personajes dentro del juego.
Los personajes que pueden estar fuera de diálogos previamente escritos pueden dar diferentes respuestas a las preguntas del jugador y al contexto del discurso. Este enfoque ofrece nuevas oportunidades para juegos de rol, simulaciones y experiencias de historias interactivas.
Diferencia entre ElevenLabs API en tiempo real y OnceAgents
Una de las cosas que los desarrolladores deben prestar atención es que la plataforma OnceAgents no es el mismo producto con API en tiempo real.
API en tiempo real ofrece conectividad e infraestructura modelo a los desarrolladores que quieren integrar las capacidades de voz AI a las aplicaciones existentes. ElevenAgents ofrece una plataforma más completa para la creación, configuración y publicación en diferentes canales.
Por ejemplo, OnceAgents puede ser una opción más conveniente para un equipo que necesita teléfono, WhatsApp, widget web, base de información, reglas de seguridad, pruebas y funciones de seguimiento.
A su vez, los desarrolladores que quieren gestionar su arquitectura y trabajar con OpenAI Realtime SDK pueden elegir la integración API en tiempo real.
Es necesario señalar que dos productos funcionan por separado. Las características de OnceAgents no están disponibles directamente a través de API en tiempo real. Por lo tanto, la arquitectura del proyecto debe evaluarse con antelación qué especificaciones se requieren.
Ventajas y limitaciones de utilizar ElevenLabs en tiempo real
La nueva familia modelo de ElevenLabs ofrece una variedad de ventajas que pueden facilitar el desarrollo de la voz AI. Sin embargo, antes de proceder al entorno de producción, es necesario evaluar las limitaciones y costos técnicos.
Ventajas destacadas:
Optimize speech recognition, language model and audio production together.
Capacidad para gestionar el flujo de habla natural e interrupciones.
Apoyar más de 90 idiomas.
Adecuación de una amplia biblioteca de audio.
compatibilidad de protocolo con OpenAI API en tiempo real.
Distribución a diferentes canales de comunicación a través de ElevenAgents.
Soporta la llamada del vehículo para tareas complejas.
Limits to attention:
API en tiempo real está utilizando la conexión WebSocket; el soporte WebRTC no está disponible.
Las operaciones de captura y reproducción de voz a través de WebSocket deben ser gestionadas por el desarrollador.
ElevenAgents características con API en tiempo real están trabajando por separado.
La selección de modelos afecta el costo total del volumen de uso y el consumo de token.
Real rendimiento de producción puede variar dependiendo de las condiciones de red, calidad de sonido y arquitectura de la aplicación.
Por lo tanto, los desarrolladores sólo tienen que ver las tasas de retraso final a extremo, precisión de respuesta y éxito de tarea que obtienen en sus aplicaciones, no sólo los valores de rendimiento descritos en el modelo.
¿Cómo funciona ElevenLabs?
El costo en el uso en tiempo real de ElevenLabs varía según el modelo preferido y la duración de la conexión.
En relación con el lado API en tiempo real, se carga la duración del volumen y las fichas de entrada utilizadas. El precio lanzado en la página de precios de ElevenLabs está listado como v1 Mini para minutos adicionales de audio 0,08 dólares. Las fichas de entrada se cobran de 0,20 por 1 millón de fichas y más de 6 dólares por 1 millón de fichas.
minutos adicionales de audio en v1 Max modelo de nuevo $0.008. Pero las fichas de entrada son 1,80 dólares por 1 millón de fichas, las fichas de salida se indican como 9 dólares por 1 millón de fichas.
En uso a través de ElevenAgents, los costos de ficha del modelo en tiempo real se aplican además de la tarifa de minuto estándar. Por lo tanto, los costos de dos métodos de uso deben calcularse por separado.
Los precios y los alcances del plan pueden cambiar la aplicación antes de la producción Página de precios de ElevenLabs API Inicio comprobado.
¿Qué se debe considerar en el proceso de desarrollo de inteligencia artificial de voz en tiempo real?
El hecho de que una aplicación de voz AI tenga éxito no sólo depende de producir sonido rápido. El sistema debe ser capaz de responder adecuadamente en situaciones inesperadas, que están protegidas en el contexto del discurso.
Los desarrolladores necesitan centrarse en tres temas particularmente.
En primer lugar, la tolerancia al error es importante en las interacciones de voz. El ruido de fondo, los diferentes acentos, la velocidad del habla y los términos técnicos pueden afectar el rendimiento del reconocimiento del discurso. Por lo tanto, el sistema debe ser probado con diferentes perfiles de usuario.
En segundo lugar, los procesos de seguridad y privacidad de los datos deben abordarse en la fase de diseño. Los registros de voz, los discursos y la información personal pueden contener datos confidenciales. Es necesario informar a los usuarios sobre qué datos se procesan y cuánto tiempo se almacena. ElevenLabs afirma que ofrece encriptación, colocación de datos y diversas opciones de compatibilidad para uso corporativo. Sin embargo, debe tenerse en cuenta que cada modelo y opción de distribución de datos tienen la misma compatibilidad.
Por último, qué procesos de agentes de voz pueden limitarse claramente. En particular, los controles de autorización y seguridad son críticos en agentes que acceden a los datos del cliente, forman una cita o procesan sistemas externos.
Masqot y ElevenLabs se organizan con cooperación “Sesle Produce: The webinar titled “ Artificial Intelligence Assistant” from Voiceover with ElevenLabs, Las tecnologías de audio apoyadas por AI abordarán las innovaciones presentadas. En el evento que se celebrará con la participación de ElevenLabs Embajador Güldem Turan, se evaluará el proceso que se extiende de la tecnología de voz a chat (Speech-to-Speech) a audio desde texto (Speech-to-Speech), las soluciones ofrecidas por la plataforma ElevenLabs y aplicaciones que se pueden desarrollar con estas tecnologías. El webinar, que se celebrará en línea el viernes 13 de noviembre, estará abierto a los participantes que quieran explorar el campo de la producción de sonido con inteligencia artificial y aprender maravillas sobre el tema.
Preguntas frecuentes
¿Qué es ElevenLabs en tiempo real?
ElevenLabs En tiempo real es la familia modelo Speech-to-Speech, presentada para mejorar las aplicaciones de audio AI naturales y de baja latencia. Optimiza el reconocimiento del habla, el modelo de lenguaje, la gestión de secuencias de discursos y la producción de audio juntos.
¿Cuál es la diferencia entre once en tiempo real v1 Mini y v1 Max?
v1 Mini está diseñado para experiencias rápidas, naturales y de bajo coste. v1 Max ha sido desarrollado para ser utilizado en instrucciones complejas, operaciones multietapa y tareas que requieren la llamada del vehículo.
ElevenLabs en tiempo real ¿Qué soporte para idiomas?
ElevenLabs afirma que Once modelos en tiempo real ofrecen soporte de habla en más de 90 idiomas. Los sonidos disponibles se pueden seleccionar en la biblioteca de audio de la plataforma.
ElevenLabs API en tiempo real Gratis?
El uso de API en tiempo real se paga. Carga a través del tiempo de audio conectado y tokens utilizados. Los precios actuales se pueden controlar desde la página de precios de API de ElevenLabs.
ElevenLabs Asistencia WebRTC en tiempo real?
No. Disponible La conexión API en tiempo real funciona a través de WebSocket. Por lo tanto, hay un cambio en la arquitectura de conexión de una integración basada en WebRTC.
ElevenLabs en tiempo real con OpenAI API en tiempo real puede ser usado juntos?
ElevenLabs En tiempo real soporta protocolo y estructura de eventos compatibles con OpenAI API en tiempo real. Disponible OpenAI Las integraciones SDK en tiempo real pueden dirigirse a la infraestructura ElevenLabs cambiando la conexión adecuada y la configuración del modelo.
Autor
Artículos relacionados
Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión