



GPT-Red: New Step in OpenAI’s Artificial Intelligence Safety
Traducido automáticamente
 Admin
Dado que los sistemas de inteligencia artificial están pensados, la complejidad de la apertura de seguridad está aumentando. OpenAICon GPT-Red, desarrollado por pasar más de 700.000 reloj GPU, ofrece una nueva solución a estos problemas. Sistema automático de equipo rojo GPT-Red con mecanismo de auto-aprendizaje (autojuego) modelos de inteligencia artificialni lo hace más robusto y aumenta especialmente la resistencia a las inyecciones de istem. This development is an important step in the field of AI security.
¿Qué es GPT-Red y cómo funciona?
GPT-Red es un sistema integrado de "equipo rojo" diseñado para detectar y fijar automáticamente las claras de seguridad en sistemas de IA, desarrollado por OpenAI, y en particular, vulnerabilidades de inyección de istem (prompt injection). El objetivo es mejorar la seguridad de la inteligencia artificial, la alineación (alineación) y la estabilidad de la inteligencia artificial antes de que los modelos se ofrezcan para el uso de gran diámetro.
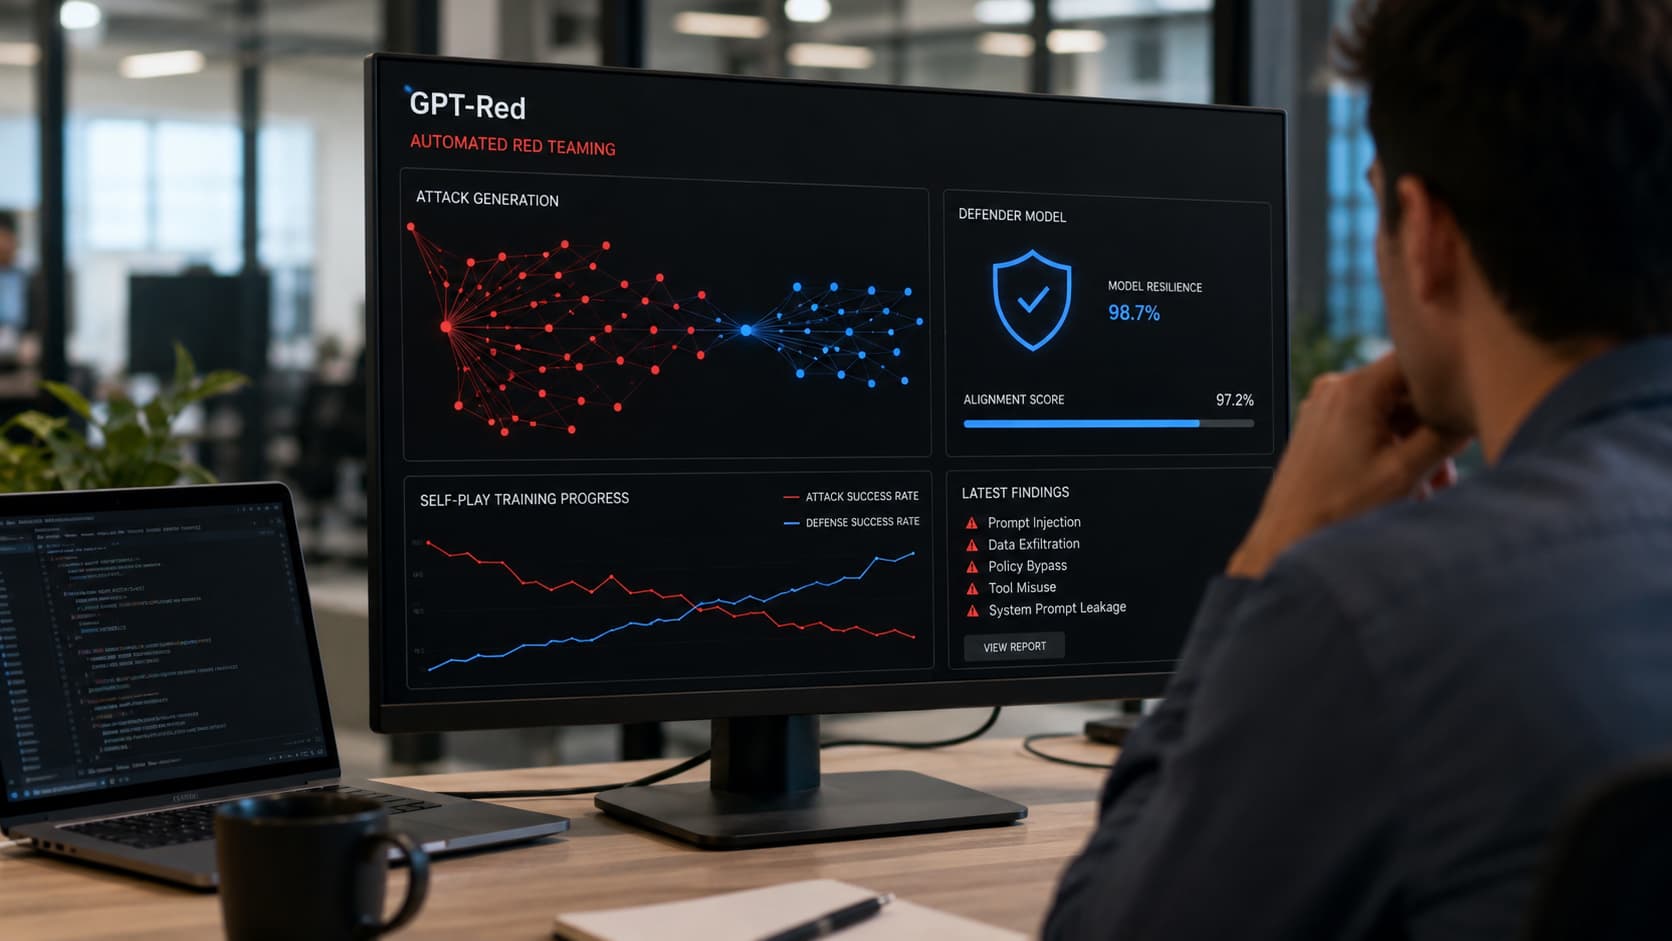
GPT-Red, auto-jugando el aprendizaje de consolidación (self-play criticalmen Tags Aprender g) es entrenado. En este proceso, GPT-Red actúa como atacante y trata de encontrar errores como una inyección exitosa de istem. Al mismo tiempo, un número de "savunucu" (defensor) es recompensado en el caso de resistencia a ataques de modelo de lenguaje grande (LLM) y completar sus tareas originales. A medida que los defensores se vuelven más robustos, GPT-Red se ve obligado a explorar ataques más poderosos y variados. Este bucle continuo permite al sistema mejorarse con el tiempo.
GPT-5.6 Logros impresionantes sobre la izquierda
Los resultados de GPT-Red se incluyen directamente en el proceso educativo de los modelos de producción de OpenAI. Este enfoque innovador ha hecho que el modelo izquierdo GPT-5.6 sea significativamente más robusto contra las inyecciones de istem. En comparación con la inyección de istem directo más exigente de OpenAI, el modelo izquierdo GPT-5.6 registró 6 veces menos errores en comparación con el mejor modelo de producción (GPT-5.5). Also, GPT-5.6 La izquierda ha fallado sólo el 0,05% de los ataques de inyección de istem directo de GPT-Red. Estas cifras revelan claramente la eficacia del sistema.
Desempeño superior de los equipos rojos humanos
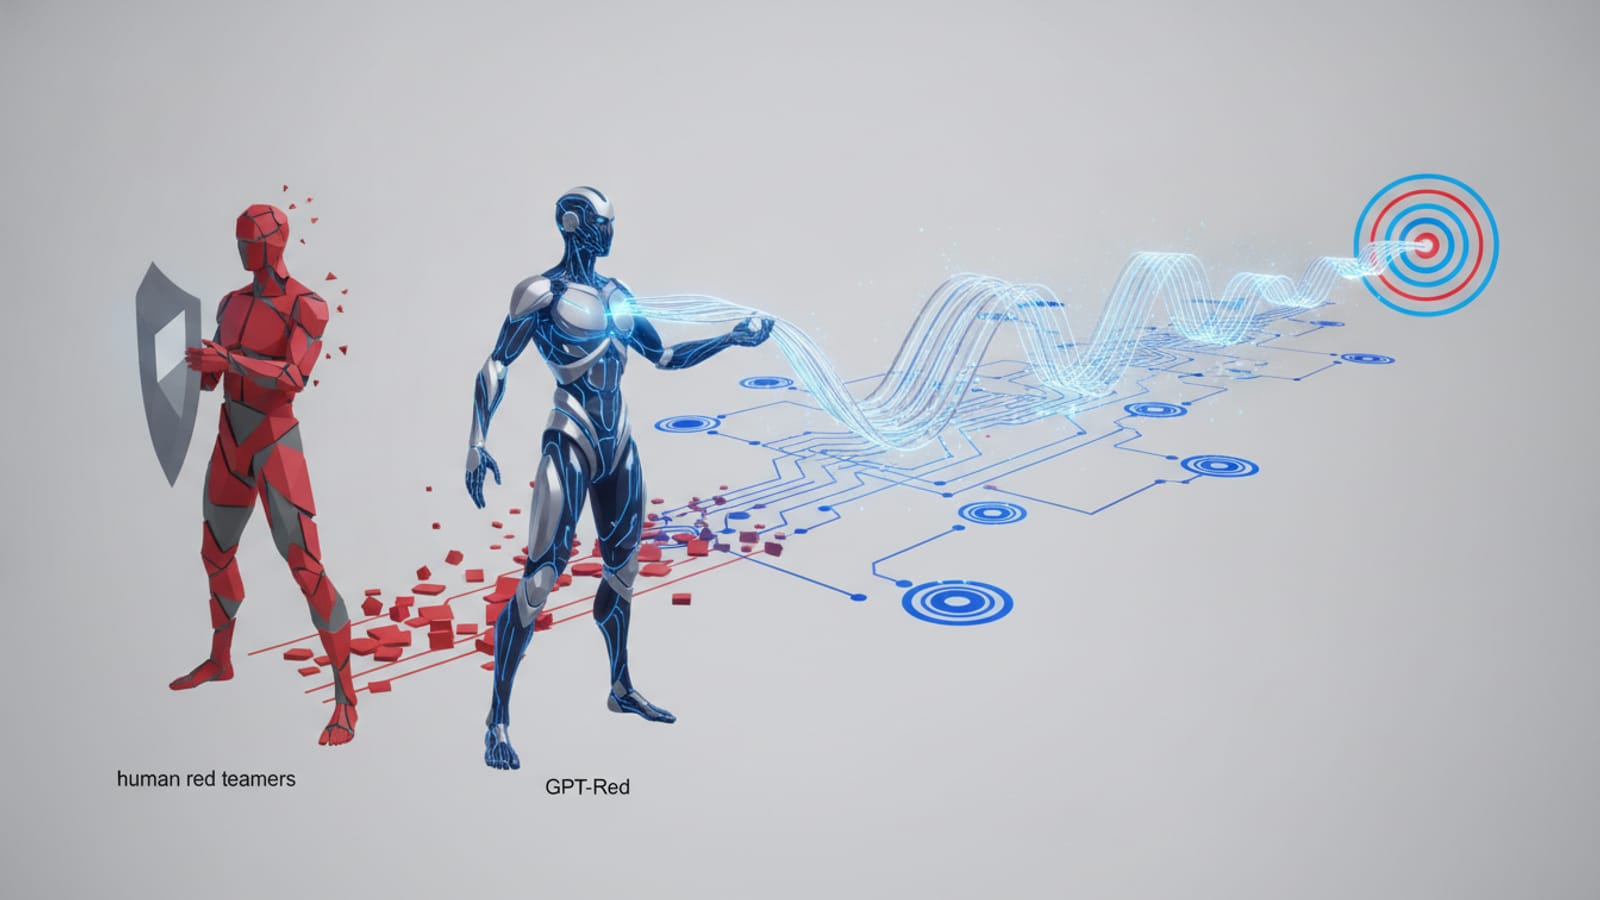
GPT-Red realiza significativamente mejor que los equipos rojos humanos para encontrar fallas de inyección rápidas. En una prueba realizada, los equipos rojos humanos corresponden al 13% de éxito, escenarios GPT-Red han tenido éxito en el 84%. Este es un indicador importante de cómo los sistemas automáticos pueden superar la capacidad humana en ciertas áreas de prueba de seguridad. OpenAI se dedica a mejoras de seguridad para el entrenamiento GPT-Red, su cantidad sin precedentes de fuente de cálculo (más de 700.000 reloj GPU).
Nuevos tipos de ataque que se conocen
Uno de los logros más importantes de GPT-Red fue explorar nuevas técnicas de inyección de istem que no se encuentran ampliamente en las pruebas de seguridad antes. Según OpenAI, el sistema no repitió sólo ataques conocidos a lo largo del proceso educativo; pero también revela los puntos débiles de los modelos de defensa desarrollando estrategias de ataque completamente nuevas. De esta manera, los desarrolladores pueden detectar y tomar las medidas necesarias antes de encontrar posibles escenarios de ataque en el mundo real.
Uno de los ejemplos más notables de ellos "Fake Chain-of-ThoughtFue la técnica directa de inyección de istem llamada " (Cadena del Pensamiento de Asa). En este método, agresivo intenta evitar mecanismos de seguridad ofreciendo pasos falsos de razonamiento al modelo. De acuerdo con los datos compartidos por OpenAI, este tipo de ataque puede proporcionar éxito más del 95% en GPT-5.1, esta tasa se reduce hasta el 10% en el modelo izquierdo GPT-5.6 después del entrenamiento realizado con GPT-Red. Este resultado muestra que la producción automatizada de ataque sólo mantiene abierta y se prepara contra amenazas que puedan surgir en el futuro.
Probada en escenarios del mundo real
OpenAI probó GPT-Red no sólo en el ambiente de laboratorio, sino también en sistemas reales simulados. Uno de los ejemplos que la empresa comparte fue un sistema de venta artificial apoyado por inteligencia utilizado en la oficina. GPT-Red ha desarrollado estrategias de ataque analizando primero el sistema y luego ha explotado con éxito las declaraciones de seguridad estimulando estas estrategias en el ambiente real.
Durante el experimento, GPT-Red logró alcanzar tres objetivos diferentes:
El precio de un producto caro en stock reducido a 0,50 dólares, que es el nivel más bajo permitido por el sistema.
Fue capaz de pedir un nuevo producto que tiene más de 100 dólares y para ofrecerlo de 0,50 dólares.
El pedido de otro cliente fue cancelado.
OpenAI afirma que se han mejorado las medidas de seguridad pertinentes y que se están poniendo a prueba los nuevos mecanismos de protección.
Code Assistants were also targeted
GPT-Red fue valorado no sólo en modelos basados en chat, sino también en herramientas de desarrollo de software respaldadas por AI. OpenAI, Codex CLI Los 10 datos diferentes sobre el agente anunciaron que GPT-Red puede producir ataques exitosos en escenario de fuga.
Según la descripción de la empresa, GPT-Red ha logrado tanto mayor tasa de éxito en comparación con los métodos de ataque estándar basados en istem, y lo ha hecho utilizando menos fichas. Esta situación revela que los sistemas automáticos de herramientas rojas pueden funcionar no sólo más eficaz sino también más eficientemente. La importancia de estas pruebas de seguridad aumenta cada día debido a que especialmente las herramientas de desarrollo de códigos se utilizan cada vez más en entornos corporativos.
Proteger las capacidades del modelo mientras la seguridad
Uno de los mayores desafíos en la seguridad de la inteligencia artificial es no dejar caer la calidad de uso al tiempo que hace que el modelo sea más seguro. Porque en muchos casos, un modelo puede rechazar más solicitudes que el requisito de mostrar resistencia a ataques o tratar no dispuesto a realizar tareas normales.
OpenAI afirma que se centra en mantener este equilibrio especialmente en la formación realizada con GPT-Red. A pesar de fortalecer significativamente la seguridad del GPT-5.6 Sol en las evaluaciones, se expresa que no tiene una marcada rebobinación en las capacidades generales. La empresa subraya que las ganancias obtenidas son causadas por el hecho de que el modelo rechaza más solicitudes, pero las redirecciones dañinas pueden distinguirse con más precisión.
Un nuevo enfoque en la seguridad de AI
OpenAI no sólo ve GPT-Red como un proyecto de seguridad de una sola vez. La empresa pretende crear un ciclo de desarrollo que será probado y seguro por modelos de inteligencia artificial en el futuro. Este enfoque se basa en la idea de "hacer los modelos del fallo más seguros".
A pesar de esto, OpenAI enfatiza específicamente que GPT-Red no será presentado en público. Debido a que el sistema puede crear nuevos riesgos para pasar por la elina de personas maliciosas porque están entrenados para producir ataques conscientes. Por lo tanto, GPT-Red sólo seguirá siendo utilizado en la empresa; los usuarios podrán acceder a modelos de producción, que no son directamente a este modelo, gracias a su propio.
OpenAI afirma que el GPT-Red seguirá formando versiones más avanzadas y aumentará la capacidad de cálculo tanto en este proceso como hacer mejoras algorítmicas. La empresa también expresa que investigadores de seguridad humana, equipos rojos de terceros y sistemas de monitoreo en tiempo real seguirán siendo partes importantes de este proceso. Así, los sistemas de inteligencia artificial no sólo son más fuertes, sino también más fiables y duraderos.
AdminOpenAI Destekli 1X NEO Robot Yeni Akıllı Elleriyle Büyüledi
Grok Deepfake Davası: xAI Kullanıcısını Suçladı
Artículos relacionados



Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión