



Nueva revolución de Meta: Sam Audio Modelo de Inteligencia Artificial!
Traducido automáticamente
 Admin
Meta AI es un gran eco en el mundo del procesamiento de imágenes "Segmento cualquier modeloAl estimular la arquitectura de " (SAM) en el mundo sonoro, lanzó un nuevo paradigma en el ecosistema AI. SAM Audiopretende cambiar los estándares digitales de procesamiento de audio de la raíz con la capacidad de identificar, separar y aislar objetos de audio en entornos acústicos complejos. Este modelo se aborda como un "obje" independiente de cada elemento de audio dentro de un registro de audio, así como puede elegir cada objeto en una foto.
¿Qué es SAM Audio?
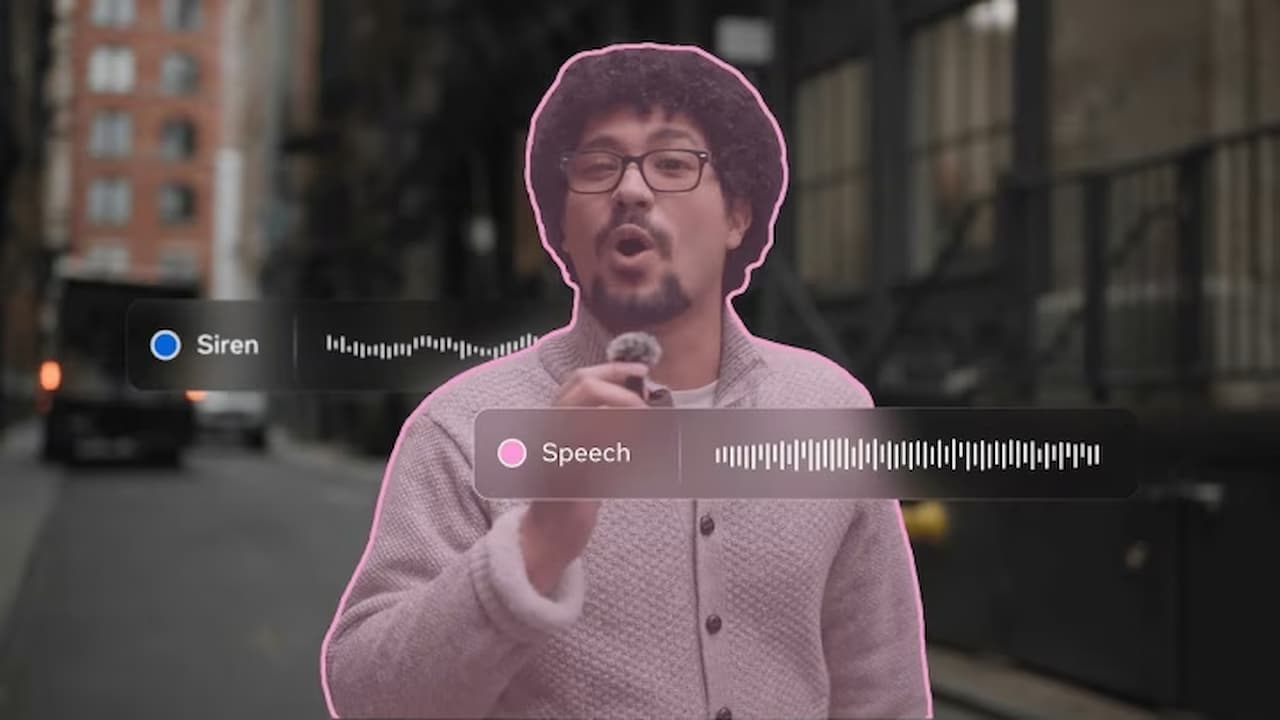
SAM AudioCada fuente de audio (voz humana, instrumento, voz animal, ruido mecánico, etc. en entornos complejos y muy de voz. ) es un modelo básico de inteligencia artificial que identifica independientemente como un "objeto visual" y los distingue perfectamente uno del otro. A diferencia del software de edición de audio tradicional, este sonido modelo no sólo como forma de onda, cada uno ve la combinación de partes con diferentes caracteres. Esta situación da a los usuarios la libertad de cortar y pegar partes de una foto como si estuviera en un registro de sonido.
Technical Capacity and Competitive Analysis Home
Detrás del éxito de SAM Audio, Meta Transformador arquitectura basada y entrenamiento en una enorme biblioteca de audio. El sonido para las computadoras se compone normalmente de frecuencias complejas dentro. Pero SAM Audio resuelve este desastre con:
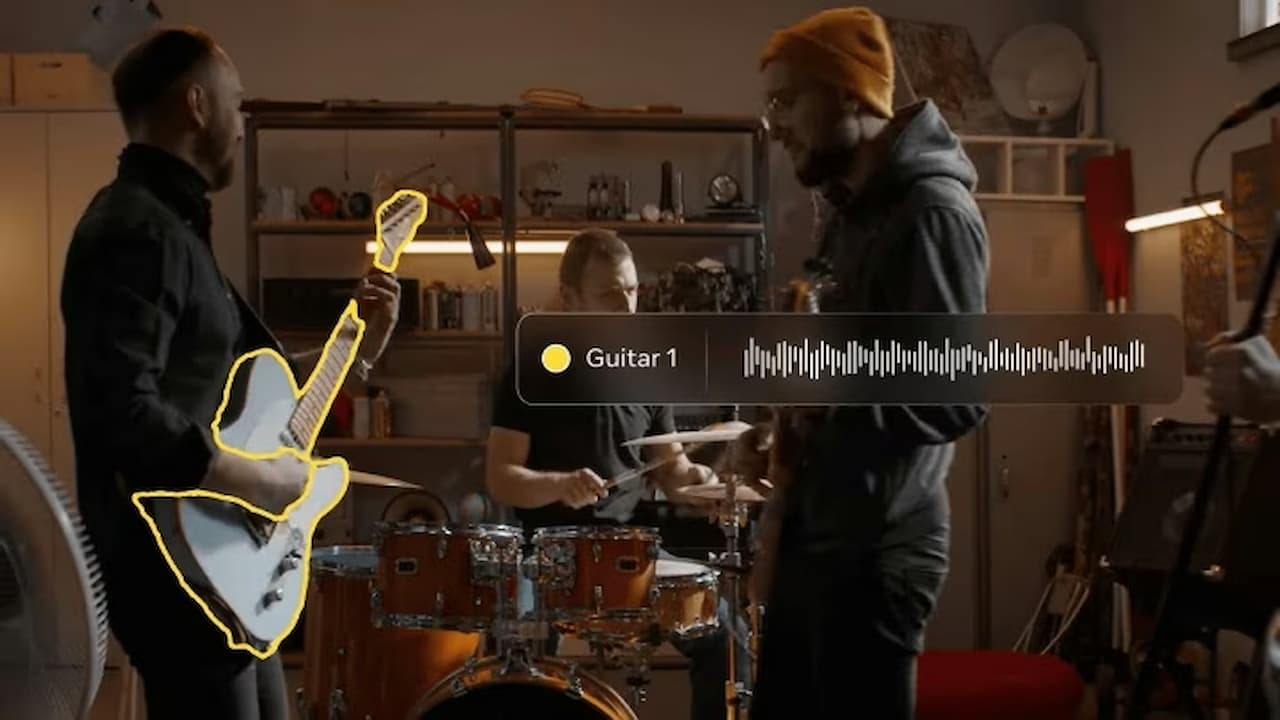
- Análisis de la firma acústica: El modelo sabe que cada voz tiene una "impresión digital". Ellos entienden la diferencia táctica del sonido del alambre de una guitarra con un alambre agudo y los colocan en capas separadas.
- Zero Sample Learning: Este término significa que incluso una voz que el modelo nunca se ha encontrado antes, puede ser percibido como un "ancla y un sonido separado". Por ejemplo, la voz de una aspiradora recién producida puede separar el sonido de la televisión en el fondo, incluso si no en el set de entrenamiento.
IA de audio actualOpenAIEtiquetas ElevenLabs etc.) generalmente "Text-to-Speech" se centra; es decir, toma un texto y lo convierte en voz humana. Pero SAM Audio, un "Ses Segmentation and Manipulation" modelo. Esto lo lleva a una posición "mimar", en lugar de un "productor" que puede separar y reorganizar las partes del universo sonoro.
Objeción de la voz
Modelos como ElevenLabs producen el sonido como un solo todo. SAM Audio define cada elemento en un archivo de audio (por ejemplo, el ruido del aire acondicionado en el fondo, la voz de la respiración del altavoz y el eco en la habitación) como objetos independientes.
Diferencia: Mientras que otros modelos están tratando de imprimir ruido, SAM Audio ruido "lento". Esto puede eliminar sólo parte no deseada con una precisión quirúrgica sin dañar el sonido original en absoluto.
Naturalidad y conciencia acústica
Aunque OpenAI Los modelos de voz ofrecen alta naturalidad, a menudo dan los mejores resultados en entornos estériles tipo estudio. Superioridad técnica de SAM Audio, sonido acústica espacial Home Entiendo.
Emo Toning: SAM Audio analiza no sólo la frecuencia de la voz, acentos emocionales dentro y pausa como "anlamsal". Tiene la capacidad de procesamiento al distinguir el sonido de vibraciones (micro-hitmos) que una voz se asusta o anima.
Tiempo de baja demora y eficiencia
SAM Audio, Meta "Segmenter eficiente" Construido en arquitectura. En lugar de leer todo el archivo al procesar datos de audio, esta arquitectura hace operación simultánea separando la voz en "token" pequeño.
Ventajas técnicas: Mientras que las operaciones complejas de otros modelos ( clonación de voz o limpieza) llevan períodos más largos en los servidores de la nube, SAM Audio trabaja con mucho menor latencia gracias a su estructura optimizada. Esta es ella. puestos vivos y traducciones en tiempo real por un paso por delante de sus competidores.
Capacidad Zero-Shot " Flexibilidad
Los modelos OpenAI y ElevenLabs generalmente requieren entrenamiento intensivo en ciertos idiomas y tonos de audio. SAM Audio puede identificar y aislar instantáneamente una voz (por ejemplo, una herramienta de música muy rara) con su capacidad "Zero-shot". Esto demuestra que el modelo no píldora en categorías predefinidas.
¿Cómo usar?
Meta, SAM Audio Ya que el modelo (como en la etapa de descubrimiento) todavía no se ha añadido a aplicaciones como WhatsApp o Instagram para el último usuario. Pero hay dos formas principales de utilizar esta tecnología:
Meta AI Demo and Research Pages
Meta, nuevos modelos a menudo Meta AI Research El sitio web ofrece demos interactivos.
- Paso 1: Vaya al sitio web oficial de Meta AI.
- Paso 2: Cargue un archivo de audio en la sección demo.
- Paso 3: Haga clic en la región que desea separar en el Specogram (audio mapa visual) o escriba un script como "sólo deja la voz humana" en el cuadro de texto.
- Paso 4: Escucha y descarga las capas de audio que el modelo no separa.
Para desarrolladores y usuarios técnicos
SAM Audio es un modelo básico con código fuente abierta. Si usted tiene conocimiento de Python en el nivel básico, o si usted es un programador:
- Acceso al Código: Meta GitHub Puede descargar los pesos y códigos del modelo desde la página a su computadora.
- Hugging Face: Estos modelos son optimizados por la comunidad Hugging Face Puede probar directamente en el navegador.
- Uso de API: Para mejorar sus propias aplicaciones, puede agregar la biblioteca del modelo a su proyecto.
Usos y efectos diarios de la vida
SAM Audio es una herramienta práctica y poderosa más allá de un éxito teórico con la capacidad de separar los datos de audio en partes:
- Accesibilidad: Solves "Kokteyl Party Problem" en audífonos. En ambientes ruidosos como el café o el restaurante; objetos singulares como el tenedor-byek y el whirltu hacen el sonido del orador objetivo solamente.
- Producción: Minimiza errores de tiro en el cine y la producción de contenidos. Un señor de ambulancia o sonido de viento que retrocede sin perturbar el diálogo en las tomas externas puede ser eliminado del disco "como tirado con pinzas". Müzisyens puede separar viejos discos en segundos a vocales e instrumentos.
- Seguridad: Detecta instantáneamente sonidos específicos como fractura de vidrio o grito en seguridad de la ciudad. En ciencias naturales, facilita el seguimiento ecológico aislando el sonido de un único tipo de vida a través de un complejo registro forestal.
La manipulación perfecta de sonidos de esta falsificación digital (profundo) y el riesgo de violaciones de privacidad. Pero Meta está posicionando este modelo como una tecnología más creativa y accesible.
Este modelo en un futuro cercano sistemas operativos inteligentes integrado. Esto significará la edición instantánea del ruido ambiental en llamadas telefónicas sin necesidad de software profesional de capas de audio en vídeos capturados.
¿Cómo utilizar en el futuro cercano?
Cuando la tecnología se haya convertido en la última, entrará en nuestras vidas de esta manera sin requerir un conocimiento técnico especial:
Meta SAM Audio tecnología convierte el sonido a objetos digitales que pueden ser controlados desde datos simples. Teléfonos inteligentes A diferencia del bloqueo de ruido estándar, el sonido hace una intervención quirúrgica objetando. En una llamada telefónica, el bebé que llora por la espalda o el ruido callejero está completamente separado del altavoz; los sonidos externos son destruidos por la precisión del estudio y sólo una voz clara se transmite al lado opuesto.
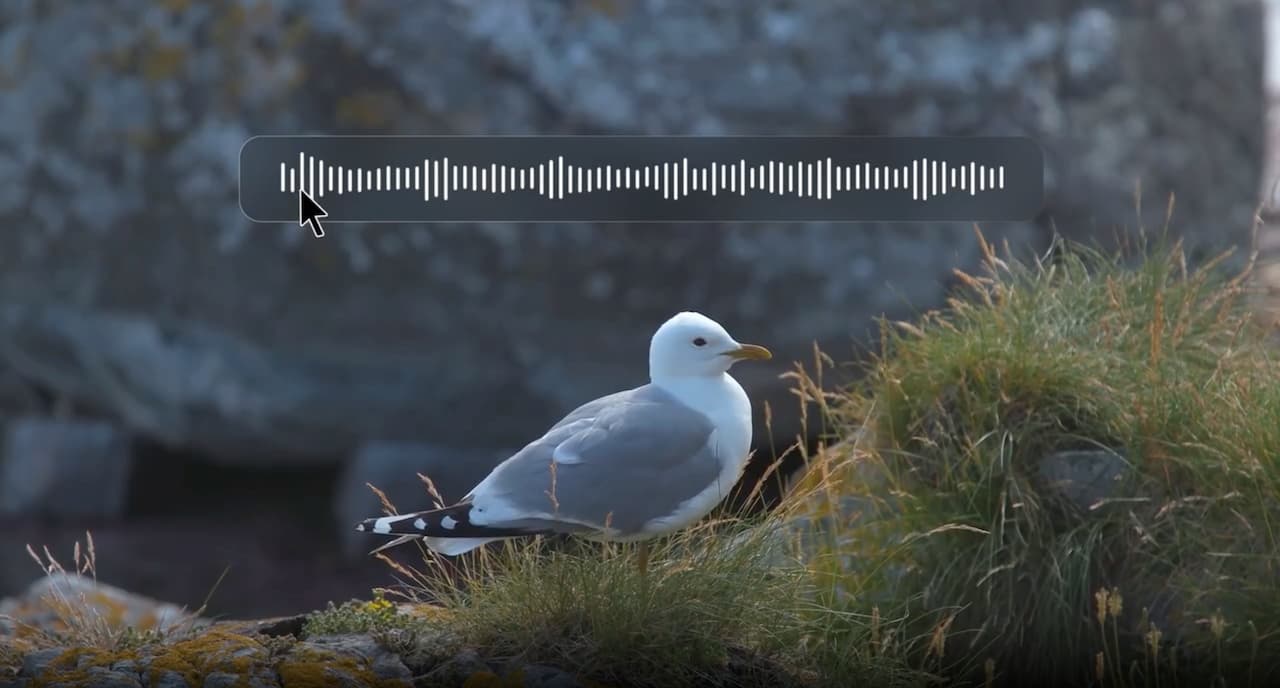
Medios sociales y edición de vídeo El modelo le da al usuario un borrador visual separando el canal de audio en piezas como un rompecabezas. En la fase de carga de vídeo, los sonidos no deseados de sonidos definidos automáticos como viento, aves o tráfico pueden ser eliminados por un clic. SAM Audio le permite producir contenido de calidad profesional llenando la cavidad de audio eliminada con un silencio natural.
Ayudas auditivas en el campo, "Kokteyl Party Problem". Gracias a los usuarios de "Modo de Liberación" pueden codificar y celos como "objeto no deseado" en la mesa lateral. Esta tecnología mejora la interacción social desde la raíz, permitiendo que el dispositivo transmita sólo los sonidos específicos en el cristal.
AdminHIX AI: Çok Yönlü İçerik Üretim Platformu Rehberi
Stream Ring: Yapay Zeka ile Güçlendirilmiş Akıllı Yüzük Satışa Açıldı!
Artículos relacionados
Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión