



¿Por qué la Inteligencia Artificial sabe información incorrecta?
Traducido automáticamente
 Autor
En investigación con modelos de idiomas grandes (LLM), las respuestas ofrecidas en los flujos de trabajo o los procesos de aprendizaje diarios pueden verse altamente competentes, fluidas y persuasivas. Sin embargo, cuando el texto dado es examinado en detalle; un estudio académico que se muestra en la fuente puede surgir que la decisión judicial o acontecimiento histórico es completamente ficticio.
Esta situación trae una pregunta crítica a la mente de los usuarios: ¿AI comete errores, es la inteligencia artificial confiable?
Las herramientas de inteligencia artificial no son una combinación de mecanismo de control de precisión o un motor de búsqueda clásico. Conocer los principios de trabajo detrás de estos sistemas hace más fácil responder a la pregunta de lo que es alucinación de inteligencia artificial y pasar las salidas producidas de los tensores adecuados.
¿Qué es Inteligencia Artificial?
Alucinación de inteligencia artificial en la literatura tecnológica; es la condición de que un modelo de inteligencia artificial no exista en realidad, lógicamente información básica o verbalmente incorrecta es extremadamente confiado, consistente y fluidamente realizado con una narración.
A diferencia de las corduras en la psicología humana, el proceso aquí en adelante no es una ilusión consciente o engaño intencional. El modelo rompe completamente de la realidad caseual mientras que matemáticamente construye la matriz de palabras más lógica.
Análisis de alucinaciones de inteligencia artificial de IBM en el marco; estos modelos no pueden distinguir el mal con el derecho como en la mente humana. Los sistemas sólo calculan qué satélites a las imágenes de los datos educativos (patterns) y llenan las brechas a través de la "confabulación" (mirror) cuando encuentran la brecha de información. Por ejemplo, en el caso de un abogado preparado usando ChatGPT en los EE.UU. en 2023, el modelo se ha identificado que las ideas inexistentes, números de archivo y decisiones de juicio falso no se realizan. Dado que el modelo imita imperfectamente la estructura de textos de derecho real, el texto falso apareció a primera vista no se distinguió.
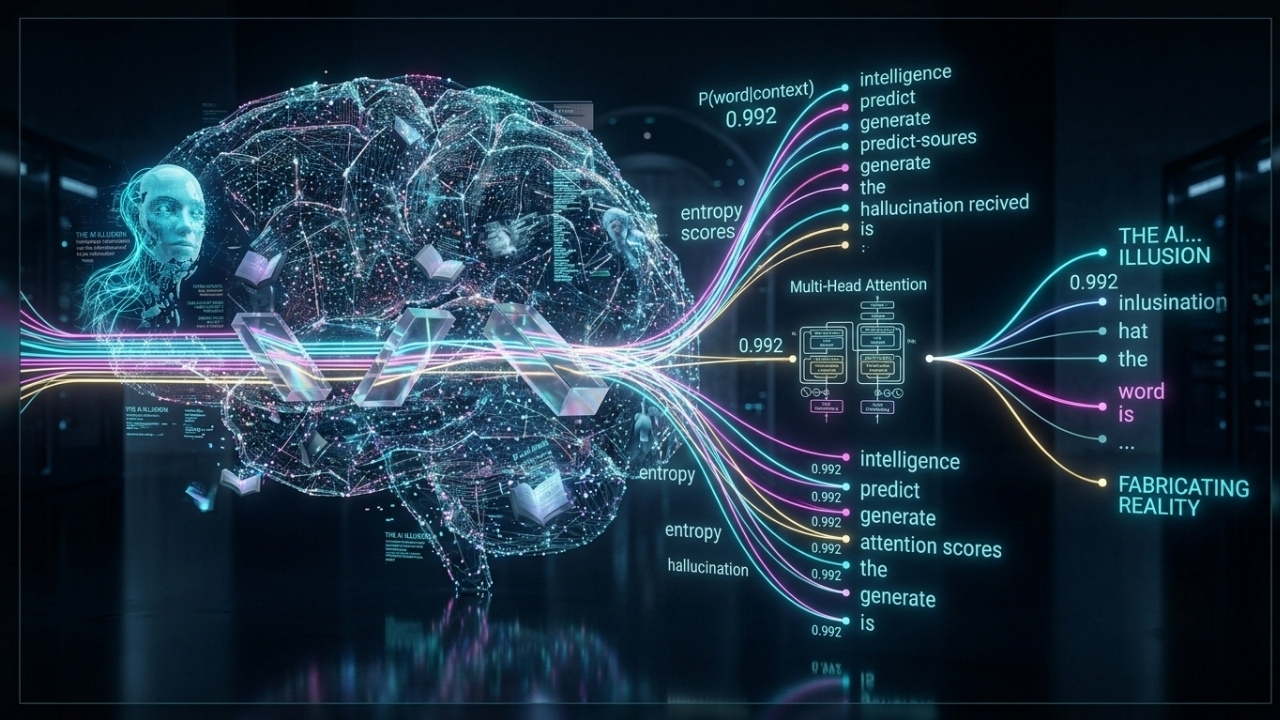
Diferencia entre inteligencia artificial y error ordinario
Cualquier respuesta incorrecta a la inteligencia artificial no se evalúa en la categoría de alucinación. Una vieja población de un modelo se encuentra dentro del alcance del "error errante" para dar la información del idioma en la traducción o para ser reflejada en un cálculo técnico. Los errores ordinarios pueden ser seguidos y corregidos principalmente a través de una norma de datos o transacciones perdidas en el conjunto educativo.
Halusination es que a pesar de que no hay datos reales en el suelo del modelo y lo entrega con un tono de realidad preciso. Esto hace que la detección de alucinaciones sea mucho más difícil que los errores comunes.
¿Por qué la Inteligencia Artificial sabe información incorrecta?
En primer lugar, para entender que la inteligencia artificial produce falsos productos Básicos y proceso de desarrollo de la tecnología de inteligencia artificial Necesitas saberlo. Cuando los modelos se entienden básicamente que hay una arquitectura de procesamiento de datos únicos y cálculo de probabilidad, la lógica de las acciones de error también es clara:
1. Pronóstico estadístico y posible Manik
Los modelos de lenguaje grande trabajan con el principio de predecir la siguiente palabra (token). Modelo, "Esto es lo más probable para llegar a qué palabra en estadística después de la expresión?" se centra en responder a la pregunta. La exactitud fáctica de la frase de prioridad para el modelo no es la estructura del lenguaje y en términos de núcleo significado. Con la ejecución lógica, la probabilidad estadística ocurre cuando el techo.
2. Datos de capacitación perfectos, inestables o sobre satélites
Los modelos se entrenan escaneando recursos abiertos, artículos y textos digitales en el entorno de Internet. La información errónea contenida en el grupo educativo se adopta como norma general por el modelo de prejuicios o declaraciones contradictorias. Además de esto, cuando el modelo se adapta a los datos educativos (sobreajuste) pierde la capacidad de generalizar y establecer conexiones incorrectas por correlaciones sin regla.
3. Proveer el cumplimiento superando los insumos de usuario
Al producir modelos se optimizan para proporcionar respuesta ininterrumpida al comando del usuario (prompt). En lugar de mencionar que la mayoría de las veces no lo sabe, el usuario responderá aceptando la exactitud del problema solicitado. Por ejemplo, cuando se dirige una pregunta básica o ficticia, en lugar de rechazar la pregunta modelo, escribe un escenario ficticio que se ajusta a la suposición del problema.
4. Seguridad al aire libre y mal propósito Manipulación (Prompt Injection)
La inteligencia artificial produce información falsa o engañosa no siempre se debe a la falta de educación del modelo. Las manipulaciones hechas fuera del exterior también pueden desencadenar alucinaciones. Con técnicas de ataque enemigas como la inyección "Prompt", las capas de seguridad del modelo pueden ser manipuladas y asegurar que el sistema produzca productos completamente ficticios, guiados o dañinos. Para entender los mecanismos de fragilidad y defensa contra tales intervenciones de sistemas de inteligencia artificial Lo que es seguridad AI y puede hackear debe abordarse de manera integral. Los filtros de seguridad desaparecen rápidamente la consistencia de la información en modelos que se eliminan o manipulan.
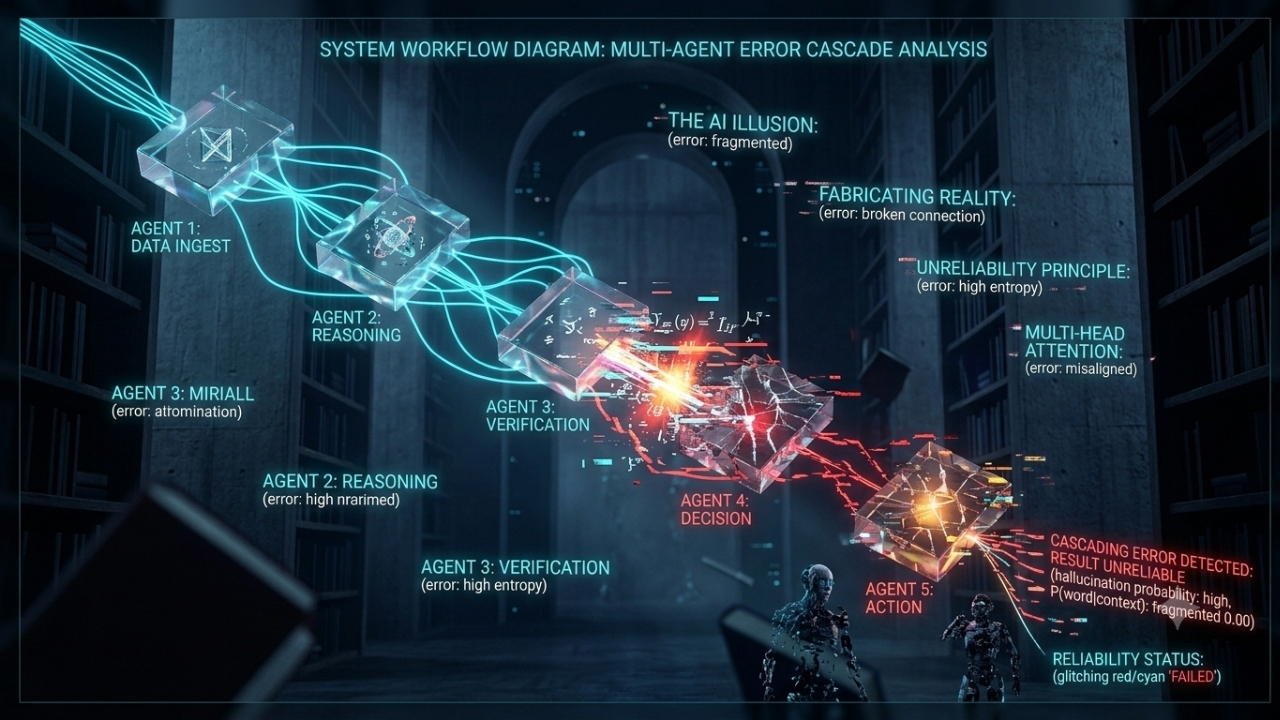
5. Crecimiento de errores en sistemas de múltiples agentes (alucinaciones catastróficas)
Hoy, los agentes de inteligencia artificial autonom trabajan juntos en los flujos de trabajo de encadenamiento. Una sola alucinación producida por el primer agente se considera un hecho verificado por los siguientes agentes y se incluye en los procesos de decisión, está creciendo añadiendo riesgos operacionales y legales.
ChatGPT Error Dos, ¿Es la vida diaria confiable?
Todos los sistemas productivos de inteligencia artificial como ChatGPT y así sucesivamente pueden ser errores regularmente.
La edición de textos es altamente eficiente en áreas como desarrollo de ideas, creación de plantillas de código, traducción de idiomas y resumen de conceptos básicos. Pero es importante saber cómo los ajustes técnicos tales como temperatura (temperatura) o balón p para mejorar la calidad de salida del sistema y controlar la aleatoriedad. Estructuras avanzadas de script aplicadas para aumentar la consistencia de los encuestados recibidos del modelo y para controlar los mueres que caen de nuevo ChatGPT códigos y parámetros ocultos Inicio se puede acceder a través.
En esas esferas que requieren un mecanismo directo de adopción de decisiones, los productos de inteligencia artificial deben evaluarse como fuente final:
Medicina y Salud: El riesgo de producir información falsa o especulativa sobre dosis, síntomas y diagnóstico es alto.
Ley: Podemos producir leyes no excluyentes o ideas falsas.
Estudios Académicos: Welders no existentes, correctores y falsos números DOI son los tipos más comunes de alucinación.
Finanzas: Puede hacer engaños a través de datos de mercado y empresa no confirmados.
Métodos para reducir el riesgo de extinción
Se puede minimizar con las técnicas de uso correcto si no es posible restablecer completamente la parte de error de la inteligencia artificial. Enfoques como la identificación de roles, el pensamiento paso a paso y la limitación de contexto para minimizar el riesgo de inhalación, básica técnicas de ingeniería directamente asociado con.
Estrategia | Propósito | Enfoque del Mando de Muestra |
|---|---|---|
Función y determinación del marco | El área de especulación es estrecha. | " Responder en el marco de la legislación resmî corregida." |
Report Unknown Instruction | Evita el reflejo adecuado. | "Si no estás seguro de que no estás seguro de hacer la predicción, especifique." |
Welding Review and Contexture | Limpia los límites de la base de datos. |
"Adheriendo al texto en el texto, responda las preguntas al respecto."
Step Mental Execution
Aumenta la consistencia lógica.
"Con los pasos que sigues antes de llegar al momento."
¿Puedes arreglar el problema de la Halusination?
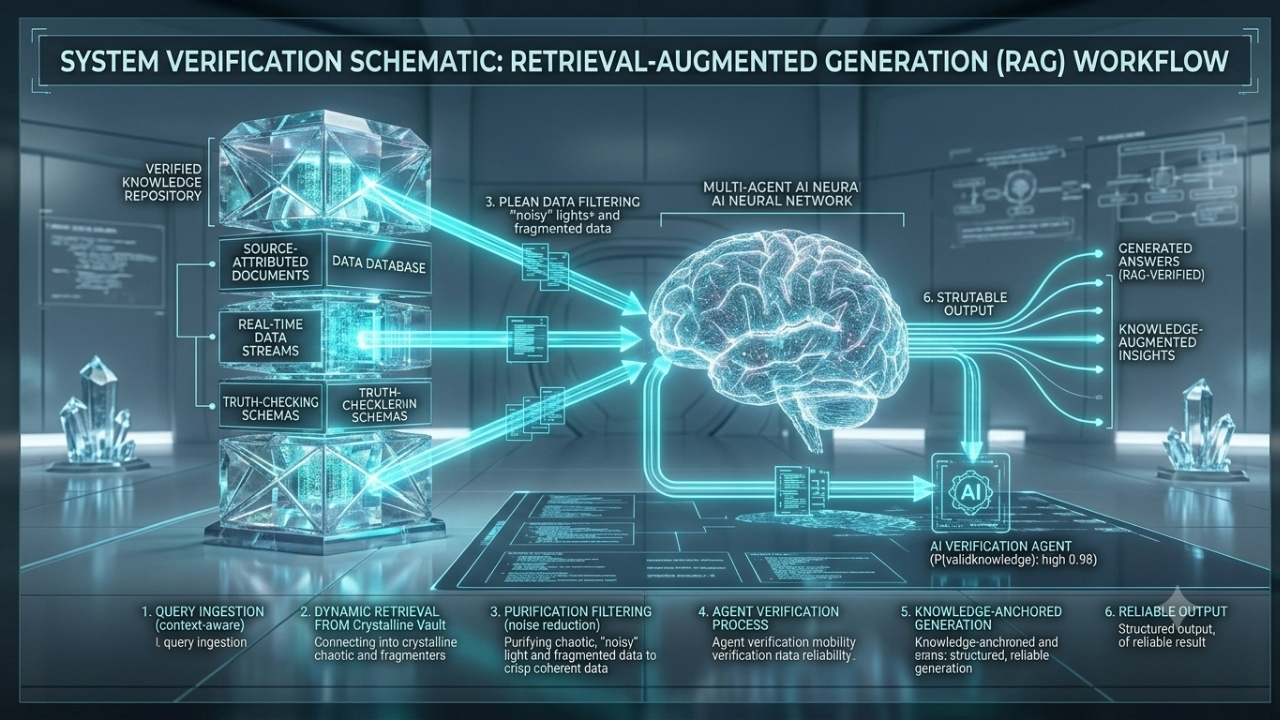
Con el fin de mejorar la fiabilidad de los modelos de inteligencia artificial y minimizar el riesgo de alucinación, se realizan estudios intensivos en el mundo académico y las empresas tecnológicas. Hoy en día, la solución arquitectónica más común y funcional en esta área destaca como RAG (Retrieval-Augmentmented Generation / Producción Repurificada). El modelo de lenguaje en el método RAG se aplica a fuentes de información externa confiables, tales como vincular directamente la cintura con los posibles partidos en su memoria paramétrica cerrada; consulta de bases de datos de compañías instantáneas, directorios web actualizados o documentos resmî verificados. Después de retirar los datos brutos pertinentes de estas fuentes, configura la respuesta activando su capacidad avanzada de síntesis de idiomas. Así, el reflejo "espacio de llenado" del modelo está controlado en gran medida, y la información se coloca sobre una base verificada.
Además de la arquitectura RAG, la nueva generación de técnicas educativas, que son transparentes sobre los pasos lógicos de los modelos (razonamiento), el aprendizaje de retroalimentación-consolidación (RLHF - Reinforcement Learning from Human Feedback) y los filtros de precisión automática que los supervisores de inteligencia artificial se activan gradualmente aumentan sus tasas de precisión. Además, los mecanismos de autoproducción (autocorrección) que los modelos prueban su lógica interna antes de generar la respuesta se integran en el sistema.
A pesar de todos estos avances tecnológicos, los modelos de lenguajes grandes existentes se basan básicamente en la predicción de un "aning" semántico o "coaching"; el token estadístico (kelime/hece) en conjuntos de datos enormes. En estos posibles motores que trabajan matemáticamente, cero error o garantía de precisión absoluta no es teóricamente posible. Los nuevos métodos desarrollados no se restablecen la tasa de alucinación; sólo puede ser detectado, limitado y entra en un socio manejable.
Los sistemas de inteligencia artificial deben ser colocados como auxiliares de apoyo, no como una autoridad de información absoluta o el mecanismo correcto; acelerar el trabajo complejo, pero siempre debe ser tomado del filtro humano (human-en-el-oop) y filtro de pensamiento crítico.
AutorGemini Ücretli mi? Ücretsiz Sürüm ve Tüm Planlar (2026)
KVKK ve Yapay Zeka: Şirketler Ne Yapmalı?
Artículos relacionados
Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión