



Previsiones de infraestructura de datos: ¿Qué le espera en 2026?
Traducido automáticamente
 Autor
La infraestructura de datos ha estado fuera de los sistemas de base que satisfacen la necesidad de almacenamiento de datos e información en 2026. De esta manera, la inteligencia artificial se ha convertido en el determinante básico de los mecanismos de decisión autónomos y los procesos analíticos en tiempo real. Hoy, desde que se han hecho los datos, se llegó directamente a la situación pertinente con la forma en que se modelan los datos y cómo se entiende. Esta conversión; almacenes de datos tradicionales, oleoductos ETL sólidos y cuestionar directamente la separación analítica-operacional. Según las previsiones 2026; se destacarán arquitecturas más abiertas, modulares y compatibles con IA en la infraestructura de datos.
¿Viene el fin de los sistemas analíticos y operativos?
El concepto de arquitectura clásica de datos se construyó en dos mundos separados durante años. Realizan operaciones diarias Sistemas operativos (OCTP) con apoyo para la presentación de informes y la adopción de decisiones Sistemas analíticos (OLAP) clasificable. This approach was inevitable to delays and complex integration layers in data replication. Pero con productos digitales modernos, se acercó al final de esta separación.
¿Por qué significa esto?
- Pronóstico de presentación de informes en tiempo real
- Los modelos AI necesitan datos de producción en vivo
- Streaming and event-driven architectcomúnización
- Preguntas sin copiar datos (análisis de copia cero) enfoques
En la visión de la infraestructura de datos 2026, los datos se utilizan ahora para fines múltiples a través de una única fuente confiable sin ser etiquetados como “operacional” o “analítica”. Esto hace que los formatos de datos sean estratégicos para conectar capas y motores de consulta.
Apache Arrow y ADBC: New Standards in Data Connection
La columna vertebral de la arquitectura moderna de datos Apache Arrow 2026 pronósticos de infraestructura de datoses la base de ello. Arrow elimina los costos de conversión entre diferentes sistemas, permitiendo que los datos se representen en una forma basada en columnas y estándar en memoria.
¿Por qué es importante Apache Arrow?
- Alto rendimiento analítico gracias al diseño de memoria basado en columnas
- Python, Java, C++, Rust
- Compartir sin copiar datos (copia cero)
- Estructura adecuada para CPU, GPU y procesos vectorizados
- Ver el ecosistema de datos como un lenguaje común
¿Qué cambia ADBC con la conectividad de base de datos Arrow?
ADBCes una alternativa moderna a ODBC y JDBC. Con este estándar de conexión basado en Arrow, los datos no se mueven en la práctica, la aplicación aborda los datos; la integración entre motores analíticos es simplificada y lo más importante, se eliminan las barreras entre los sistemas de ciencia de datos y producción.
Formatos de tabla abierta: Apache Iceberg ¿Por qué 2026 ganador?
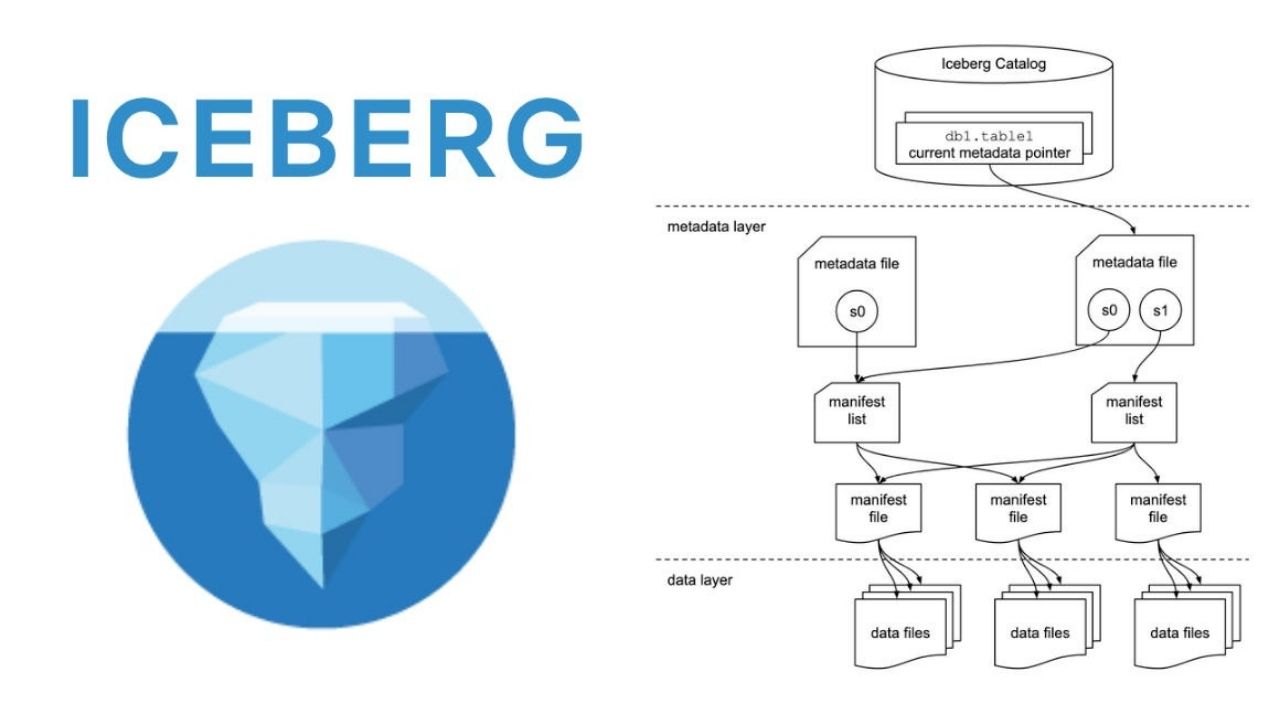
Apache Iceberg No sólo equipos técnicos hoy en día; CTO y gestores de datos son también un tema en la agenda. Iceberg destaca como un formato de mesa abierta que combina la flexibilidad del lago de datos (data lacquer); disciplinas del almacén de datos.
Competencias básicas Iceberg revelado
- Operaciones de mesa compatibles con ACID Inicio
- Soporte para viajes de ida y vuelta
- Evolución de la evolución y compatibilidad retrospectiva
- Hacer el nivel del archivo pero en el comportamiento de la mesa
- Hacer gestión y tablas confiables en formatos de archivos como Parquet
El distribuidor es escalable sin adicción; soporte multimotor como Spark, Trino, Flink, DuckDB; reunir análisis en tiempo real y por lotes en el mismo piso, en 2026, Iceberg está ahora clasificado entre formatos de mesa abierta.
DuckDB y DataFusion: End of Monolytic Data Warehouses
Los almacenes de datos tradicionales eran sistemas costosos y a menudo flexibles. Sin embargo, las nuevas tendencias en el almacén de datos revelan la importancia de soluciones escaladas según la necesidad.
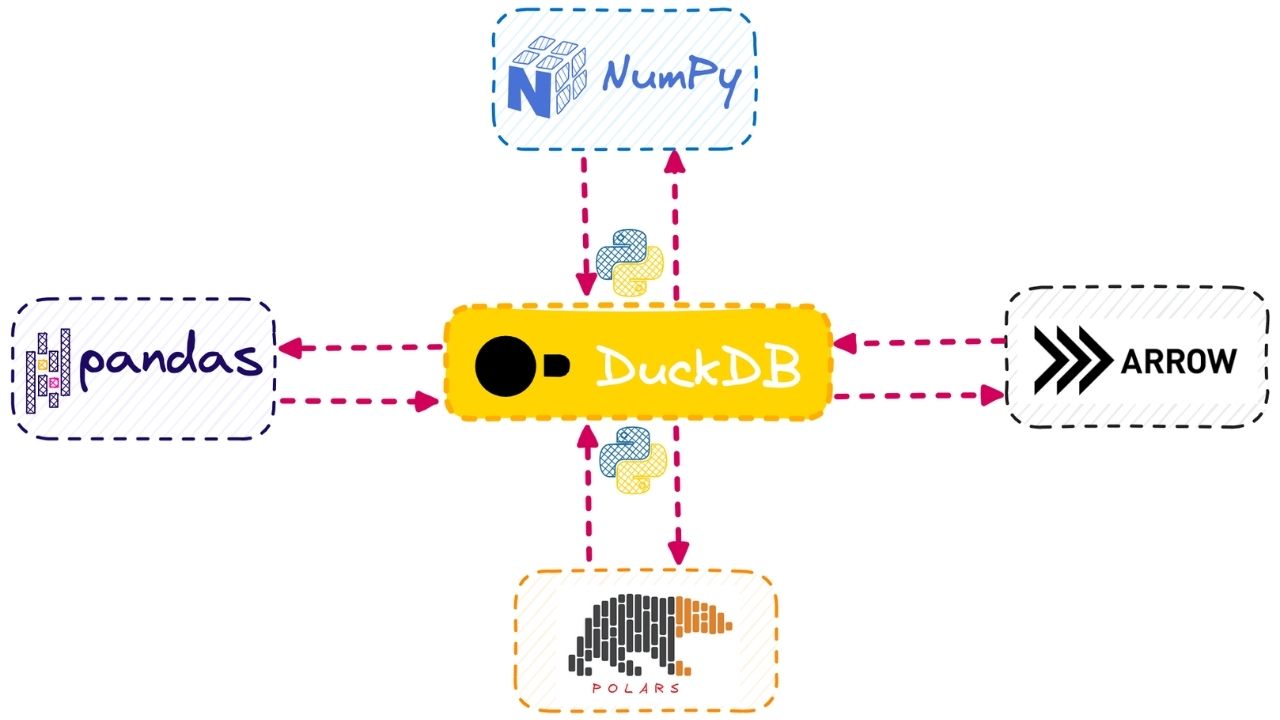
HomeLas consultas analíticas son un motor de búsqueda del servidor que puede funcionar directamente en archivos:
- Funciona sin instalación.
- Consultas directas de mesas de Parquet e Iceberg.
- Python es compatible naturalmente con R y herramientas de ciencia de datos.
- Proporciona análisis escalables a la magia pequeña.
- Hace que el almacén de datos sea un componente no-servicio.
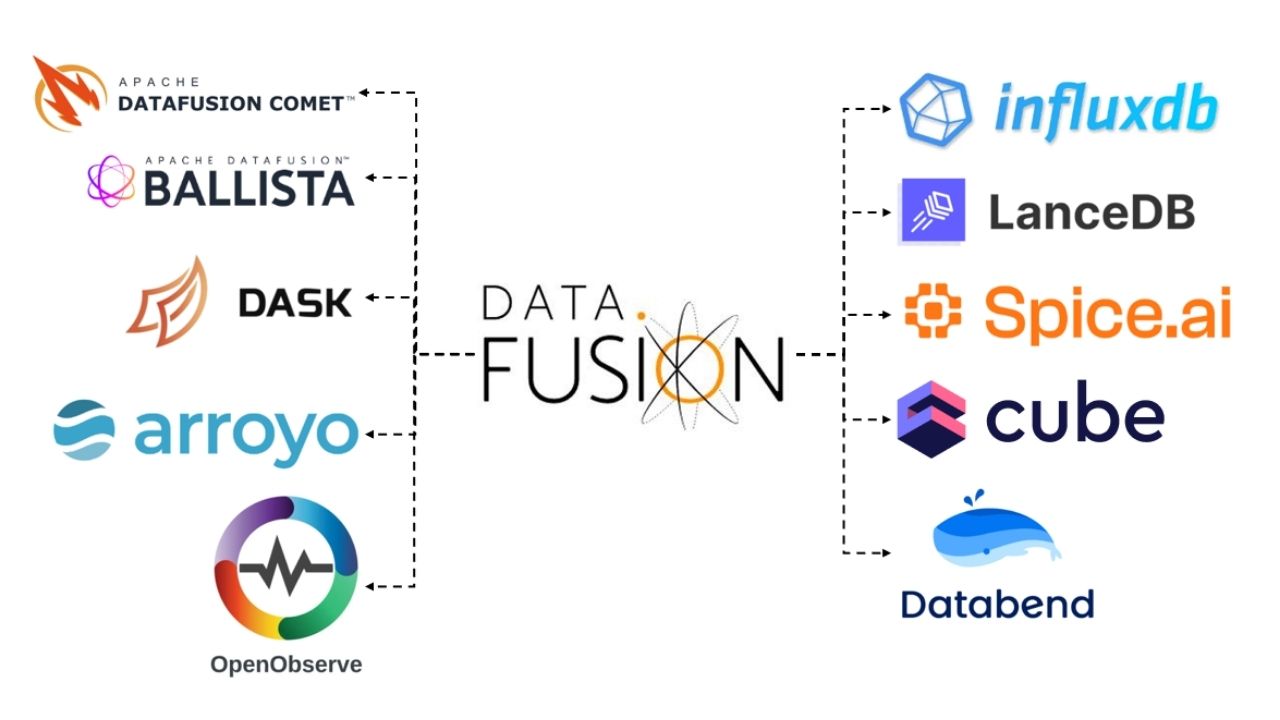
Apache DataFusion es un motor de consulta de alto rendimiento construido sobre el ecosistema de Arrow:
- Rust está basado y proporciona seguridad de memoria
- Puede trabajar en arquitecturas incrustadas o distribuidas
- Compatible con cargas de trabajo de Streaming y AI
DuckDB y DataFusion Al considerar la ubicación de los almacenes de datos monolíticos analítica composible enfoque se ve.
¿Por qué el pensamiento crítico de los datos de la tabla para agentes de inteligencia artificial?
Sistemas de inteligencia artificiales en 2026 no sólo producirán texto; interactuar con datos, toma de decisiones y área de acción Agentes de inteligencia vendrá a la vanguardia. El éxito de estos agentes se asociará directamente a la calidad de la infraestructura de datos. La arquitectura de datos de inteligencia artificial está instalada en tablas de Iceberg y formatos de memoria Arrow. La futura ingeniería rápida no desempeñará un papel decisivo en la ingeniería de datos. También las normas abiertas seguirán siendo el requisito previo de la escalabilidad de la IA. En 2026, la infraestructura de datos está cerrada y no es monolítica, abierta y modular, basada en mesas, pero nativa de laca, se espera que el análisis al mismo tiempo esté casado.
| 2026 Tendencias de datos | Punto focal principal | Efecto previsto |
| Apache Iceberg | Formatos de tabla abierta | Normalización y éxito de producción |
| Multi-Engine Stack | Almacenamiento y separación de carga | Ahorro de costos y flexibilidad |
| AI Agent Integration u | Datos configurados (Tabular) | Acceso rápido y seguro a datos Inicio |
| ADBC Standards | Data Connection Layer | Cambio de viejo ODBC/JDBC Systems Home |
AutorApple Creator Studio: Tek Platformda Yaratıcılık Ekosistemi
Yazılım Mühendisliğinde 2026 AI Trendleri
Artículos relacionados
Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión