



Solución para la Halusination en Inteligencia Artificial: ¿Qué es la arquitectura RAG?
Traducido automáticamente
 Autor
Modelos de idiomas grandes (LLM) Aunque tienen una tremenda capacidad lingüística, no se congelan y permanecen en la historia de la licencia de datos educativos, y pueden producir información falsa que confía en lo que saben. Es el RAG arquitectónico que hoy se ha convertido en el estándar de la industria para resolver este problema llamado Halusination y hablar de inteligencia artificial con los datos actuales de la empresa verificada.
¿Qué es exactamente la generación aumentada de recuperación?
RAG es un marco que permite que un modelo de inteligencia artificial se aplique a una base de datos de información confiable desde el exterior antes de responder. Los modelos de lenguaje tradicional sólo responden a información cerrada que aprenden en la fase educativa y se ocultan en peso. La arquitectura RAG abre este sistema cerrado al mundo exterior; da al modelo la capacidad de probar un "libre abierto". Por lo tanto, el problema de la deficiencia de datos o la actualización sobre la base de la pregunta causada por la inteligencia artificial se resuelve mediante la alimentación de datos dinámicos del modelo.
La importancia de la arquitectura RAG: 2020 ¿Qué nos muestra el artículo de NeurIPS?
Este concepto se sentó en el centro del mundo tecnológico con un artículo innovador publicado por Patrick Lewis y el equipo en Meta AI en 2020. "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tareas" El artículo de NeurIPS 2020 demostró que los modelos de lenguaje pueden dar resultados mucho más exitosos sacando información de una base de datos de Wikipedia sin tener que memorizar todo. Este artículo fue el primer indicador concreto que los modelos pueden captar el éxito de última generación sin eliminar el número de parámetros en trilyons.
¿Cómo funciona un sistema RAG paso a paso?
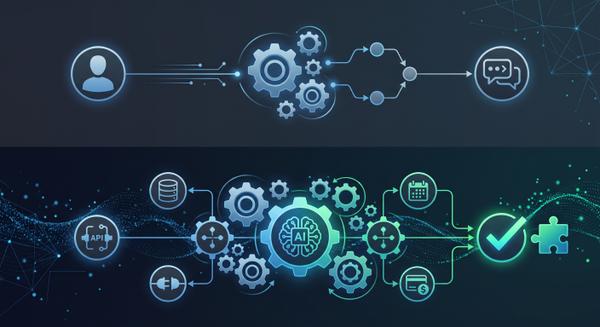
La arquitectura RAG consiste en dos fases básicas como su nombre sugiere: Recordar (Retrieval) y Producción (Generación). Cuando el usuario hace una pregunta al sistema, el modelo detiene el proceso en lugar de responder directamente. El módulo de memoria que funciona con la lógica del motor de búsqueda hace que los documentos más coincidentes de la base de datos externa con la pregunta del usuario. A continuación, estos documentos actualizados se combinan con la pregunta original del usuario (promptromaación) se presentan al modelo de lenguaje grande. El modelo de lenguaje produce una respuesta racional, natural y específica de recursos al usuario final leyendo este contexto nuevo y preciso.
¿Cuál es el papel de las bases de datos vectoriales en el proceso de RAG?
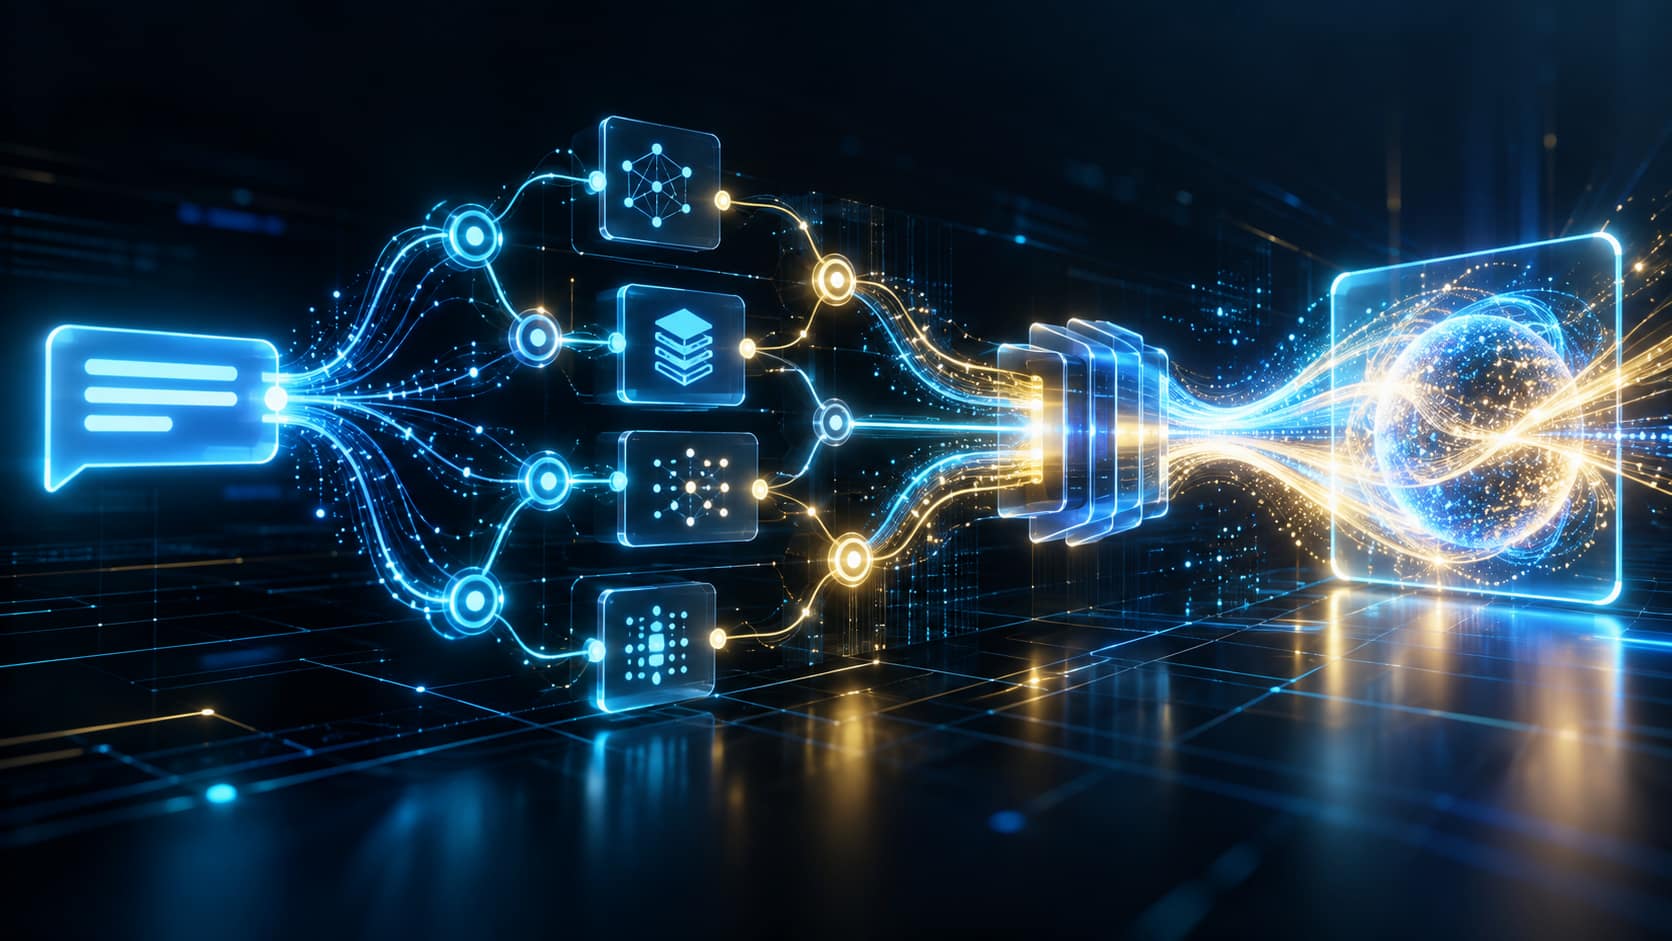
La arquitectura RAG es una base de datos vectorial. Los informes PDF de las empresas no pueden buscar rápidamente por un modelo de idioma en la forma estándar de llamadas al cliente o correspondencia interna. Estos textos se convierten en miles de arrays numéricos ( vectores) con una transacción llamada "Pinkdding". Las bases de datos vectoriales como Pinecone, Milvus o Weaviate almacenan estas secuencias numéricas. Cuando el usuario hace una pregunta, la pregunta se traduce al instante en el vector y los datos significativos más cercanos en la base de datos se emparejan en poco tiempo desde segundos y se vuelven al sistema.
¿Por qué está RAG en modelos de lenguaje grande?
Ninguna empresa que desee integrar inteligencia artificial a nivel corporativo no puede permitirse el discurso del modelo a través de suposiciones. La arquitectura RAG elimina el costo de la reeducación continua. En lugar de gastar millones de dólares de poder de cálculo para enseñar una tabla financiera o un modelo actualizado, el documento correspondiente se añade simplemente a la base de datos vectorial. Además, RAG maximiza la auditabilidad del sistema agregando referencia a “Recibí esta información de la cuarta página del documento X”.
Agente RAG: ¿Dónde está el futuro de la inteligencia artificial?
Tradicional RAG Al igual que una biblioteca estática que encuentra y trae documentos a la pregunta hecha. Pero la nueva generación "Home Las arquitecturas RAG convierten el modelo en una toma de decisiones. Si el sistema no encuentra suficiente información en la primera búsqueda, puede crear nuevas sub consultas, buscar en Internet o activar una API diferente para verificar los datos. Se convierte en un agente autónomo que no sólo lee la estrategia de inteligencia artificial, construcción e investigación, cambia los flujos de trabajo de las industrias de densidad de información.
¿Qué piensa la comunidad?
En el ecosistema de desarrolladores, RAG tiene dos opiniones actuales principales sobre el futuro. La mayoría argumenta que RAG siempre seguirá siendo un estándar de la industria con la ventaja de costo y precisión, a pesar de la expansión de la ventana contextual. Otro corte son los modelos de nueva generación con enormes ventanas de contexto como 2 millones de fichas (por ejemplo, Gemini 1.5 Pro) predice que toda la base de datos puede reducir la necesidad de infraestructuras complejas de bases de datos vectoriales en el futuro, como puede leer inmediatamente.
Preguntas frecuentes
¿Cuál es la diferencia entre RAG y Fine-Tuning?
El ajuste fino restringe los pesos interiores para cambiar permanentemente el comportamiento o la estructura lingüística del modelo; RAG no cambia el modelo, ofrece una memoria instantánea (link). Para añadir información actual, RAG se utiliza un ajuste fino para adaptar el estilo de expresión del modelo a la industria.
¿Es caro construir arquitectura RAG?
El modelo de idioma es mucho más rentable cuando se compara con el tren desde cero o el ajuste continuo. Las bases de datos de vectores y las operaciones de recuperación pueden llevarse a cabo de manera eficiente incluso con hardware bastante barato.
¿El sistema RAG reinicia completamente alucinaciones?
Reduce significativamente si se reinicia completamente. El modelo a veces puede malinterpretar los datos desde el exterior o ejecutar el contexto, pero debido a que funciona basado en la fuente, la detección del error es mucho más fácil y corregible.
AutorSağlık Sektöründe NLP ve Şeffaflık: Klinik Modellerde Güven
Vibe Coding Uygulamaları 16 Bin Veritabanını Açıkta Bıraktı
Artículos relacionados
Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión