Saltar al contenido
Volver a la lista de blogs
Titans ve MIRAS: AI Uzun Süreli Bellek Sorununu Çözüyor
Ciencia de datos

Titans y MIRAS: AI Long Time Memory Troubleshooting

Traducido automáticamente
Büşra Özer
Büşra ÖzerAdmin
4 min de lectura

En el mundo de la inteligencia artificial, especialmente los modelos de lenguaje grande (LLM) están olvidando información pasada al procesar enormes pilas de datos, o el costo de recordar esta información es llegar a niveles astronómicos. Presentado por el equipo de investigación Google Arquitectura Titans y Marco MIRASEtiquetas "Memorización de última hora" (prueba la memorización instantánea) AI promete traer una solución permanente al problema de memoria a largo plazo con su capacidad.
ai uzun süreli bellek sorunu

Esta nueva tecnología puede procesar millones de contexto token (contexto) sin pérdidas y alta velocidad actualizando los parámetros de memoria activamente mientras que a diferencia de los modelos estándar Transformer. En este artículo revisaremos la profundidad técnica de Titans y MIRAS, cómo AI convierte la capacidad de modelado de secuencias y detalles basados en recursos académicos de esta innovación.

¿Qué es Titans y MIRAS? Fundamentos técnicos e innovaciones

Arquitectura tradicional transformador, "atención" ofrece una excelente memoria a corto plazo con el mecanismo; pero el costo del cálculo aumenta drásticamente a medida que aumenta la longitud del array. Google investigadores de Ali Behrouz, Meisam Razaviyayn y Vahab Mirrokni 4 de diciembre 2025 anunció este estudioEtiquetas RNN (Norious Networks with Burning) combinar la velocidad con la precisión de los transformadores.

  • Titans Architecture: Esta es la herramienta "física" del sistema. Titanes, a diferencia de la memoria RNN tradicional de tamaño fijo, resume datos pasados usando una red nerviosa profunda (sensor multicapa - MLP).
  • MIRAS Frame: MIRAS (blueprint) es un marco teórico desarrollado para generalizar estos enfoques. Define el modelado de secuencia como un problema de "memoria tradicional" (memoria asociativa) y distingue la arquitectura de memoria en cuatro componentes principales, incluyendo la atención reflejada (sesgo atencional), puerta de retención (puerta de retención) y algoritmo de memoria.

¿Cómo funcionan los Titanes? Aprendizaje activo con "Surpriz Metriği"

Lo que hace único a Titanes es aprender qué recordar activamente en lugar de almacenar datos pasivamente. En este proceso, la tendencia de "obtener eventos inesperados" en la psicología humana se transforma en un modelo matemático.

  • Civilización sorpresa (Metricidad Sorpresa): El modelo mide la diferencia entre los nuevos datos y el estado de memoria actual. Si los datos se ajustan a una caliba esperada (bajo sorpresa), la memoria no se actualiza. Sin embargo, si los datos son inesperados (alta sorpresa), esta información está marcada como "preparada" y se guarda principalmente a la memoria a largo plazo.
  • Momentum y Remember Gate: Titans utiliza un mecanismo de impulso que tiene en cuenta no sólo esa sorpresa momentánea, sino también el flujo de sorpresas en el pasado. También aplica la degradación del peso adaptable (permitiendo la puerta) que ya no necesita gestionar la capacidad de memoria limitada.

Marco MIRAS: Transición a Más Allá del Paradigma MSE

La mayoría de los modelos disponibles se basan en métodos estándar como Error Squares Media (MSE) o palpitabilidad de puntos al comparar los datos. MIRAS ofrece los formatos de "Objetivos únicos" y nueva edición (regularización) que supera esta restricción. En este marco se elaboraron tres modelos especiales:

  1. YAAD: Más resistente a los errores (Usa la pérdida deHuber), realiza un alto rendimiento en datos sucios o no consistentes.
  2. Móvil: Se dirige a una memoria estable a largo plazo utilizando reglas más disciplinadas y sanciones matemáticas complejas (normas generadas).
  3. MEMORA: Son difíciles de tratar la memoria como un mapa de probabilidad sólida para maximizar la estabilidad de la memoria.
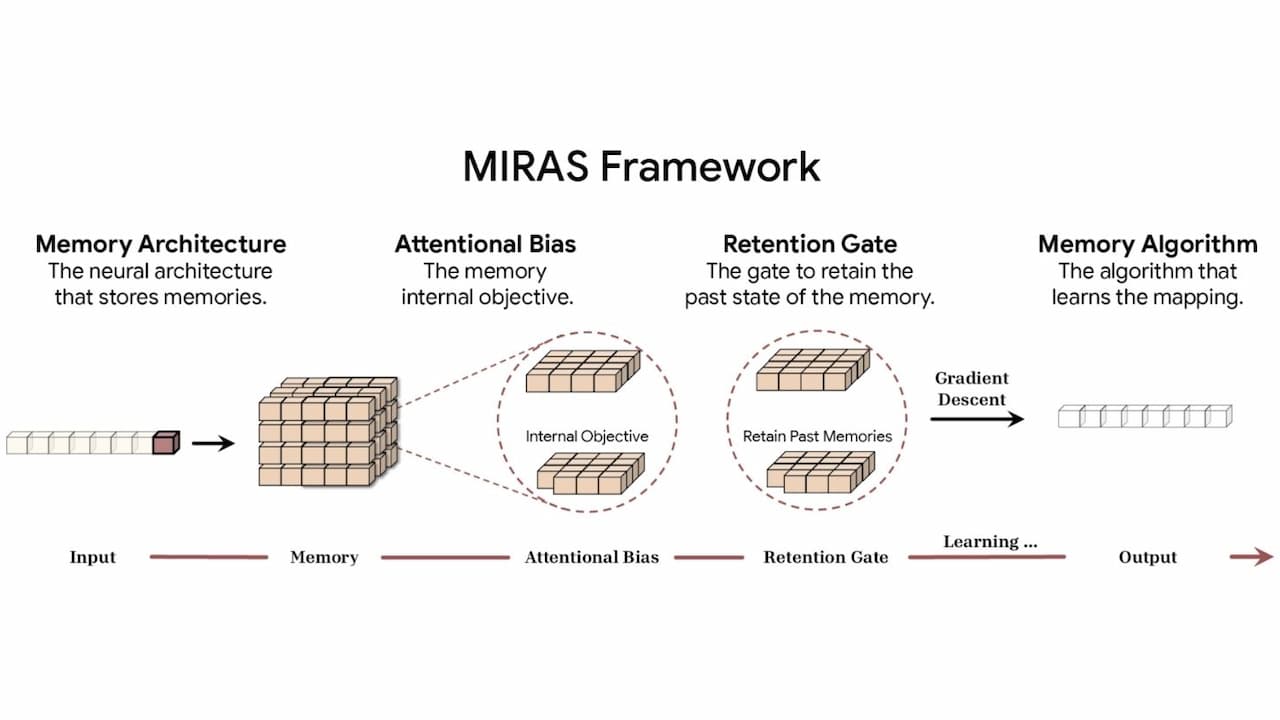
miras framework gorseli

¿Cuáles son los resultados de la memorización y el rendimiento del tiempo de prueba?

Las variantes de Titans y MIRAS se han comparado con las arquitecturas líderes por sectores como Transformer+++, Mamba-2 y Gated DeltaNet.

  • Sobre Long Connect Reall: modelos gigantes como Titans, GPT-4 en pruebas de referencia BABILong que quedan atrás, aunque tiene mucho menos parámetros.
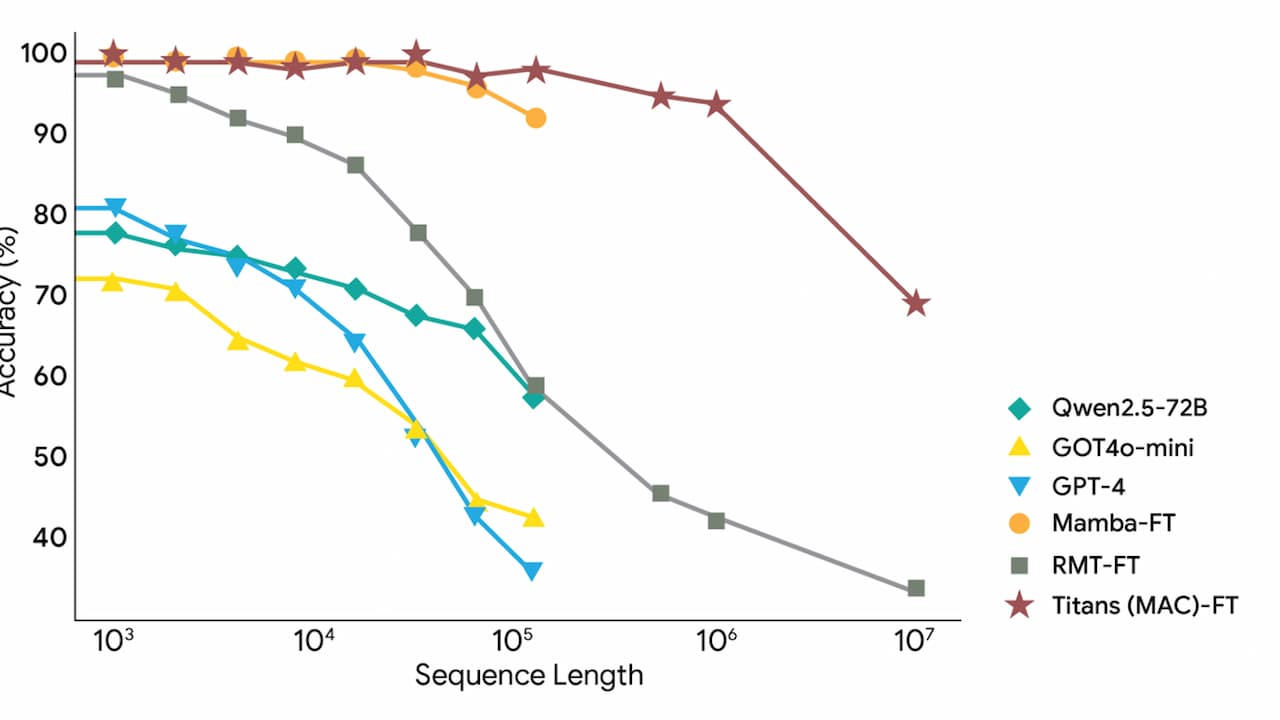
  • 2 Millones de Token Limit: La investigación ha demostrado que Titans puede escalar efectivamente ventanas de contexto más grandes que 2 millones de fichas.
  • Genomic and Time Series Success: Titanes no sólo se limitó a los textos; el modelado de ADN (GenomicsBenchmarks) y las tareas de previsión de series temporales también dieron los mejores resultados (estado del arte).
  • Performance of Titans on extreme long-context reasoning

    ¿Por qué son Titanes y MIRAS Inteligencia Artificial del Futuro?

    Los modelos tradicionales tenían que eliminar información antigua cuando ejecutaban documentos enormes o desaceleraban o ejecutaban ventana contextual. La arquitectura de Titans ha demostrado que el aumento de la profundidad de memoria (L M) reduce la complejidad y el modelo sigue siendo más "tutarlı".

    El marco MIRAS ha completado el anillo perdido entre la optimización en línea, la memoria de relación y el diseño de arquitectura al traer la unidad teórica al mundo de modelado de inteligencia artificial. Esto significa que la inteligencia artificial no es sólo un sistema de "no campo" que sintetiza y comprende toda la historia que lee.

    De esta manera, el problema AI de Memoria a largo plazo estandarizará el uso de inteligencia artificial de largo contexto (AI de largo contexto) en muchas áreas, desde análisis genómicos hasta exámenes legales de documentos completos. Esta revolución de Google Research abre una nueva página sobre inteligencia artificial combinando la eficiencia RNN con el poder Transformer.

    En el mundo de la inteligencia artificial, especialmente los modelos de lenguaje grande (LLM) están olvidando información pasada al procesar enormes pilas de datos, o el costo de recordar esta información es llegar a niveles astronómicos. Presentado por el equipo de investigación Google Arquitectura Titans y Marco MIRAS Etiquetas "Memorización de última hora" (prueba la memorización instantánea) AI promete traer una solución permanente al problema de memoria a largo plazo con su capacidad. Esta nueva tecnología puede procesar millones de contexto token (contexto) sin pérdidas y alta velocidad actualizando los parámetros de memoria activamente mientras que a diferencia de los modelos estándar Transformer. En este artículo revisaremos la profundidad técnica de Titans y MIRAS, cómo AI convierte la capacidad de modelado de secuencias y detalles basados en recursos académicos de esta innovación. ¿Qué es Titans y MIRAS? Fundamentos técnicos e innovaciones Arquitectura tradicional transformador, "atención" ofrece una excelente memoria a corto plazo con el mecanismo; pero el costo del cálculo aumenta drásticamente a medida que aumenta la longitud del array. Google investigadores de Ali Behrouz, Meisam Razaviyayn y Vahab Mirrokni 4 de diciembre 2025 anunció este estudio Etiquetas RNN (Norious Networks with Burning) combinar la velocidad con la precisión de los transformadores. Titans Architecture: Esta es la herramienta "física" del sistema. Titanes, a diferencia de la memoria RNN tradicional de tamaño fijo, resume datos pasados usando una red nerviosa profunda (sensor multicapa - MLP). MIRAS Frame: MIRAS (blueprint) es un marco teórico desarrollado para generalizar estos enfoques. Define el modelado de secuencia como un problema de "memoria tradicional" (memoria asociativa) y distingue la arquitectura de memoria en cuatro componentes principales, incluyendo la atención reflejada (sesgo atencional), puerta de retención (puerta de retención) y algoritmo de memoria. ¿Cómo funcionan los Titanes? Aprendizaje activo con "Surpriz Metriği" Lo que hace único a Titanes es aprender qué recordar activamente en lugar de almacenar datos pasivamente. En este proceso, la tendencia de "obtener eventos inesperados" en la psicología humana se transforma en un modelo matemático. Civilización sorpresa (Metricidad Sorpresa): El modelo mide la diferencia entre los nuevos datos y el estado de memoria actual. Si los datos se ajustan a una caliba esperada (bajo sorpresa), la memoria no se actualiza. Sin embargo, si los datos son inesperados (alta sorpresa), esta información está marcada como "preparada" y se guarda principalmente a la memoria a largo plazo. Momentum y Remember Gate: Titans utiliza un mecanismo de impulso que tiene en cuenta no sólo esa sorpresa momentánea, sino también el flujo de sorpresas en el pasado. También aplica la degradación del peso adaptable (permitiendo la puerta) que ya no necesita gestionar la capacidad de memoria limitada. Marco MIRAS: Transición a Más Allá del Paradigma MSE La mayoría de los modelos disponibles se basan en métodos estándar como Error Squares Media (MSE) o palpitabilidad de puntos al comparar los datos. MIRAS ofrece los formatos de "Objetivos únicos" y nueva edición (regularización) que supera esta restricción. En este marco se elaboraron tres modelos especiales: YAAD: Más resistente a los errores (Usa la pérdida deHuber), realiza un alto rendimiento en datos sucios o no consistentes. Móvil: Se dirige a una memoria estable a largo plazo utilizando reglas más disciplinadas y sanciones matemáticas complejas (normas generadas). MEMORA: Son difíciles de tratar la memoria como un mapa de probabilidad sólida para maximizar la estabilidad de la memoria. ¿Cuáles son los resultados de la memorización y el rendimiento del tiempo de prueba? Las variantes de Titans y MIRAS se han comparado con las arquitecturas líderes por sectores como Transformer+++, Mamba-2 y Gated DeltaNet. Sobre Long Connect Reall: modelos gigantes como Titans, GPT-4 en pruebas de referencia BABILong que quedan atrás, aunque tiene mucho menos parámetros. 2 Millones de Token Limit: La investigación ha demostrado que Titans puede escalar efectivamente ventanas de contexto más grandes que 2 millones de fichas. Genomic and Time Series Success: Titanes no sólo se limitó a los textos; el modelado de ADN (GenomicsBenchmarks) y las tareas de previsión de series temporales también dieron los mejores resultados (estado del arte). ¿Por qué son Titanes y MIRAS Inteligencia Artificial del Futuro? Los modelos tradicionales tenían que eliminar información antigua cuando ejecutaban documentos enormes o desaceleraban o ejecutaban ventana contextual. La arquitectura de Titans ha demostrado que el aumento de la profundidad de memoria (L M) reduce la complejidad y el modelo sigue siendo más "tutarlı". El marco MIRAS ha completado el anillo perdido entre la optimización en línea, la memoria de relación y el diseño de arquitectura al traer la unidad teór

    Etiketler:Titans ve MIRAS MimarisiAI Uzun Süreli BellekTest-Time Memorization
    Büşra Özer
    Büşra ÖzerAdmin
    @busraozer

    Comentarios (0)

    Inicia sesión para comentar.

    Iniciar sesión
    Aún no hay comentarios. ¡Sé el primero en comentar!