



Turkish Artificial Intelligence Models: BİLGE, Kumru, T3 AI y Otros
Traducido automáticamente
 Autor
Los modelos de lenguaje grande tienen un hecho muy básico que están revisando mientras que ganchillo el mundo: No importa cuán talentosos modelos gigantes con salidas del valle de silicona, el trabajo se vuelve diferente cuando se trata de inglés. La mayoría de nosotros hemos notado las extrañas frases cochan de traducción que se juntan al trabajar con estos modelos, sin sentido de las expresiones, o simplemente extendiendo un simple problema técnico a un lugar innecesario. Aquí, en este momento, los proyectos nacionales de inteligencia artificial se han convertido en una obligación técnica, no sólo siendo un orgullo nacional.
Hoy, el ecosistema AI desarrollado en Turquía no es una interfaz sencilla frente a los modelos OpenAI o Anthropic. Se construye una infraestructura sólida con la contribución de las comunidades de código abierto capacitadas con sus propios pesos y centradas directamente en la estructura de última generación de turco.
¿Cómo está Denersin?
Una tabla breve primero: cómo se puede acceder a este modelo hoy y si el modelo se activa (14.10.2026).
Home | Desarrollador | ¿Cómo acceder? | Outdoor / Indoor |
|---|---|---|---|
Noticias | TUBITAK | No se ha abierto aún al uso general; para proyectos piloto © Copyright 2018. Todos los derechos reservados. via TUBITAK TICKET | Cerca |
Kumru | VNGRS | Home demosu; Kumru-2B Hugging Face | 7,4B apagado, 2B abierto (Apache 2.0) |
T3 AI | T3 Foundation and Baykar | Abierta como beta en la plataforma social TEKNOFEST en 11.07.2025 | Objetivo de código abierto; no compartió el peso descargable |
Trendyol LLM | Home | Hugging FaceDescargable | Peso exterior |
Home | Bosphorus University TABILab |
Hugging FaceDescargable
Abierto, uso académico no comercial solo m
Home
Home
Privada a instituciones, plataforma construida en institución
Cerca
¿Por qué los modelos globales no están todavía?
Mientras que las IA globales se entrenan con trilyons, una pequeña parte de estos datos consiste en turco. Esta situación plantea dos cuestiones importantes:
Residuos de Token y Alta Facturación:
los sistemas de token diseñados según el inglés no pueden resolver la raíz y lógica adicional del turco. Una palabra simple divide 3-4 piezas (token). Esto añade tanto las facturas de uso de API y extiende el tiempo de generación de respuesta del sistema en la barra.
Cultural and Legal Context:
Es muy arriesgado tomar un análisis de contrato adecuado para el Código Comercial Turco de un modelo global o clasificar la queja del cliente con la sensación correcta. Debido a que el modelo hace referencia a la cultura occidental y la lógica de derecho estadounidense como predeterminado.
Para cerrar este déficit, la academia se centró en desarrollar modelos de inteligencia artificial turca combinando iniciativas públicas e independientes en Turquía.
¿Qué funciona en el sitio? Modelos nativos destacados
Proyectos de inteligencia artificial en Turquía; responde a diferentes necesidades de infraestructuras de gran escala apoyadas por el Estado a soluciones ágiles.
1. BİLGE: Extensive Language Model Family from TÜBİTAK
El paso más concreto y completo del lado público es implementado por TÜBİTAK BİLGEM Noticias El proyecto fue. La mayor reclamación de BİLGE es utilizar el turco como idioma nativo sin traducir de otro idioma.
Diferentes tamaños para diferentes necesidades:
BİLGE no es un modelo único, una familia. Con 1B diseñado para dispositivos móviles y finales, el equilibrio de rendimiento y eficiencia se entrenó de 9B a cero. BİLGE 27B ha sido desarrollado con el método Continuous Pre-Training con datos turcos. Diseñado para tareas complejas de razonamiento, BİLGE 122B sigue en fase de desarrollo.
Devasa English Korpus:
El entrenamiento comenzó con aproximadamente 1 trillón de vocabulario crudo de datos turcos. Se seleccionaron 250 mil millones de fichas de alta calidad de este grupo y los datos se enriquecieron con 500 mil millones de datos sintéticos. El objetivo es captar las expresiones del modelo, los appliques y los términos técnicos en el contexto turco.
Bajo costo de energía:
Su objetivo es gastar menos energía procesal porque utiliza una señal apropiada para el turco. Las instituciones públicas están diseñadas para aplicaciones corporativas donde la seguridad de datos es crítica.
Estado de acceso: Al 14.10.2026, el BİLGE no está abierto al uso general. Para proyectos piloto según el sitio oficial, TUBITAK TICKET puede ser contactado. Los anuncios relacionados con el acceso sólo se anunciaron en los canales oficiales de TÜBİTAK con el Ministerio de Industria y Tecnología.
2. Kumru AI: rápido, centrado y ligero
En el mundo de la empresa, los modelos se centran en la funcionalidad en lugar de entrar en la enorme carrera del parámetro. Desde Kumru AI, Una alternativa turca de LLM que las empresas pueden ejecutar en sus servidores sin gastar grandes presupuestos.
Resumen de textos, clasificación de las demandas de los clientes y establecimiento de un diálogo turco natural Modelo muy exitosoproporciona alta velocidad de distracciones sin eliminar recursos de hardware.
Kumru 7.4 milliardes de VNGRS y puede trabajar en una GPU con 16 GB de VRAM. Home Puede probar la demo en ella; con 2 mil millones de parámetros, el Kumru-2B está abierto con licencia Apache 2.0 en Hugging Face. Para detalles técnicos y límites Kumru AI guía Noticias Mira.
3. T3 AI: Fuente abierta y poder comunitario
T3 AI desarrollado en Baykar asociación comercial con Turkish Technology Team Foundation (T3 Foundation) representa el tamaño de la comunidad del trabajo. En el Modelo 11.07.2025, TEKNOFEST ha sido abierto a usar con versión beta en la Plataforma Social. Durante el anuncio se anunció que contribuiría al proyecto de 1.792 voluntarios de 67 provincias.
El proyecto dice que fue desarrollado como fuente abierta; pero el número de parámetros y pesos modelo aún no se compartieron donde descargar. Si se abren los pesos, puede ser fácil entrenar modelos especiales en áreas como la ley o la medicina.
4. Iniciativas académicas de columna y peso al aire libre
El ecosistema de Turquía no sólo se limita a tres nombres:
Trendyol LLM:
La primera versión de Trendyol LLM fue entrenada con 10 mil millones de fichas en el modelo LLaMA 2 7B de Meta. Siguientes versiones Qwen 2.5 7B pasaron Qwen 3 8B y Gemma 3 bases 12B. Trendyol-LLM-Asure-12B compartido en febrero de 2026 también puede trabajar y establecerse para tareas de comercio electrónico, como la abstracción, pregunta-cevap. Los modelos se comparten principalmente en Hugging Face.
TOURNA:
TURNA, desarrollado por TABILab en el Departamento de Ingeniería Informática de la Universidad de Boğaziçi, es un encoder de 1.100 millones de parámetro basado en el marco UL2, un modelo de idioma turco. Diseñado para tareas de comprensión y generación de texto y compartido para investigación académica no comercial en Hugging Face solo.
Zemberek Heritage:
Biblioteca de procesamiento de idiomas naturales de código abierto HomeUna de las herramientas que se han aplicado durante muchos años en obras básicas como la solución root-ex.
5. MAIN GPT (HAVELSAN): Native Brain of Defense and Corporate Safety
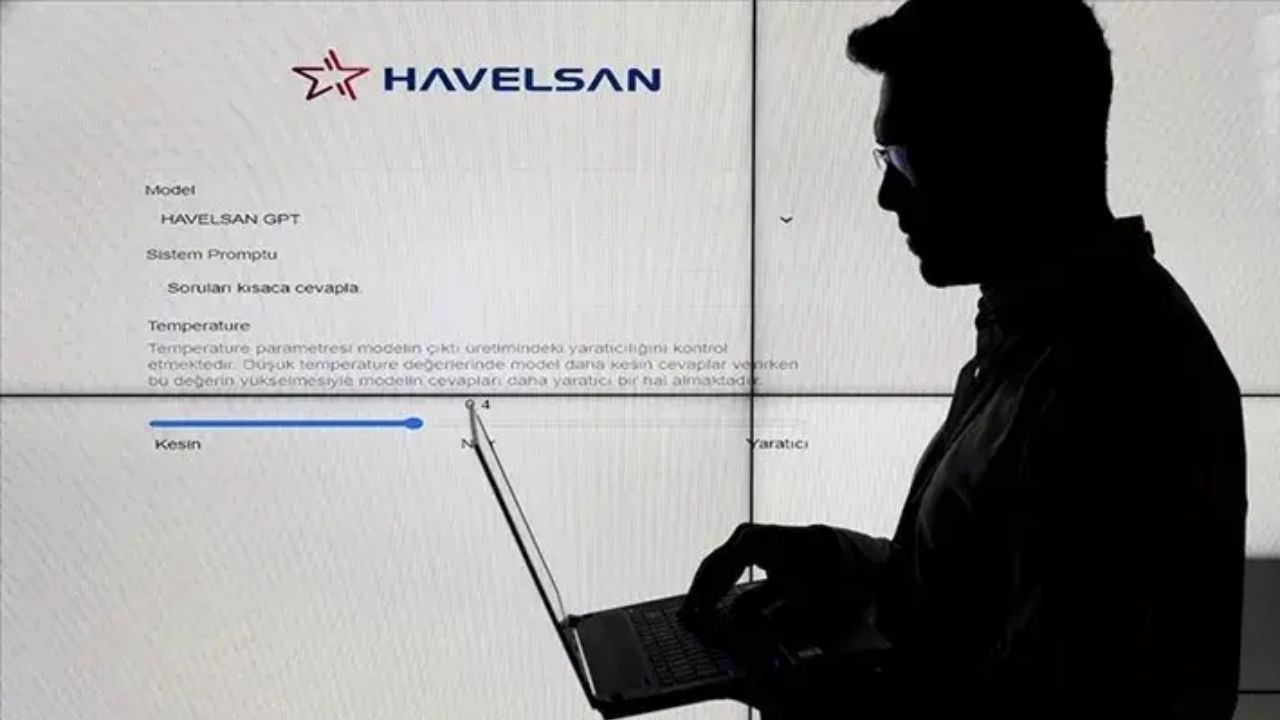
Uno de los pies más críticos de los movimientos internos de IA se lanza en la industria de defensa y la seguridad pública. Desarrollado para proteger la seguridad interna de datos y altos estándares de privacidad por HAVELSAN HASAN MAIN GPT Se destaca como una de las infraestructuras corporativas de IA que pueden funcionar fuera de Turquía.
La raíz (Multi Artificial Intelligence Network) promovida en 01.02.2024 de HAVELSAN, es una plataforma donde las instituciones pueden establecer un asistente de inteligencia artificial basado en sus datos. El circuito cerrado está diseñado para funcionar; el propósito no deja los datos fuera de la institución. En la primera etapa, las obras basadas en textos; la abstracción de contenidos puede procesar la información de código abierto y la escritura de códigos.
6. Aigency: Early Term Turkish Language Model Initiative Home
Şanlıurfa-based eCloud Software Technologies comenzó a desarrollarse en 2022 Aigencyse presenta como uno de los primeros modelos de idioma nacional en Turquía. Según las noticias de la prensa local, Meta se basa en el modelo LLaMA 3 y se centra en la producción de texto turco, el análisis de contenido y los procesos de comunicación corporativa. Todavía no se ha publicado una evaluación independiente del modelo.
Panorama general de los modelos:
Home | Desarrollador | Escala / Enfoque | Enfoque básico | Más grande |
|---|---|---|---|---|
Noticias | TUBITAK | 1B, 9B, 27B (122B is developed) | Public, Corporate, Digital Domination | 1 billón de datos crudos palabra trilyon, altyap nacional |
Kumru AI | VNGRS | 7,4B del entrenamiento de rasguños; 2B abierto | In-house (B2B) document processing, summarize |
Bajo costo del servidor, tiempo de respuesta rápida
T3 AI
T3 Foundation and Baykar
Conteo del parámetro no revelado
Community Based Turkish LLM
Conjunto de datos voluntarios, objetivo del ecosistema de código abierto
Trendyol LLM
Trendyol Tech
7B - 12B peso exterior
E-Commerce and Customer Dialogue
Directamente integrado en escenarios prácticos
HOME GPT
Home
Modelo de idioma corporativo y aislado
Defensa, Seguridad de Datos Públicos y Corporativos
Operación de circuito cerrado (en locales)
Aigency
eCloud Software
Arquitectura de idiomas de primera etapa
Text Production and Corporate Communication
Iniciativa a largo plazo centrada en la producción de texto turco
¿Por qué Importante para Desarrolladores y Empresas?
Elegir un modelo de lengua nativa no es sólo la idea de "soportamos la tecnología terrestre"; hospedando directamente las ventajas de las empresas interesadas en sus bolsillos y procesos legales:
KVKK y Seguridad de Datos:
Un dolor de cabeza grave debido a la regulación de un banco, hospital o sitio de comercio electrónico para recibir datos de usuario y enviarlo a una API en el extranjero. Los modelos locales no salen de los datos de la institución porque pueden trabajar directamente en su servidor (premise).
Menos Hardware, Más velocidad:
En lugar de cientos de miles de millones de modelos a granel, se puede ejecutar fácilmente en un solo segmento medio GPU, un modelo compacto de 7B o 14B entrenado para un trabajo específico. Es por eso que los costes del servidor y de la electricidad son muy bajos.
Break Out Dependency:
Las compañías de inteligencia artificial global pueden duplicar los precios de API por noche o traer restricciones de acceso a su negocio para detenerse. Pesos al aire libre Hugging Face modelos nativos que puedes descargar desde plataformas como, te permiten mantener tu arquitectura de software completamente en tu propio control.
Con la apertura de recursos nacionales de supercomputadora como TRUBA y la experiencia de software adquirida en la industria de defensa (ASELSAN, HAVELSAN), la producción de inteligencia artificial en Turquía se está extendiendo rápidamente a la base. Ahora el asunto no es sólo imprimir texto; crear sistemas autónomos que realmente entiendan nuestra cultura e idioma nativos. Los modelos nativos también están empujando completamente la columna vertebral de esta independencia.
Escribir el futuro con nuestro propio código
La carrera de inteligencia artificial se mide ahora no sólo con quién tiene una granja de servidores más grande, sino lo realista que toca las necesidades locales de esta tecnología. Los modelos desarrollados en Turquía; en lugar de copiar los moldes listos, se coloca en una línea que presiona muchos más pies, centrándose en resolver las sutilezas del turco, proporcionando seguridad de datos y reduciendo costos operativos de las empresas. Desde el poder corporativo de TICGE, Kumru AI y T3 AI, este punto muestra que una infraestructura tecnológica independiente que piensa y produce en su propio idioma ya no es un atractivo. Para construir el futuro con nuestros propios códigos en lugar de consumir con los algoritmos de otros, el paso más crítico que podemos saltar en la era digital.
Algunas de las empresas detrás de estos modelos Turkish AI companies that stand out in 2026 Home Tenemos en el artículo. Para detalles técnicos de Kumru Kumru AI guía personas que trabajan en modelos de idioma turco Comunidades Masqot Puedes conocerte.
AutorDario Amodei'den Yapay Zeka Uyarısı: Sektör Yalan Söyledi
Gemini Ücretli mi? Ücretsiz Sürüm ve Tüm Planlar (2026)
Artículos relacionados
Comentarios (0)
Inicia sesión para comentar.
Iniciar sesión