



Analyse de sensibilité axée sur la profondeur dans les modèles du MdE
Traduit automatiquement
 Admin
Les grands modèles linguistiques (BBD) sont essentiels au maintien des performances et de l'efficacité tout en devenant plus complexes chaque jour. Bien que les architectures de Mixture-of-Experts (MoE) fournissent cet équilibre, l'importance relative de chaque couche de MoE sur le modèle n'a pas été suffisamment comprise. En particulier dans le contexte de la compression du modèle (compression du modèle), il n'y avait pas d'analyse approfondie. Une nouvelle recherche publiée en août 2026 propose une analyse de précision détaillée basée sur la couche sur le modèle Qwen3.6-35B-A3B en comblant cette lacune et fait un pas important pour l'optimisation future des BBD.
Qu'est-ce que l'analyse de sensibilité axée sur la profondeur dans les modèles du MoE?
« L'analyse de sensibilité orientée Derinlik est une méthodologie qui examine systématiquement l'effet des différentes couches de modèles de mélange d'experts (MoE) et des experts de ces couches (experts) sur la performance globale du modèle. L'objectif est d'explorer les moyens de créer des modèles plus petits ou plus rapides sans perte de performance en déterminant quelles parties du modèle sont plus critiques. Cette analyse révèle son importance sur des structures complexes du MoE telles que Qwen3.6-35B-A3B, basées sur les valeurs de poids (magnitude) de chaque couche et spécialiste.
Architecture et principe de travail du mélange d'experts
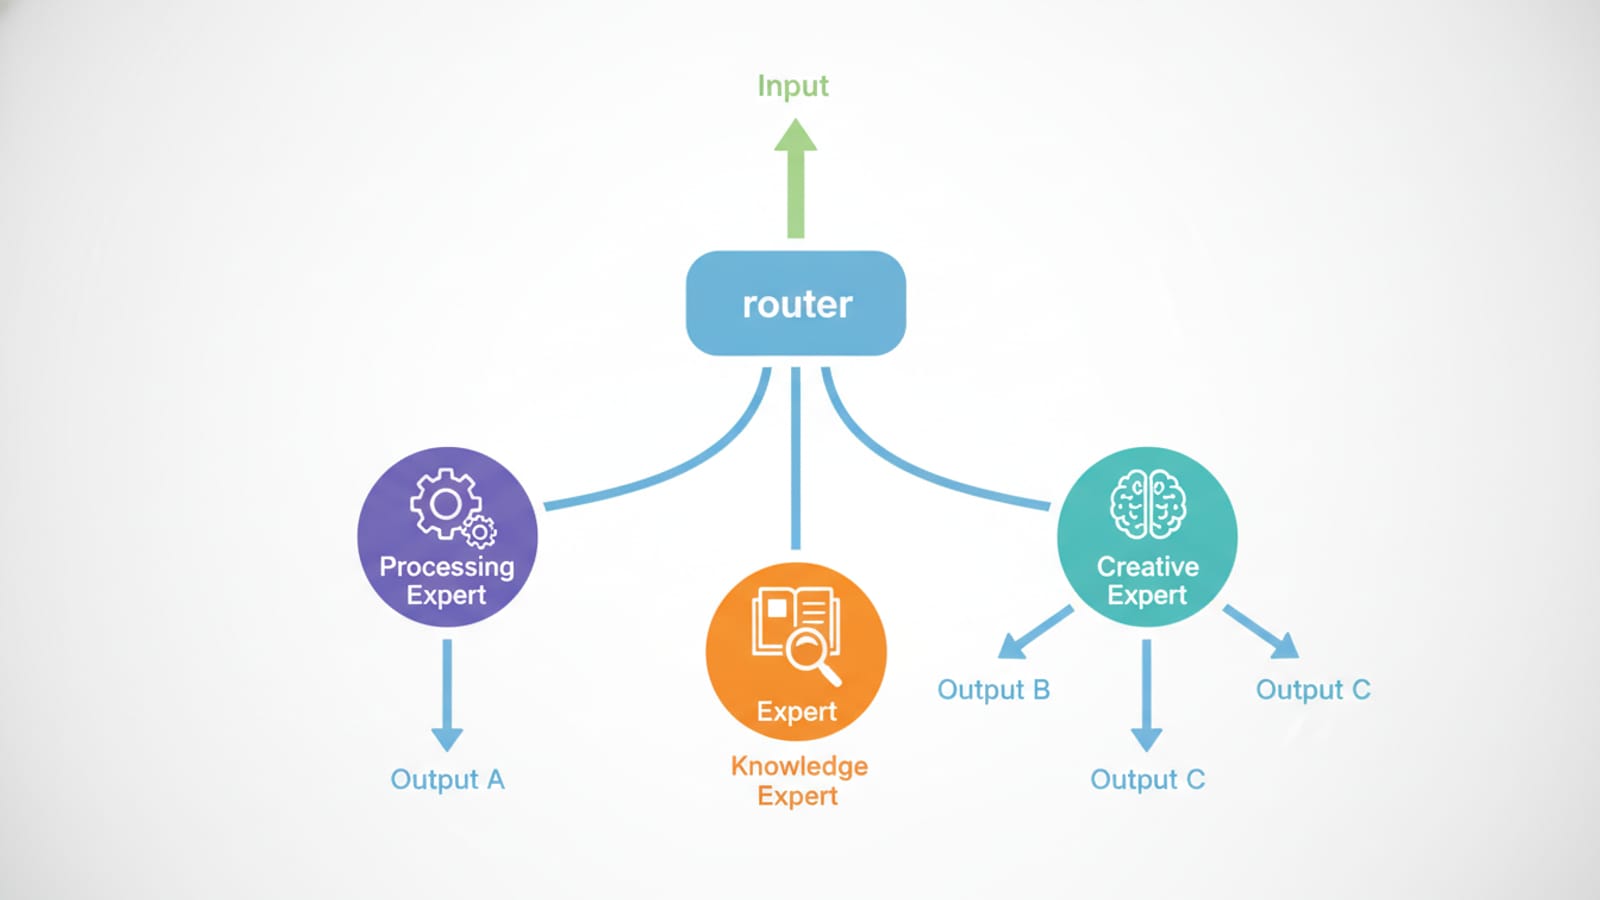
Le MdE est une structure innovante qui divise un grand modèle d'intelligence artificielle en plusieurs petits sous-réseaux spécialisés (réseaux comans). Chaque entrée (par exemple, un texte) est dirigée vers les réseaux spécialisés les plus pertinents au moyen d'un mécanisme de redirection (routeur). L'approche de cette activation rare (activation de l'espace) augmente le nombre total de paramètres du modèle, n'augmente pas le coût de calcul proportionnellement. Traditionnelle (intentionnelle) donne un coût de calcul plus faible et une formation/grainabilité plus rapide à 70% que les BBD. Par exemple, le modèle Qwen3.6-35B-A3B, 40 MoE couche, 256 experts par couche et a la structure de routage "top-8" où les 8 meilleurs experts sont sélectionnés pour chaque jeton. Les experts sont souvent spécialisés dans des tâches plus fines, comme des processus linguistiques ou des tâches significatives.
Importance de la compression dans les grands modèles linguistiques (BBD)
Aujourd'hui, les BBD présentent des talents incroyables en atteignant des milliards de paramètres. Cependant, cette taille crée des coûts élevés de calcul, d'énergie et de mémoire qui font la distribution des modèles dans les applications du monde réel. Les techniques de compression des modèles sont essentielles pour atténuer ces défis et s'assurer que les BBD fonctionnent plus efficacement avec moins de ressources. Les principales méthodes de compression comprennent:
Quantification (Quantisation) : Types de données de moindre précision (p. ex. La taille et la vitesse du modèle sont améliorées par la conversion de FP16 à INT-8.
Budama (Ébauche) : Les paramètres ou connexions moins importants dans le modèle sont définitivement supprimés. Cela réduit la complexité et l'utilisation du modèle.
Distillation d'information (Distillation de connaissances): La connaissance d'un modèle « étudiant » plus grand est assurée par compression en le transférant à un modèle « étudiant » plus petit.
Analyse de sensibilité et maskin expert basé sur la magnitude g
L'article vise à déterminer quelles couches ou experts du MoE ont le plus d'impact sur les performances du modèle pour l'analyse de précision basée sur les couches, la compression du modèle et l'optimisation des performances. Ces types d'analyses sont importants pour comprendre le fonctionnement interne du modèle et détecter les composantes les plus critiques. L'expression "Masquage d'expert basé sur la masquage" désigne une technique de démêlage ou d'analyse, qui comprend le masquage ou l'invalidation de valeurs moins importantes en évaluant l'importance des valeurs de poids en fonction de la taille des experts. Cette approche permet d'optimiser la fonctionnalité actuelle du silence dans les modèles du MoE ou de créer plus de dilution.
Contexte sectoriel: Qwen3.6-35B-A3B et utilisation du Ministère de l'environnement
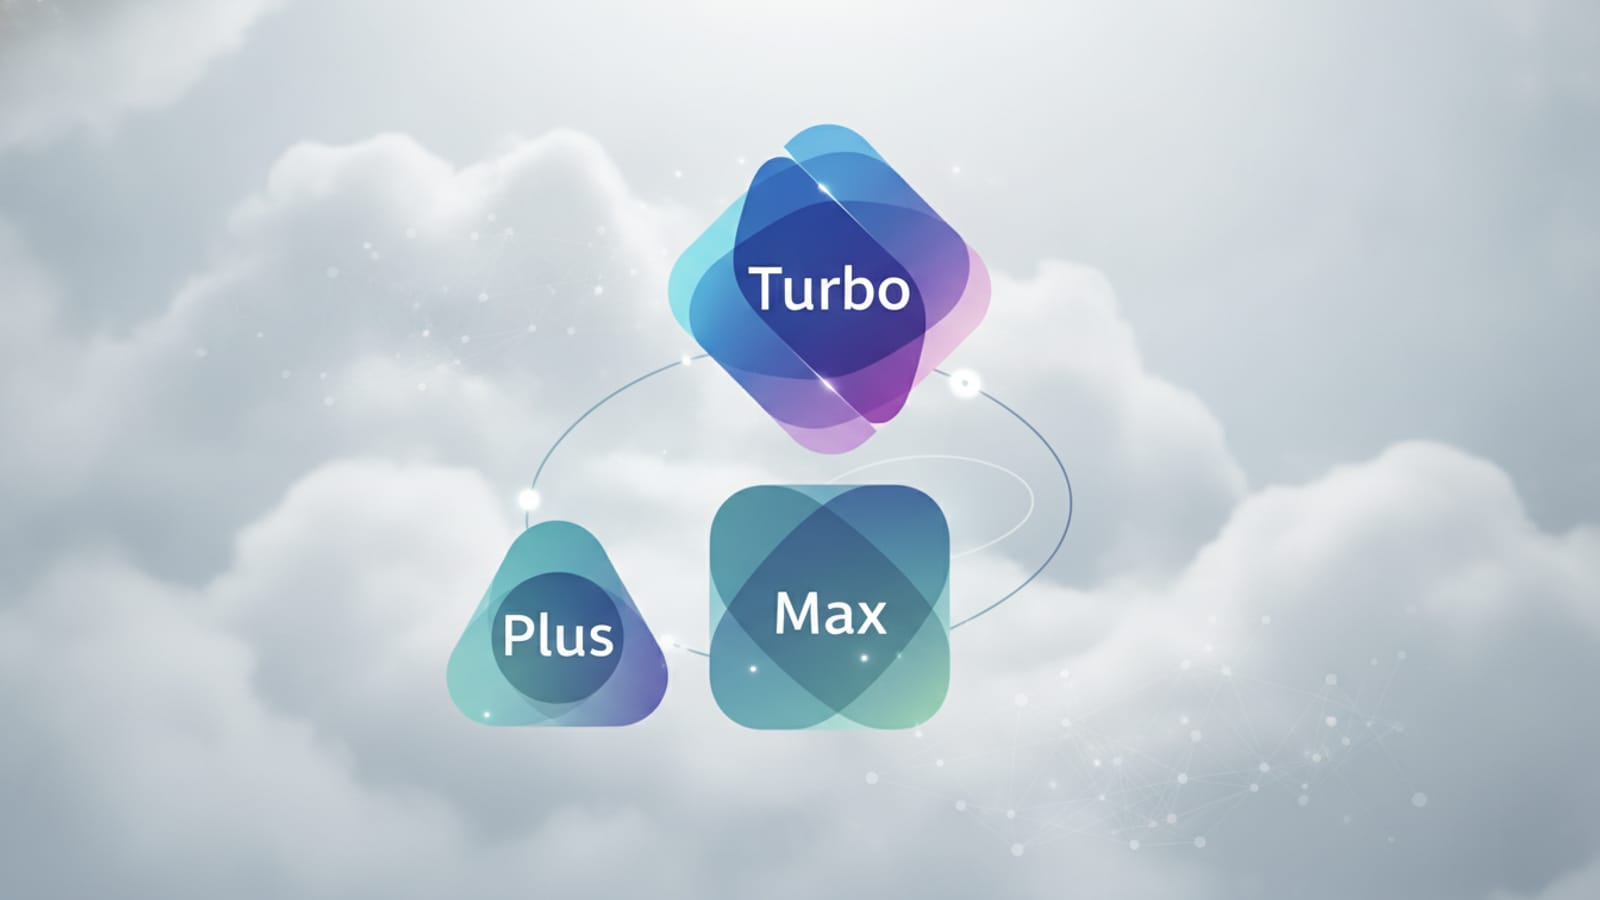
Le modèle Qwen3.6-35B-A3B, analysé par Alibaba Cloud, est un membre de la grande famille de modèles de langue de Qwen (Tongyi Qianwen). La famille Qwen est construite sur les architectures basées sur les transformateurs, et est particulièrement reconnue par ses capacités multilingues, notamment avec des performances élevées en chinois et en anglais. Cette variante avec 35 milliards de paramètres du modèle contient 40 couches MoE et 256 experts par couche. Les modèles Qwen ont différents niveaux de taille et de performance, tels que Max, Plus et Turbo. L'architecture MoE est maintenant utilisée dans des modèles leaders tels que Mistral AI Mixtral 8x7B, xAI de Grok-1, DeepSeek-V3 et Databricks.
Qu'est-ce que la Communauté
Supporteurs
Les partisans du mélange d'experts (MoE) sont mis en évidence l'efficacité de calcul et le potentiel d'évolutivité que ces structures offrent selon les modèles intensifs traditionnels. Les MoE rendent les modèles avec des trilyons encore plus gérables, offrant des temps de formation et d'exploitation plus rapides. De cette façon, une gamme plus large d'utilisation de BBD plus grands et talentueux s'ouvre.
Nouvelles
Certains experts et critiques s'intéressent à la complexité et aux subtilités des modèles du MdE. Le bon fonctionnement du mécanisme de routage (routeur) crée un défi d'ingénierie difficile pour se spécialiser efficacement dans les experts et optimiser l'ensemble du modèle. De plus, la structure rare des modèles du MoE peut conduire à une pleine efficacité dans certaines architectures matérielles.
Foire aux questions
Pourquoi les modèles du MoE sont-ils si populaires?
Les modèles MoE sont populaires surtout en raison de la capacité de créer des modèles efficaces dans le domaine des modèles de grande langue (BBD) en termes de haute performance et de calcul. Grâce à l'activation de la croix, ils permettent à des milliards de paramètres de travailler avec moins de ressources et de supprimer rapidement.
Pourquoi la compression du modèle est-elle critique pour les BBD?
La compression des modèles est essentielle pour réduire les coûts élevés de calcul, de mémoire et d'énergie des BBD énormes d'aujourd'hui. Ces techniques permettent aux modèles de travailler sur des appareils plus petits (p. ex. téléphones mobiles) et aident l'intelligence artificielle à atteindre un public plus large en réduisant les coûts de distribution.
Qwen3.6-35B-A3B Quelles caractéristiques?
Qwen3.6-35B-A3B est un excellent modèle de langue de la famille Alibaba Cloud. Cette variante avec 35 milliards de paramètres est conçue pour réussir dans des tâches particulièrement efficaces et multilingues avec des fonctionnalités telles que 40 couche Mixture-of-Experts (MoE), 256 experts par couche et "top-8 routage".
Que signifie le masquage d'expert basé sur la magnitude?
Masking expert basé sur la magnitude est moins important spécialistes temporairement ou définitivement handicapés technique, en évaluant l'importance des experts dans les modèles de MoE en fonction de la taille des valeurs de poids. Cette méthode aide à déterminer quels experts des processus de compression et d'optimisation des modèles peuvent être transmis ou priorisés.
L'avenir des grands modèles linguistiques augmente non seulement leur taille, mais aussi leur façon de les rendre plus intelligents et efficaces. L'analyse de précision axée sur la profondeur dans les modèles du MdE peut être un jalon important sur cette route. Comprendre l'apport de performance de chaque couche et spécialiste est à la recherche de nouvelles portes pour les développeurs de construire des systèmes d'IA plus agiles, plus forts et plus durables. De telles recherches offrent des informations essentielles pour accélérer l'intégration des technologies de l'intelligence artificielle dans notre vie quotidienne.
AdminABD Özel Şirketlere Siber Operasyon Yetkisi Verdi
Yapay Zeka Mühendisliği Olan Üniversiteler 2026
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter