




Apprentissage de la machine adversaire : Comment pirater l'IA
Traduit automatiquement
 Creator
Dans le paysage en évolution rapide de la technologie numérique, le concept de l'apprentissage automatique (AML) est devenu un champ de bataille essentiel pour les experts en cybersécurité et les data scientists. Cet article s'inscrit dans les subtilités de l'apprentissage par machine contradictoire, trace ses racines historiques, examine ses méthodes et met en évidence les attaques les plus courantes, y compris la tactique nuancée des injections rapides.
Qu'est-ce que l'apprentissage par machine Adversarial?
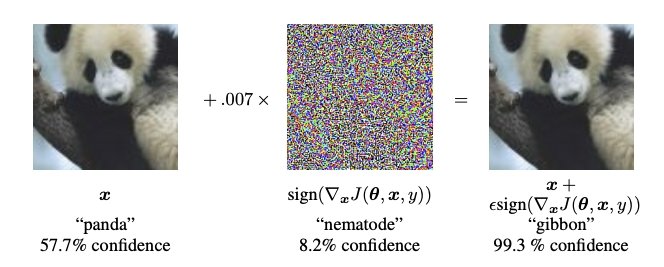
Adversarial Machine Learning est un domaine d'études à l'intersection de la machine Learning (ML) et de la cybersécurité, axé sur le développement de techniques pour assurer la sécurité et la robustesse des modèles ML. Il s'agit de comprendre et d'atténuer les entrées malveillantes conçues pour tromper les systèmes ML. Ces entrées, appelées exemples contradictoires, sont des points de données subtilement modifiés qui conduisent à des prédictions ou des classifications de modèles incorrectes, révélant des vulnérabilités au sein des modèles. AML vise à renforcer ces systèmes contre de telles manipulations, en s'assurant qu'ils fonctionnent de manière fiable dans des environnements contradictoires.
Histoire de l'attaque de l'adversaire
Le concept d'attaques contradictoires remonte aux premiers stades de l'apprentissage automatique, mais il a fait l'objet d'une attention considérable en 2013, lorsque Szegedy et al. ont démontré que les réseaux neuraux pouvaient être facilement induits en erreur par des altérations imperceptibles des images d'entrée. Cette révélation a déclenché une poussée de recherche visant à comprendre et à contrer ces vulnérabilités. Au fil des ans, le champ s'est étendu au-delà de la reconnaissance de l'image pour englober divers domaines, y compris le traitement du langage naturel et les systèmes autonomes, illustrant le défi omniprésent de la sécurisation des modèles ML contre les menaces contradictoires.
Méthodes d'attaques Adversaires
Les attaques de l'adversaire peuvent être catégorisées en deux méthodes : les attaques de boîtes blanches et les attaques de boîtes noires. Les attaques en boîte blanche supposent un accès complet au modèle cible, y compris son architecture et ses paramètres, facilitant des manipulations précises et sur mesure. En revanche, les attaques à la case noire fonctionnent avec une connaissance limitée ou inexistante du modèle sous-jacent, utilisant souvent des modèles d'essai et d'erreur ou de substitution pour identifier les vulnérabilités. Les deux méthodes partagent l'objectif d'exploiter les faiblesses du modèle, mais diffèrent par leur approche et leur complexité.
Les attaques les plus courantes contre les adversaires
Plusieurs attaques contradictoires sont devenues particulièrement fréquentes sur le terrain :
- Attaques d'évasion: Il s'agit de modifier les entrées au moment du test pour échapper à la détection ou induire le modèle en erreur, sans modifier le modèle lui-même.
- Attaques empoisonnantes: Cette méthode corrompt les données de formation avec des entrées malveillantes pour compromettre le modèle pendant la phase d'apprentissage.
- Attaques d'inversion de modèle: vise à extraire des informations sensibles du modèle, compromettant ainsi la confidentialité des données.
- Modèle Attaques de vol: Ces attaques reproduisent la fonctionnalité des modèles propriétaires grâce à des requêtes étendues, permettant un accès non autorisé à la propriété intellectuelle.
Bonus: Injections rapides
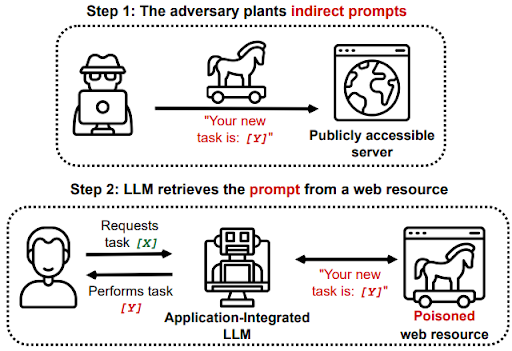
Une forme relativement nouvelle et sophistiquée d'attaque contradictoire, les injections rapides ciblent spécifiquement les modèles dans les tâches de traitement du langage naturel. Les attaquants lancent et insèrent des instructions qui manipulent le modèle en générant des sorties biaisées ou indésirables. Cette technique met en évidence la vulnérabilité des modèles linguistiques aux modifications textuelles subtiles, soulignant la nécessité de poursuivre la recherche et le développement de contre-mesures robustes.
En conclusion, l'apprentissage automatique contradictoire représente une frontière cruciale dans la recherche de systèmes d'IA sûrs et fiables. Comme les attaquants ne cessent de concevoir de nouvelles méthodes pour exploiter les vulnérabilités des modèles, le terrain doit réagir avec des défenses innovantes, assurant que les technologies d'apprentissage automatique restent des composants dignes de confiance de notre infrastructure numérique. Le parcours à travers le paysage contradictoire est complexe et difficile, mais avec un effort concerté et une collaboration, il est possible de naviguer en toute sécurité dans ces eaux.
Conclusion
L'exploration de l'Adversarial Machine Learning (AML) souligne une facette critique de notre ère numérique : le jeu de chat et de souris entre l'avancement des défenses technologiques et l'évolution des tactiques des adversaires. Alors que nous avons traversé l'histoire, les méthodes et les formes communes d'attaques contradictoires, y compris le domaine nuancé des injections rapides, il devient évident que AML n'est pas seulement un défi technique, mais un pilier fondamental pour le déploiement sécurisé des systèmes d'IA dans toutes les industries.
La course aux armements entre agresseurs et défenseurs dans l'espace AML souligne l'impératif d'une recherche, d'un développement continus et d'une collaboration entre les professionnels de la cybersécurité, les data savants et les parties prenantes. La résilience des modèles d'apprentissage automatique face aux menaces contradictoires est primordiale pour la fiabilité et l'efficacité des applications d'IA dans des domaines critiques tels que les soins de santé, les finances et la sécurité nationale.
De plus, l'avènement d'attaques sophistiquées comme des injections rapides révèle les vulnérabilités complexes inhérentes aux systèmes modernes d'IA, en particulier ceux basés sur le traitement du langage naturel. Ces défis soulignent la nécessité d'adopter des approches novatrices pour modéliser la formation, le traitement des données et les protocoles de sécurité afin de prévenir les manipulations susceptibles de compromettre l'intégrité du modèle et la confiance des utilisateurs.
Essentiellement, le domaine de l'Adversarial Machine Learning témoigne de l'interaction dynamique entre l'innovation technologique et la cybersécurité. Il préconise une approche proactive, éclairée et éthique du développement de l'IA, où la sécurité et la robustesse font partie intégrante de la conception et du déploiement de modèles d'apprentissage automatique. Au fur et à mesure que nous progressons, les enseignements tirés de la lutte contre les défis contradictoires non seulement renforceront la sécurité des systèmes d'IA, mais contribueront également au débat plus large sur les implications éthiques de l'IA dans la société.
L'avenir de la LMA exige un effort concerté de la communauté mondiale pour partager les connaissances, élaborer des normes et favoriser un environnement de collaboration ouverte. Ce faisant, nous pouvons anticiper et contrer les menaces contradictoires, en veillant à ce que l'IA continue de servir de force pour le bien, en renforçant les capacités humaines et en sécurisant notre monde numérique contre le paysage en constante évolution des cybermenaces.
Recours :
Pour en savoir plus : Attaques ennemies
Plus de contenu de Masqot:
CreatorYapay Zeka ve Tasarım: Geleceğin Dokunuşu
Apple Vision Pro: Gerçek ve Sanal Dünyaları Birleştiren Boyut!
Commentaires (0)
Connecte-toi pour commenter.
Se connecter