



Augmentation des bases de données basées sur les scanners de moteurs SQL JavaScript
Traduit automatiquement
 Auteur
Ces dernières années, les technologies Web ont connu une transformation importante du côté du traitement et de l'analyse des données. Au centre de cette transformation, JavaScript SQL Engine prend des améliorations dans les bases de données. La principale différence des moteurs SQL JavaScript est de déplacer le moteur de requête dans le navigateur. Ce moteur SQL JavaScript fonctionnant dans le navigateur commence une nouvelle période pour le monde logiciel en offrant des enquêtes de données, des analyses et des rapports sans avoir besoin du serveur.
Des outils puissants comme DuckDB-Wasm, LLM Analyse des données Accueil Combinés à des outils, les développeurs et les utilisateurs finaux offrent des environnements d'analyse accessibles, rapides et sécurisés. Ces technologies sont susceptibles de changer le processus de racine lorsque les données sont traitées dans les futures applications Web.
Que propose l'approche de base de données basée sur le navigateur?
Lorsque l'on pense aux architectures traditionnelles des bases de données, les processus de traitement des données se produisent habituellement du côté du serveur. Mais les bases de données basées sur le navigateur changent cet équilibre. En particulier, cette approche permet aux applications web modernes de devenir plus rapides, sécurisées et évolutives. Moteur SQL JavaScript Les données sont traitées directement dans le navigateur de l'utilisateur. Pour mentionner les avantages;
réduire considérablement les coûts du serveur. Récemment, d'importantes transformations se produisent en termes d'infrastructures et de coûts et visent à devenir plus pratiques pour toutes les technologies. En analysant les données en temps réel, les utilisateurs peuvent gagner du temps. Il ressemble à un travail réussi dans la vie privée des utilisateurs. Les modèles SQL basés sur le navigateur deviennent une alternative puissante pour les applications de tableau de bord, les outils de découverte de données et les systèmes de reporting interactifs.
Intégration avec les outils d'analyse de données LLM
Comme on le sait, au cours de la dernière période, l'intégration d'outils d'analyse de données avec de grands modèles de langage (LLM). Bien sûr, la contribution du développement de l'intelligence artificielle à cet égard est plus que jamais. Les moteurs SQL JavaScript créent une infrastructure idéale pour les systèmes d'analyse LLM. Dans les scénarios d'analyse de données soutenus par LLM, l'utilisateur peut poser des questions en langage naturel. LLM traduit cette question en requête SQL et peut exécuter la requête SQL du moteur instantanément dans le navigateur. Grâce à cette structure, les utilisateurs limités aux connaissances techniques peuvent effectuer des analyses sur des ensembles de données complexes, comme un ingénieur logiciel. Cette approche est d'une importance cruciale dans les applications analytiques appuyées par l'IA.
Pourquoi les bases de données basées sur le navigateur sont-elles maintenant présentées?
Lorsque nous examinons le fondement de la question causée par cette approche, quelques développements critiques apparaissent;
- WebAssembly (Wasm) Effet: Grâce à Wasm, les moteurs de base de données haute performance écrits avec C/C++ peuvent fonctionner à la vitesse native dans le navigateur. DuckDB-Wasm en est l'exemple le plus puissant.
- Augmenter la capacité de mémoire du scanner: Les navigateurs modernes sont maintenant capables de traiter des centaines de niveaux de gigaoctet ou même. Cette situation peut répondre à une charge de travail analytique importante.
- Serverz (Serverless) Tendance architecturale : Les entreprises veulent réduire les coûts de beckend (web back face). Les moteurs SQL fonctionnant sur le navigateur offrent la possibilité d'analyser le serveur sans envoyer de requêtes.
Qu'est-ce que DuckDB-Wasm et autres?
La principale différence qui met en évidence DuckDB-Wasm est la conception orientée Olap( analytique). Lorsque nous regardons le point technique, nous voyons que DuckDB peut exécuter la version Webassembly des requêtes analytiques de haute performance directement à partir du navigateur. DuckDB si nous regardons les propriétés;
- Traitement des données par colonne
- Haute performance dans les grands ensembles de données
- Haute conformité avec la norme SQL
- Travail basé sur des fichiers (parquet, support CSV)
Autres JavaScript SQL Les solutions moteur semblent souvent très adaptées aux charges de travail analytiques DuckDB-Wasm, car elles se concentrent sur des scénarios d'utilisation plus légers. Et il est développé pour les grands ensembles de données.
Amélioration des performances avec l'exécution SQL d'Async
Récemment, le tracker SQL asynchrone (async) a une importance critique dans les applications web. Des requêtes SQL durables dans l'environnement du navigateur verrouillent l'interface utilisateur si elles ne sont pas gérées correctement. Les requêtes SQL travaillant dans le navigateur ne bloquent pas les principales particules d'affaires, sont d'une grande importance en termes d'expérience utilisateur. Par conséquent, ils utilisent des approches telles que lar moteur SQL moderne, Web Worker Async/Await Promise-based Billboard. Avec Async SQL Tracker, la probabilité de l'interface utilisateur n'existe pas, l'utilisateur peut continuer à interagir avec lors de la requête, LLM peut exécuter des requêtes parallèles. Ces changements ont une importance cruciale pour l'analyse des données appuyées par l'IA. Dans ce contexte, combiner les moteurs SQL avec la structure asynchrone de JavaScript, offrant un grand avantage pour les outils d'analyse de visualisation interactive des données.
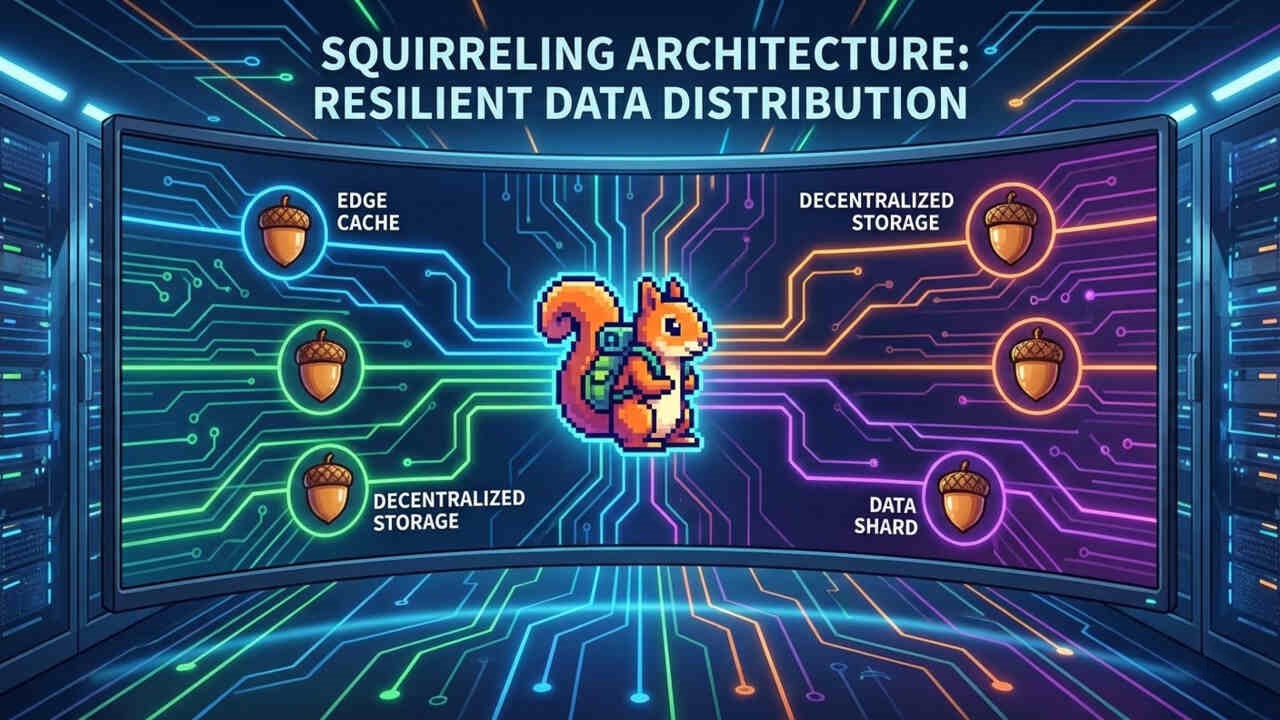
Voici le tableau de comparaison des approches Squirreling et DuckDB-Wasm pour les solutions JavaScrşpt SQL Engine;
| Titre | DuckDB | Architecture attrayante |
|---|---|---|
| Désignation des marchandises | Travail sur WebAssembly, in-browser SQL et moteur analytique | Approche de traitement avec de petites pièces sur le bord/vendeur au lieu du serveur central |
| Portée | Moteur de technologie/données u | Stratégie architecturale |
| Lieu de travail | Navigateur, Edge runtime, Node.js | Navigateur, noeud de bord, micro application |
| Objectif de base | Exécuter des requêtes SQL haute performance | Éliminer et localiser la dépendance aux données |
| Traitement des données | Colonne, analytique | Part-based, contextuel |
| Échelle | Un seul client / base de bord | Horizontal, distribué, plusieurs clients |
| Conformité des LLM | Très élevé (LLM → SQL → DuckDB) | Très haut (travaille au bord de la LLM, les données ne sortent pas du centre) |
| Travail hors ligne | Appui | Promotion de l'architecture |
| Sécurité | Mesures techniques | Sécurité naturelle car les données ne sortent pas |
| Rendement | Près des Autochtones | Performances liées aux moteurs d'occasion |
| Flexibilité | Limité avec des formats SQL et de données | Moteur indépendant (DuckDB, SQLite, moteur JS, etc.) |
Utilisation de l'écurie dans le déploiement des bords
Diminue la dépendance au serveur central dans les scénarios de déploiement Edge. Les données sont traitées dans le navigateur de l'utilisateur ou traitées dans l'exécution sans service. Squirreling convient à ces environnements car il ne nécessite pas de transfert de données important, seules les données requises sont conservées localement. Les requêtes SQL sont exécutées par edge. Par conséquent, ce modèle réduit la latence, minimise le coût de bande passante et augmente la confidentialité.
Auteur2026 Yapay Zeka İstihdam Programları ve Kariyer Rehberi
Güney Kore Yapay Zeka Yasası Yürürlüğe Girdi: İşte Detaylar
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter