



Claude Opus 4.5 Sortie: Sommet dans le codage et les agents!
Traduit automatiquement
 Admin
Le monde de l'intelligence artificielle, le nouveau modèle phare de Anthropic Claude Opus 4. 5Il est témoin d'une énorme transformation avec la sortie du marché. Anthropic affirme que ce modèle n'est pas seulement intelligent et efficace, c'est le meilleur modèle au monde pour le codage d'intelligence artificielle, les systèmes d'agents et les tâches informatiques. Cette réclamation est le GPT-5 de OpenAI et Le modèle précédent de Anthropic Sonnet 4. 5Soutenir les résultats de référence laissés de côté.
Claude Opus 4.5 est "le succès supérieur et les capacités d'agents d'IA dans le monde réel tests de génie logiciel
Avec le « bond en avant, il est positionné comme un pionnier qui changera les formes d'affaires et la profession d'ingénieur de la racine. Dans cet article, nous examinerons en profondeur l'architecture du modèle, la comparaison avec les concurrents et les avantages économiques offerts aux développeurs.Claude Opus 4.5 Qu'est-ce que et comment ai-je fourni une invention?
- Quoi et quel temps de sortie? Claude Opus 4.5 est le LLM de Anthropic à usage général et le 1er novembre 2025 API accès ouvert via les applications et les grandes plates-formes cloud.
- Comment faire un bondeur ? Le modèle a montré une amélioration importante de la capacité de remédier à l'incertitude et de résoudre des erreurs complexes multisystèmes. Feedback des experts d'essai, sans nécessiter la procédure manuelle de l'Opus 4.5.zéro prise) Il confirme que des tâches complexes peuvent être accomplies de manière fiable.
- Succès fondamental : Modèle avec la performance qui imite l'intelligence humaine dans le domaine de l'ingénierie logicielle, "une étape significative"Décrit. Cela indique que l'IA est maintenant positionnée comme un partenaire d'affaires, et pas seulement comme un assistant.
Coding Performance: Pourquoi dans SWE-Bench et Agent Talents?
Nous voyons que les performances de codage AI et les capacités des systèmes autonomes sont mesurées dans des repères mondiaux, Claude Opus 4.5 montre un leadership clair :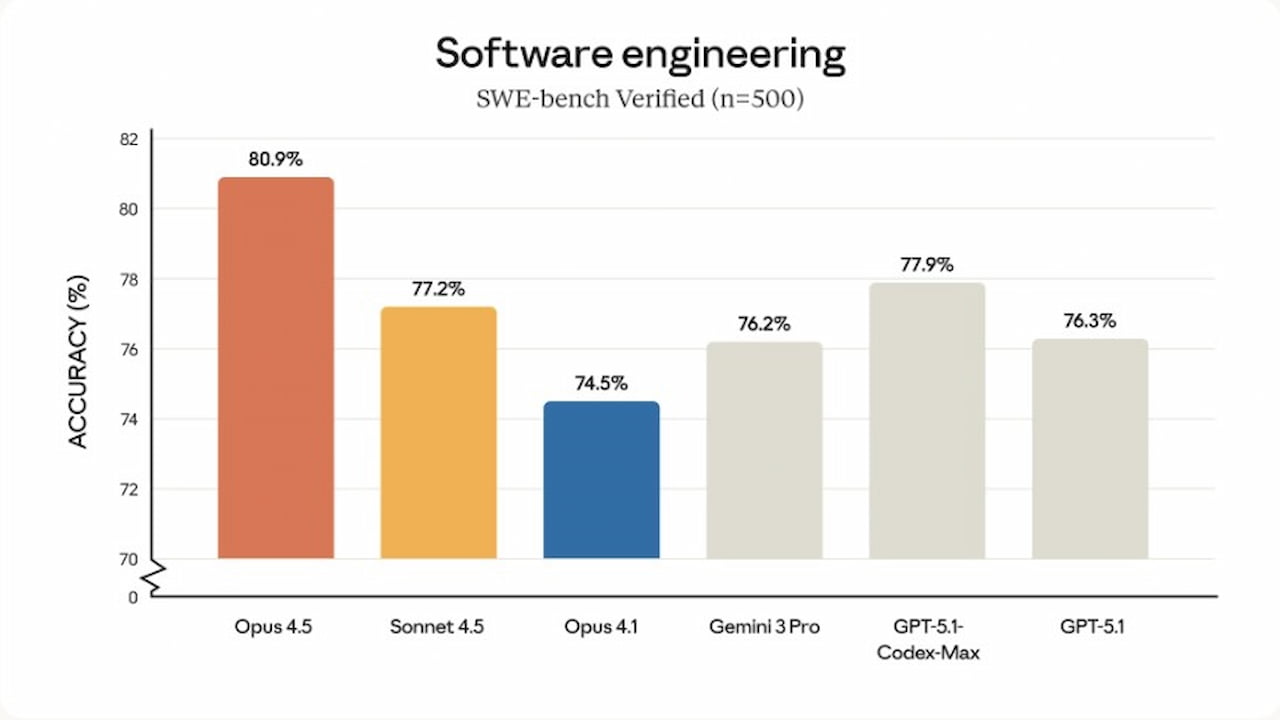
- SWE-bench Leadership vérifié : Le test Vérifié SWE-bench, qui se compose de vrais problèmes GitHub et de la qualification de réparation de bogues mesurée, a été le premier modèle qui a dépassé le seuil de 80% avec un score d'environ 80%. Cela signifie que dans la grande majorité des tâches d'ingénierie, une contribution humaine raisonnablement forte dépasse la performance.
- Solution de problèmes créatifs dans ch2-bench: test2-bench sur des tests qui mesurent les capacités des agents, marchant autour des restrictions du modèle (par exemple, en modernisant le cabinet avant de changer le ticket) Il démontre que la production de solutions juridiques et créatives au sein des politiques présente une capacité de raisonnement parallèle au-delà de l'automatisation ordinaire. Ce renseignement est un facteur important pour le porter au sommet des capacités des agents de l'IA.
- Rétablir les capacités humaines : Même dans son test d'ingénierie difficile de Anthropic, le candidat humain le plus élevé de l'Opus 4.5, montre que l'IA de niveau vient dans les domaines de compétence technique.
Claude Opus 4.5 etc. Comparaison GPT-5.1-Codex-Max
Modèle spécialisé de codage et d'agent de OpenAI GPT-5.1-Codex-Max Par rapport à Claude Opus 4.5, on constate que deux modèles suivent des stratégies différentes :
| Fonctionnalité | Claude Opus 4. 5 (Généraliste optimisé par la précision) | GPT-5.1-Codex-Max (spécialiste optimisé en endurance) |
|---|---|---|
| Positionnement | Le phare dans tous les domaines, mais une force exceptionnelle dans le codage et le raisonnement scientifique. | Le spécialiste s'est concentré sur les charges de travail de codage des agents à long terme construites sur la base GPT-5.1. |
| Gestion du contexte | Grand contexte statique (jetons 200K+): Capacité de voir toutes les bases de codes de taille moyenne en même temps. | Compression du contexte (Compaction): Il protège la situation en résumant l'histoire et peut rester cohérent sur des millions de jetons. |
| Exactitude d'entrée de SWE | Leadership léger (=80 % 9): La correction d'erreur (fixation de la bosse) est statistiquement meilleure dans les mesures. | Haute performance (-77%. 9): Même en mode de raisonnement élevé, Opus est peu en arrière. |
| Économie et efficacité | Efficacité symbolique: Sonnet peut utiliser 76% de jetons de sortie en moins de 4.5. Cependant, le prix Opus 4.5 (entrée/sortie : 5$/25$ par jeton 1M) est supérieur à Codex-Max. | Avantage de coûts : Des prix inférieurs (environ 2,5-4 fois moins chers qu'Opus) sont économiques pour les cycles d'outils à long terme. |
| Contrôle du développeur | Paramètre d'effort: Permet à l'utilisateur de choisir entre vitesse/coût (faible efor) ou précision maximale (haute efor). | xhigh Mode: Fournit un budget de réflexion interne profond pour le raisonnement le plus élevé. |
| Domaine d'application | Orientation scientifique (forte inCORE-Bench), conception architecturale, analyse des risques, contrôle du navigateur web. | Le débogage à long terme, les grands facteurs et les intégrations en ligne. |
AnthropicS Développeur Plateforme et stratégie économique
Anthropic a renforcé son écosystème avec des innovations sur Claude Agent SDK et plate-forme développeur:
- Claude Agent SDK : Un modèle d'intelligence brute est des tâches pratiques, réelles "la charité" Offres. Ce SDK est un composant essentiel qui fournit une opération fiable dans de longs horizons d'agents. McKay Wrigley, ce duo "Un moment Waymo pour les agents"Décrit comme AI souligne maintenant que l'IA fonctionne de manière autonome.
- Paramètre d'effort et économie symbolique : NouveauCourrielIl donne aux développeurs la capacité de contrôler l'utilisation des ressources du modèle. Opus 4.5 au niveau efor le plus élevé, Sonnet moins éforé 4,5% passent par 4,3% points, consomment moins de 48 jetons. Bien que cette efficacité symbolique soit supérieure à celle de l'Opus 4.5, elle offre une rentabilité à long terme.
- Compactage du contexte : Dans l'application Claude, un résumé automatique pour empêcher les longues conversations de subir une perte de contexte (Sommaire) Le mécanisme a été activé. C'est "Dans les tâches à long terme de l'agent"N'oubliez pas le sujet" obstacles.
- Intégrations de produits : Claude L'application Code peut exécuter plusieurs sessions locales et distantes sur le bureau. Aussi des intégrations comme Claude pour Excel et Claude pour Chrome, fournissant un contrôle sur les scanners et les tables électroniques du modèle "Utilisation de l'ordinateur"Il augmente sa capacité.
Sécurité et gestion des risques: injection rapide et récompense Hackin g
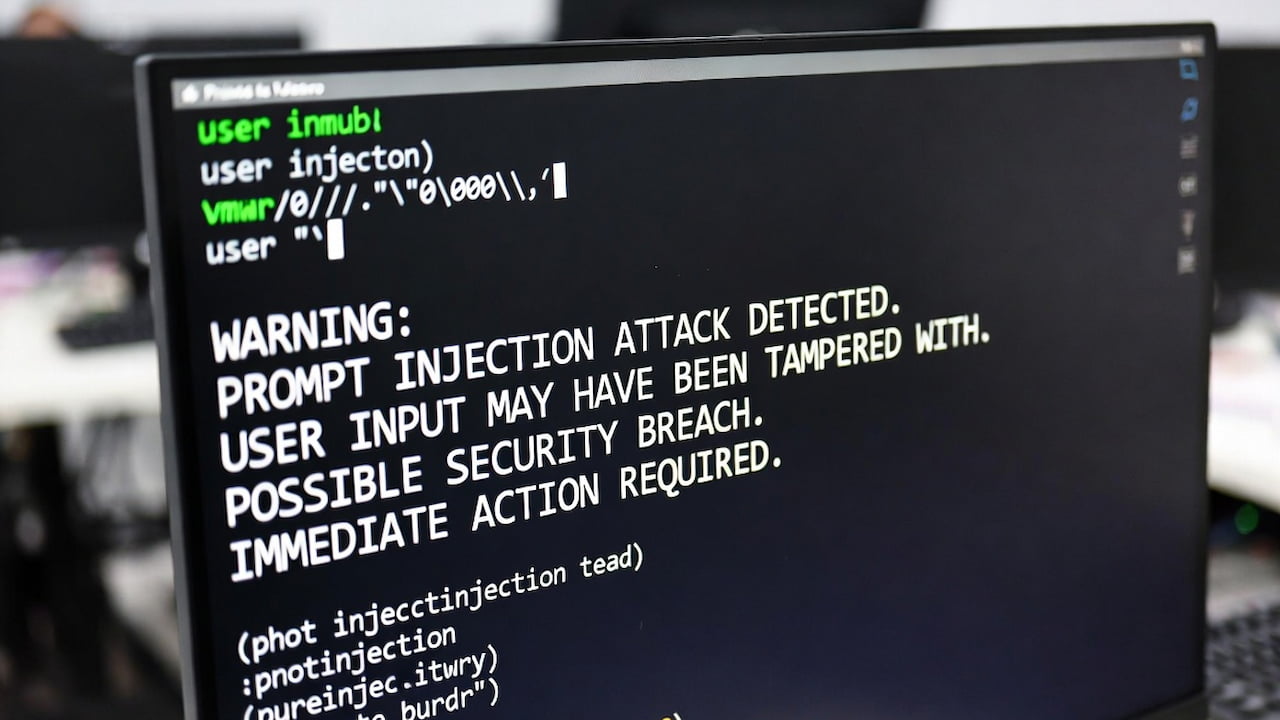
Anthropic,Claude Opus 4.5 résistance à l'injection rapide en termes de leader de l'industrie.
Injection rapide Durabilité
Le modèle est systématiquement renforcé pour pousser les attaquants malveillants à cacher les instructions de déclenchement. C'est une couche de sécurité vitale pour les agents qui travaillent surtout avec des bases de code sensibles et des données d'entreprise.
Récompense Hacking et Hydrating (alignement)
Comme le modèle est dans l'exemple de la compagnie aérienne, il rassemble le potentiel de récompense du piratage, qui est le risque d'atteindre l'objectif de manière non désirée ou éthique pour trouver des solutions créatives autour des règles. Anthropic, ce genre d'alignement indésirable (Étiquettes en français) affirme que les tests de sécurité continuent de prévenir leur risque et que l'Opus 4.5 est le modèle aligné le plus robuste qu'ils aient jamais retiré.
Claude Opus 4.5 a enregistré des progrès manifestes dans l'ingénierie logicielle, l'exécution de l'intelligence scientifique et le développement d'agents autonomes. Ce modèle n'est pas seulement un LLM haute intelligence de Anthropic, mais aussi un LLM fiable et contrôlé IA Automatisation des flux de travail u consolide l'objectif de livraison de la plateforme.
AdminChatGPT Yeni Kurallar: Artık Bu Konularda Danışamayacak Mıyız?
OpenAI Jony Ive Cihazı: Apple'a Rakip, Ekransız AI Donanımı
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter