



Comparaison des formats de données LLM : Quel est le meilleur pour l'intelligence artificielle ?
Traduit automatiquement
 Admin
Grands modèles linguistiques (LLM) Lorsqu'on discute de la fiabilité des systèmes d'exploitation, on se concentre habituellement sur le nombre de paramètres ou de données de formation du modèle. Mais le plus souvent, il y a un détail technique très basique qui ignore : quel format nous offrons des données au modèle ? La comparaison des formats de données LLM est un élément essentiel qui non seulement répond aux « intelligents » d'un système d'intelligence artificielle, mais détermine aussi directement les coûts opérationnels.
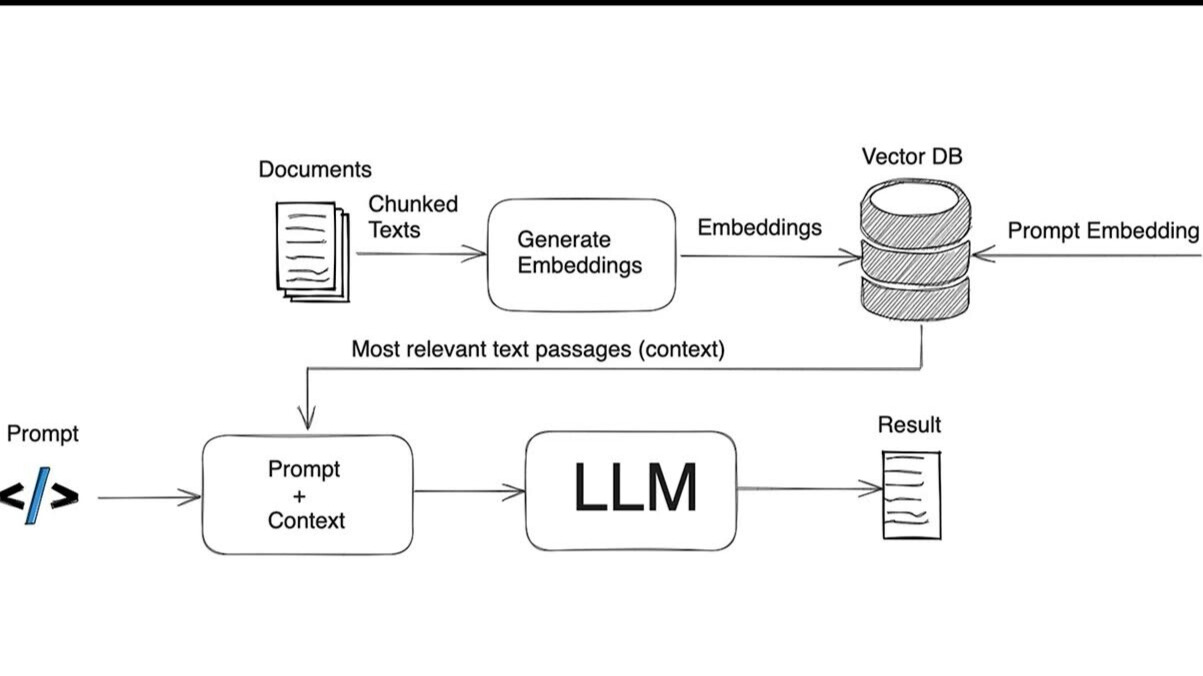
En particulier dans les processus d'optimisation des pipelines RAG, les tableaux ou les données hiérarchiques (JSON, CSV, Markdown, etc.) La méthode de transfert au modèle influe sur le succès global du système. Le choix d'un mauvais format peut réduire la proportion de l'exactitude des données d'intelligence artificielle en raison d'une interprétation incorrecte du modèle ou d'un niveau élevé Coût du jeton LLM avec votre budget. Dans cet examen approfondi, nous analysons la performance de différents formats de données avec des données techniques et des résultats de référence.
Quel format préfère les tableaux LLM moyens?
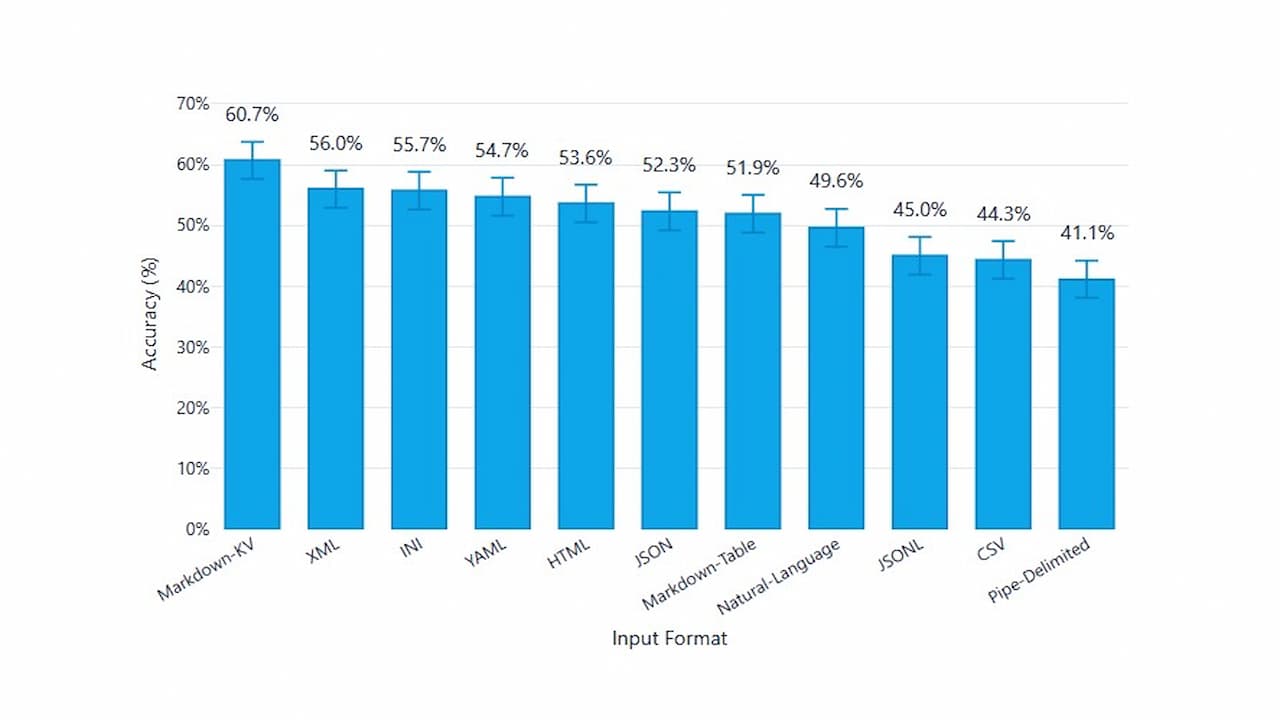
1.000 questions différentes sur les modèles d'intelligence artificielle via 1 000 ensembles de données enregistrés expériences contrôléesrévèle l'effet spectaculaire de la sélection des formats sur la précision du système.
- Format Markdown-KV (valeur clé) : Lors des essais, 60,7 % de la précision ont été atteints. Clé de chaque enregistrement plutôt que des tableaux classiques : cette structure qui offre des paires de valeurs facilite l'établissement de la relation entre les données par le modèle.
- XML et INI : Il suit Markdown-KV avec des taux de précision d'environ 56%. Mais le coût du XML est assez élevé.
- CSV et JSONL Performance: Étonnamment, la performance de CSV JSONL la plus utilisée en science des données est restée assez faible. CSV 44,3%, JSONL restent à 45% de précision. Cela indique que les LLM sont obligés de sentir des données brutes séparées par des virgules.
Quel est le meilleur format dans les données de Havarcy (internes)?
Les systèmes d'IA modernes sont généralement nécessaires pour traiter des données internes telles que les réponses aux API ou les fichiers de configuration. La comparaison des formats de données LLM offre des résultats variables selon le modèle.
- YAML- Responsable de l'exactitude : Modèles GPT-5 Nano et Gemini 2.5 Flash Lite Sommaire a montré la performance la plus élevée. La hiérarchie visuelle basée sur l'entrée fournit les structures complexes du modèle "voir".
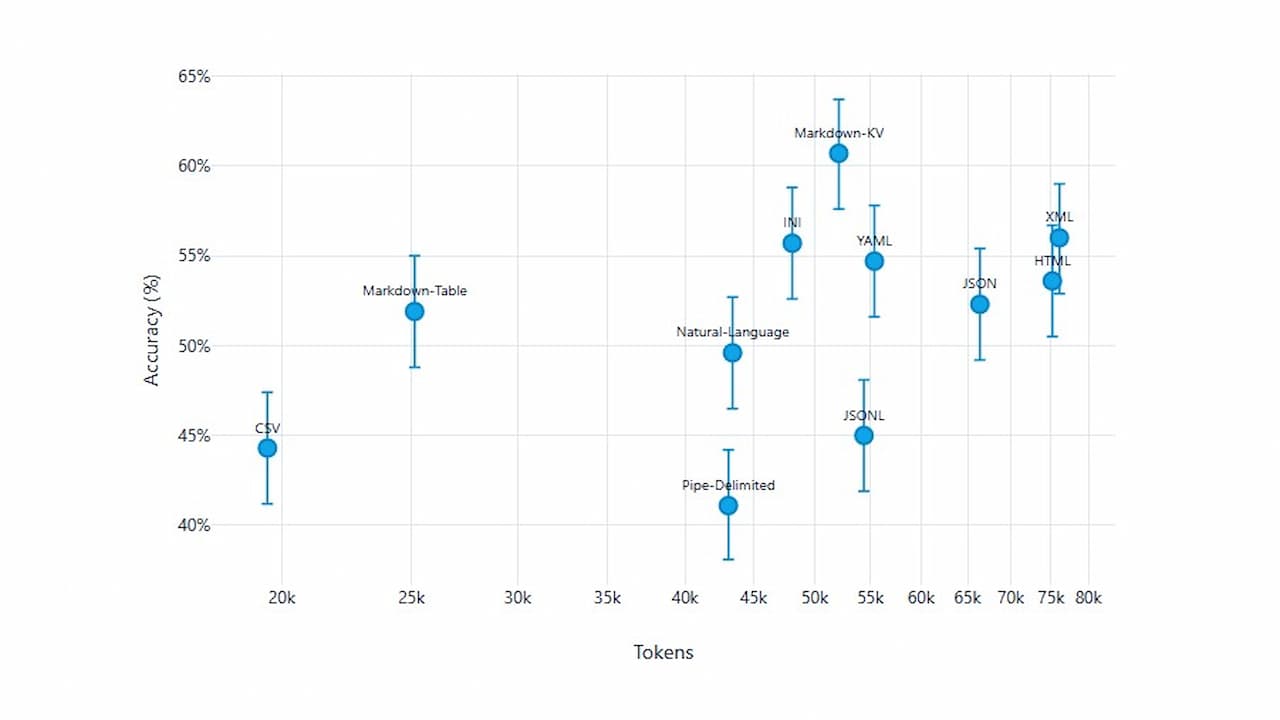
- Marquage- Champion des coûts : Markdown a été le format le plus efficace dans tous les modèles. 34-38% de JSON consomment environ 10% de jetons de moins de YAML. Idéal pour ceux qui veulent minimiser le coût tout en maintenant la précision requise.
- La pauvreté de JSON : Malgré une utilisation généralisée JSONa présenté des performances inférieures à celles attendues dans les modèles GPT-5 et Gemini. Seul Llama 3.2 a donné des résultats acceptables pour JSON car la précision du format est faible dans le modèle 3B Instruct.
- Combien à partir de XML : XML a la consommation de jeton la plus élevée et ses taux de précision sont généralement inclus dans la dernière ligne. Les structures répétées de l'étiquette () peuvent distribuer le mécanisme d'attention du modèle (attention).
Comment la sélection des formats affecte-t-elle l'exactitude des pipelines du RAG?
- Qu'est - ce qui est affecté? La précision d'un système RAG (Retrieval-Augmented Generation) dépend de la façon de transmettre les informations reçues au modèle. Le mauvais format conduit le modèle à des rapports erronés, basés sur « la moitié ».
- Pourquoi important ? Une réduction de 10 % du taux d'exactitude des données sur l'intelligence artificielle peut signifier un désastre pour le robot de service à la clientèle ou un outil d'analyse financière.
Solde des coûts et des résultats
La consommation symbolique de formats de données est un coût d'exploitation direct. Par exemple, le format XML nécessite 80% de jetons de plus que Markdown. Cela signifie que vous payez presque deux fois d'argent pour traiter les mêmes données.
Matrice des matériaux de performance :
- Priorité de précision (haut budget): Markdown-KV (pour les feuilles), YAML (pour les données imbriquées).
- Solde Priorité : Tables de marquage.
- Priorité à faible coût (faible exactitude) : CSV ou JSONL.
Recommandations stratégiques
Selon les résultats de la comparaison des formats de données LLM, l'utilisation de CSV ou JSON peut limiter le potentiel de votre système. Il est recommandé de suivre ces étapes tout en maintenant la profondeur technique :
- Si les données de la table sont utilisées intensivement dans votre système, ajoutez une couche intermédiaire qui convertit les données au format Markdown-KV avant de les envoyer au modèle.
- Standardisez le format YAML pour les fichiers ou catalogues de configuration complexes.
- Votre modèle (GPT, Llama, Gemini, etc.) Faites des tests de référence à petite échelle avec votre propre ensemble de données pour déterminer quel format est plus sensible.
- Télécharger un minimum d'utilisation XML pour éviter les gaspillages inutiles.
Sommaire "à droite" il n'y a pas de format, mais selon vos objectifs "optimiser" modèle. Si la précision est critique, YAML et Markdown-KV sont les normes les plus fortes du monde de l'IA pour 2025 et plus tard, si le coût est critique. Le succès du système dépend non seulement de la présence des données, mais le modèle les consomme sous la forme la plus pure et la plus compréhensible.
AdminOdyssey-2 AI Video: Anında Etkileşimli Videolar Yarat
2025’in Öne Çıkan Yapay Zeka Araçları
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter