



DeepSeek V3.1 Quel est le modèle d'intelligence artificielle soudée ouverte?
Traduit automatiquement
Initiative d'intelligence artificielle basée en Chine DeepSeekLe nouveau modèle au 21 août 2025 a annoncé DeepSeek V3.1. Ce modèle d'intelligence artificielle open source, qui attire l'attention avec son architecture hybride, sa capacité contextuelle de 128K et son accès à l'API à faible coût, est non seulement dans le domaine de la technologie, mais aussi dans l'économie mondiale et l'environnement d'innovation.
DeepSeek V3.1 Quoi ?
DeepSeek V3. 1 Il s'agit du nouveau modèle linguistique développé par DeepSeek à partir d'initiatives croissantes d'intelligence artificielle en Chine et publié comme un modèle d'intelligence artificielle open source. La phrase « source ouverte » signifie ici que le code, les paramètres et les lignes directrices d'utilisation du modèle sont ouverts à tous. Cette situation démocratise les processus de développement de l'intelligence artificielle, ce qui signifie que non seulement les grandes entreprises technologiques, les universités, les chercheurs indépendants et les petites initiatives peuvent également utiliser cette technologie.
DeepSeek V3.1 est un énorme modèle d'intelligence artificielle avec 671 milliards de paramètres. Le paramètre est le nom donné aux variables définies dans le processus d'apprentissage de l'intelligence artificielle. Comme le nombre de paramètres d'un modèle augmente la capacité d'apprendre des relations plus complexes. Cependant, DeepSeek n'utilise que 37 milliards d'actifs au lieu d'exécuter tous ces paramètres simultanément. Cette méthode est connue sous le nom de Mixture of Experts (MoE) dans la littérature de l'intelligence artificielle.
Dans l'architecture du MoE, différents réseaux spécialisés sont activés dans certaines tâches. Ce modèle fonctionne à la fois plus rapidement et plus efficacement. Par exemple, lorsqu'un utilisateur demande une question de programmation, seul le spécialiste du codage est activé; le spécialiste du langage et de l'été travaille quand vient la question de littérature. Cette structure permet d'effectuer des performances similaires ou supérieures à celles des concurrents DeepSeek V3.1.
DeepSeek V3.1 Caractéristiques
DeepSeek V3.1 est non seulement open source parce qu'il est un modèle qui attire l'attention dans le monde de l'intelligence artificielle, mais a également des caractéristiques techniques innovantes. De nombreux détails allant de l'architecture modèle à la fenêtre contextuelle sont conçus pour répondre à différents besoins.
Une des caractéristiques les plus parlées du système de mode hybride DeepSeek V3.1. Le modèle a deux modes de travail différents:
Mode réflexion (mode chute): Le modèle passe par le processus de pensée interne avant de résoudre une question complexe. Cela signifie les étapes logiques pour simuler l'esprit avant de produire la réponse de l'IA. Le mode de pensée est plus lent, mais produit des réponses plus profondes et cohérentes.
Mode non réfléchi (mode de réponse prévu): Modèle produit une réponse rapide directement. Ce mode est préféré dans les questions plus superficielles ou les conversations quotidiennes. Cette fonctionnalité offre aux utilisateurs une grande flexibilité. Par exemple, un développeur de logiciel peut choisir le mode "penser" pour un problème de débogage complexe, une entreprise qui a mis en place le chatbot de support client peut répondre rapidement en choisissant le mode "non-penser".
Une autre caractéristique du modèle est la méthode MoE – Mixture of Experts (Experts Mix). Dans ce système, il existe de nombreux sous-modèles spécialisés dans différentes matières. Lorsque l'utilisateur donne une commande, le modèle n'active que les éléments nécessaires de ces sous-modèles. Cette approche présente deux avantages importants:
Aucune puissance de traitement inutile n'est dépensée, de sorte que le coût est réduit.
Grâce à la combinaison de modèles spécialisés, le taux de précision des réponses augmente.
DeepSeek V3.1, en particulier en tant que LLM (modèle grand langage) NLP (traitement des langues naturelles) fort sur le terrain. Cela signifie que le modèle a la capacité de comprendre, produire et convertir le langage humain. Les utilisateurs peuvent utiliser DeepSeek dans de nombreux domaines différents, tels que l'abstraction de texte, la traduction, la question-cevap, l'analyse de sentiment ou l'écriture de code. Le soutien particulièrement multilingue est un avantage important pour différents groupes d'utilisateurs à l'échelle mondiale.
DeepSeek V3.1, önceki versiyonlara göre çok daha büyük bir eğitim sürecinden geçti. 32K bağlam penceresi eğitimi: 630 milyar token (kelime parçacığı) üzerinde çalıştırıldı. Bu, V3 sürümünden 10 kat daha fazla eğitim verisi anlamına geliyor.
128K bağlam penceresi eğitimi: 209 milyar token ile eğitildi. Bu da önceki sürümlere göre 3,3 kat daha fazla. “Bağlam penceresi (context window)”, modelin aynı anda hatırlayabildiği metin uzunluğunu ifade ediyor. 128K bağlam desteği, yaklaşık 400 sayfalık bir kitabı aynı anda analiz etmesini sağlıyor. Bu, hukuk, akademi, tıp ve yazılım gibi çok uzun metinlerin işlendiği alanlarda ciddi bir avantaj.
DeepSeek V3.1, sahip olduğu hibrit yapı ve MoE sistemi sayesinde rakiplerine kıyasla çok daha düşük maliyetle çalışır. Çin merkezli bağımsız testlere göre model, bazı rakiplerine kıyasla 40 kata kadar daha ucuz işlem maliyetleri sunmaktadır. Bu durum, özellikle küçük ölçekli şirketler veya bireysel geliştiriciler için büyük bir erişilebilirlik avantajı yaratır.
DeepSeek V3.1 Güncellemesi: Terminus Versiyonu
DeepSeek, Eylül 2025’te V3.1 modelini “DeepSeek V3.1-Terminus” adıyla güncelleyerek modelin performansını ve stabilitesini artırmaya yönelik önemli iyileştirmeler sundu. Bu güncelleme, tamamen yeni bir modelden ziyade, mevcut V3.1 mimarisinin optimize edilmiş bir versiyonu olarak öne çıkmaktadır.
Terminus sürümü ile birlikte modelin özellikle dil işleme ve çıktı üretim kalitesinde dikkat çekici gelişmeler sağlanmıştır. Önceki sürümlerde zaman zaman karşılaşılan dil karışıklıkları ve tutarsız ifadeler büyük ölçüde giderilmiş, modelin daha akıcı ve doğru metinler üretmesi sağlanmıştır.
Güncellemenin bir diğer önemli yönü ise agent (ajan) yeteneklerindeki gelişmelerdir. Özellikle kod üretimi ve bilgi arama süreçlerinde kullanılan sistemlerde performans artışı gözlemlenmiştir. Bu durum, DeepSeek V3.1’in yalnızca bir metin üretim aracı değil, aynı zamanda daha gelişmiş görevleri yerine getirebilen bir yapay zeka sistemi haline geldiğini göstermektedir.
Également avec la version terminus, la stabilité globale du modèle est augmentée, des sorties plus cohérentes et plus fiables sont produites. Ces améliorations augmentent considérablement les préférences de DeepSeek dans les environnements d'utilisation et de production des entreprises.
Bref, la mise à jour DeepSeek V3.1-Therminus offre un développement important en termes de performance, de précision et de fiabilité d'utilisation sans changer la base technique du modèle.
DeepSeek V3.1 Utilisations du modèle d'intelligence artificielle Open Source
Développement logiciel: écriture de code, débogage, description d'algorithme. |
Études universitaires : L'article résume, analyse documentaire, préparation de thèses. |
Production du contenu : Nouvelle écriture, création de scénarios, histoires créatives. |
Intégrations d'entreprise: chatbots d'assistance à la clientèle, automatisation des processus d'affaires. |
Recherche : Grandes analyses de données, recherche bio-informatique, recherche en sciences sociales. |
Bref, DeepSeek V3.1 est non seulement pour les passionnés de technologie, mais aussi un outil puissant pour les solutions industrielles et la recherche académique.
DeepSeek V3.1 Tarifs et plans
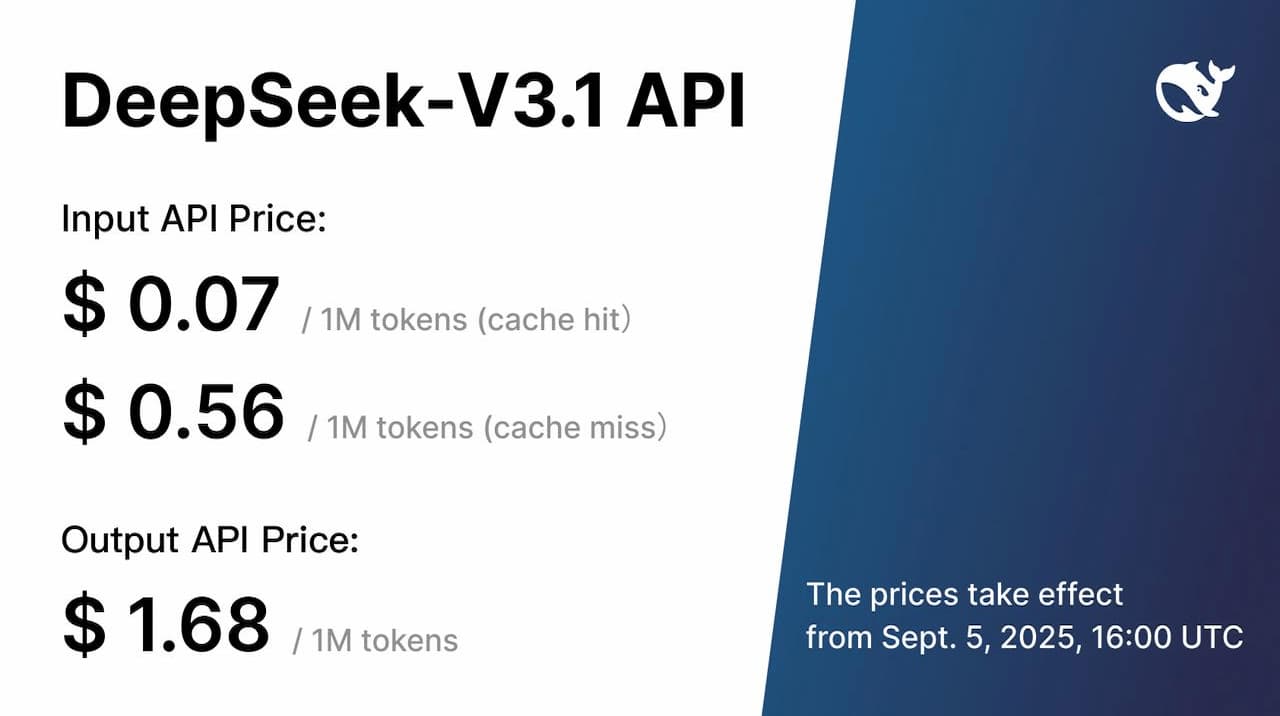
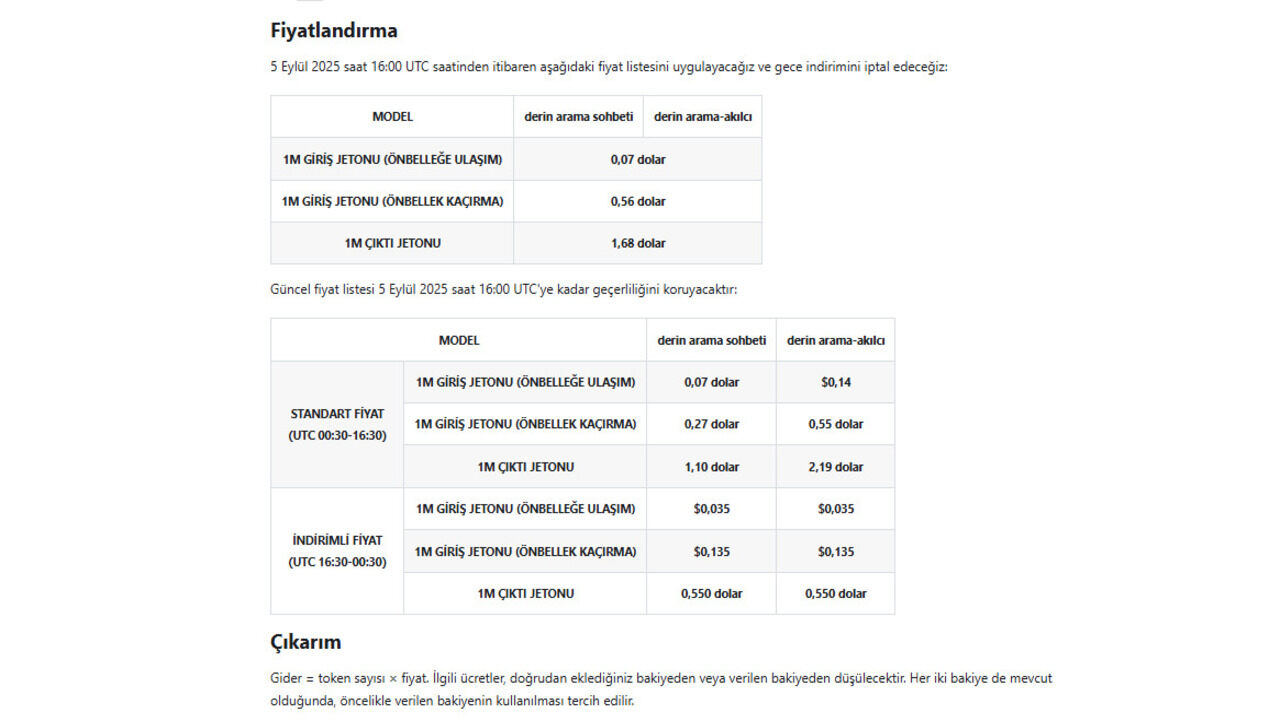
DeepSeek V3.1 offre un système de tarification flexible et transparent conçu en fonction des différents besoins des utilisateurs. Le coût du modèle est calculé à la fois sur le texte envoyé par l'utilisateur (jet d'entrée / jeton d'entrée) et sur les réponses générées par le modèle (jeton de sortie / jeton de sortie).
Cache frappe signifie une réutilisation d'une requête précédemment traitée et réduit les coûts. Cache miss fait référence à de nouvelles transactions à chaque fois et augmente les coûts.
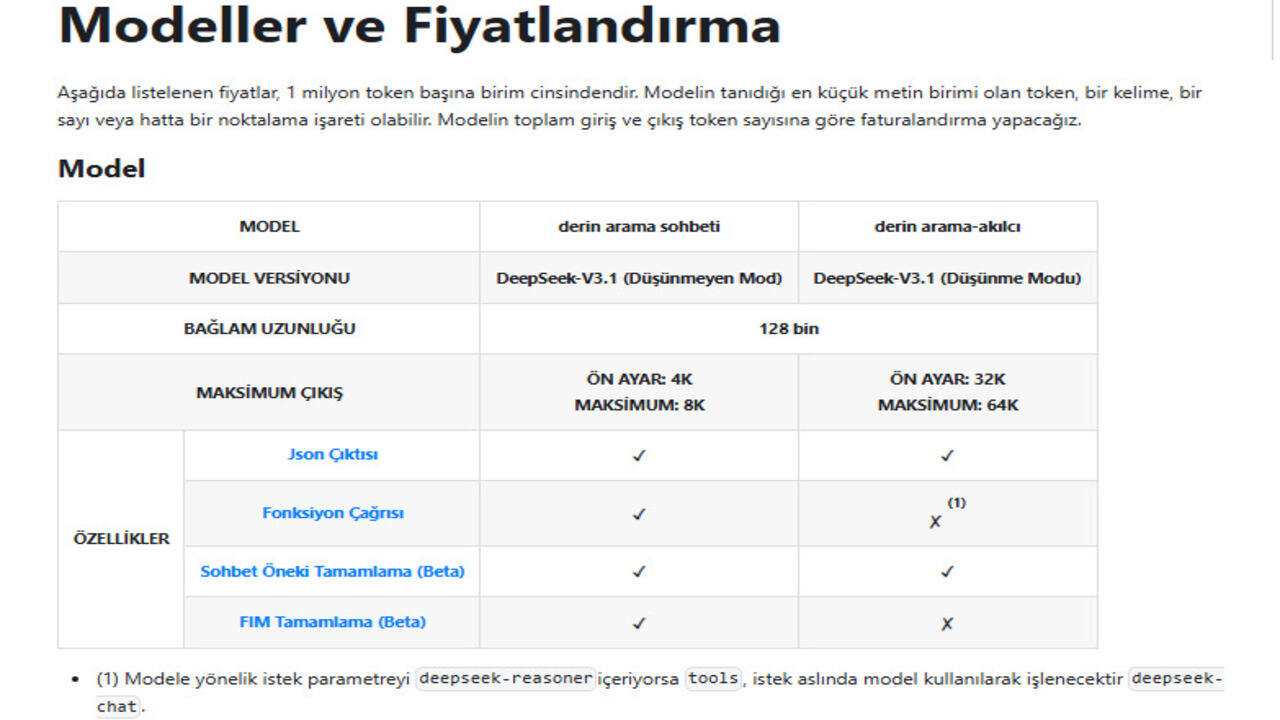
Prix DeepSeek V3.1
Par prix:
Chat DeepSeek :
jet d'entrée (coup de cache) = 0,07 $ / 1M jeton
jet d'entrée (cache miss) = 0,56 $ / 1M jeton
Jeton de sortie = 1,68 $/1M
DeepSeek-Akıllı:
Henüz fiyat detayları açıklanmamıştır; kullanıcıların güncellemeleri takip etmesi önerilmektedir.
Önemli Kavramlar ve Maliyet Hesaplama
Giriş Jetosu (Input Token): Kullanıcının modele gönderdiği metin, soru veya komut.
Çıkış Jetosu (Output Token): Modelin ürettiği yanıt metni.
Önbelleğe Ulaşım (Cache Hit): Daha önce işlenmiş bir sorgunun tekrar kullanılması → maliyet avantajı sağlar.
Önbellek Kaçırma (Cache Miss): Yeni işlem yapılması → daha yüksek maliyet.
Maliyet Hesaplama Formülü: Toplam Maliyet = (Giriş Jetosu Sayısı × Giriş Jetosu Fiyatı) + (Çıkış Jetosu Sayısı × Çıkış Jetosu Fiyatı)
Ödeme Seçenekleri
DeepSeek, kullanıcıların ödemelerini kolayca yönetmesini sağlıyor:
Ücretler, kullanıcının eklenmiş veya promosyon bakiyesinden düşülür; promosyon bakiye varsa öncelikle bu kullanılır.
Ödeme yöntemleri arasında kredi kartı, banka havalesi ve PayPal yer alır.
Kurumsal müşteriler için fatura bazlı ödeme seçeneği mevcuttur.
Detaylı bilgi ve en güncel fiyatlandırma planları için DeepSeek’in resmi web sitesinin takip edilmesi önerilmektedir.
DeepSeek V3.1 Ve Rakipleri
DeepSeek V3.1, yalnızca kendi başına güçlü bir model olmakla kalmıyor; aynı zamanda mevcut büyük dil modelleri (LLM) ve yapay zeka sistemleriyle karşılaştırıldığında öne çıkan bazı avantajlar sunuyor. En bilinen rakipleri arasında OpenAI’nin GPT-4 serisi, Anthropic’in Claude modelleri ve Meta’nın LLaMA modelleri bulunuyor.
Kullanım Amaçları
DeepSeek V3.1: Akademik araştırma, uzun metin analizi, yaratıcı yazarlık, kodlama, kurumsal chatbotlar.
GPT-4 / Claude: Genel amaçlı sohbet, metin üretimi, kodlama, araştırma. Ancak uzun bağlamlarda ve düşük maliyetli yerel kullanımda DeepSeek daha avantajlı.
LLaMA: Daha çok araştırma ve deneysel kullanım odaklı, ticari API entegrasyonu sınırlı.
Performans Karşılaştırması
Codage d'Aider Référence : DeepSeek V3.1 évalué à 1% de plus que Claude Opus 4. Cela offre une supériorité, en particulier dans les capacités de codage et de résolution d'algorithmes.
Traitement de texte long : La fenêtre contextuelle 128K de DeepSeek, la capacité de jeton 32-64K de GPT-4 et Claude, vous permet de traiter des textes beaucoup plus longs simultanément. C'est un grand avantage pour de longs ensembles de données, comme les projets de droit, d'académie et de logiciel.
Comprendre et produire le langage naturel : DeepSeek V3.1 dans les tâches NLP (texte décrit, traduction, analyse des sensations) a des taux de précision similaires à ceux de ses concurrents, mais il fonctionne plus rapidement et l'énergie efficacement.
Comparaison des coûts
Un des avantages les plus forts de DeepSeek V3.1 est le coût. En utilisation via l'API, le coût de 20 à 40 fois inférieur aux modèles OpenAI et Anthropic apparaît.
Grâce au mode Think et à l'architecture du MoE, la consommation d'énergie est minimisée car elle n'exécute pas de paramètre inutile. Cela procure également un avantage important en matière d'épargne pour les entreprises.
Flexibilité et personnalisation
L'open source est l'une des plus grandes fonctionnalités qui distinguent DeepSeek de ses concurrents. Avec Hugging Face et GitHub, il est possible d'accéder aux codes modèles, qui offrent une personnalisation et une utilisation locale.
Les modèles concurrents sont généralement fermés et ne sont accessibles qu'au moyen de l'API. Cela peut être limité pour certains développeurs et chercheurs.
Orientations positives et négatives
Orientations positives | Orientations négatives |
Open Welded – Model est ouvert à tous sous licence MIT. Cela permet aux développeurs d'examiner et de personnaliser en toute transparence. | Risques de sécurité – Les modèles open-source peuvent être utilisés pour la dézenformation ou les cyberattaques par des personnes malveillantes. |
Avantage de coûts – 20-40 fois moins cher que les concurrents, totalement gratuit s'ils sont dans le local.
Exigences matérielles – Il y a des GPU forts et de gros besoins de mémoire pour fonctionner localement.
Architecture hybride – Il peut s'adapter à différents scénarios avec des modes de pensée et non-penser.
Problèmes de support linguistique – Pas aussi forts que les modèles OpenAI, en particulier dans les langues turques et régionales.
Haute performance – Claude et concurrents basés sur le GPT dans les tests Benchmark.
Spécificité de la réglementation – Comme le contrôle de l'intelligence artificielle à source ouverte est difficile, les discussions sur la réglementation peuvent augmenter.
Large capacité de bond – Avec le support 128K jeton, le texte équivalent à 400 pages peut être traité simultanément.
Lenteur du mode de pensée – Bien qu'il produise des réponses plus précises, le mode de pensée peut entraîner des retards dans les applications en temps réel.
Zone d'utilisation flexible – Développement de logiciels, université, journalisme, service à la clientèle.
OpenAI: ChatGPT Erotik İçerik Sunmaya Hazırlanıyor
Tasarım Yapay Zeka ile Nasıl Kullanılır?
Articles similaires



Commentaires (0)
Connecte-toi pour commenter.
Se connecter