



DeepSeek V4 introduit: 1 million de jetons et 1.6T Paramètre !
Traduit automatiquement
DeepSeek basé en ChineAvec le modèle V4, 1 million de contextes de jetons et 1,6 billion de paramètres redéfinis échelle, efficacité et équilibre des coûts dans l'intelligence artificielle.
Qu'est-ce que DeepSeek V4 et pourquoi important?
La concurrence dans le domaine de l'intelligence artificielle n'est pas seulement grâce à la précision du modèle; alors que la longueur du contexte est redéfinie par des paramètres tels que le coût de traitement et l'évolutivité, le modèle DeepSeek V4 introduit par DeepSeek est placé comme l'un des exemples les plus concrets de cette conversion. La question « Qu'est-ce que DeepSeek V4 ? » se limite non seulement à une nouvelle définition de modèle, mais fait également référence à la fracture de l'architecture technique des grands modèles de langage (LLM). Le modèle d'une capacité contextuelle de 1 million de jetons, le traitement de texte long, l'analyse de code et une expansion radicale dans les tâches de raisonnement en plusieurs étapes, 1,6 billion d'échelle de paramètre représente le nouveau seuil que l'intelligence artificielle atteint dans la puissance de calcul.
Ce développement est possible pour traiter plus d'informations en une seule session dans les domaines des finances, du droit, du génie logiciel et de la recherche universitaire, en particulier dans les industries à forte intensité de données. Les processus d'analyse qui sont attachés à la limite de contexte dans les modèles traditionnels peuvent maintenant être réalisés en continu sur des grappes de données beaucoup plus larges. Cela signifie non seulement l'augmentation des performances, mais aussi la refonte des flux de travail.
La série V4 DeepSeek signifie non seulement une croissance à l'échelle, mais aussi une refonte architecturale. La famille de modèles développée par DeepSeek est présentée avec deux structures différentes dont DeepSeek-V4-Pro et DeepSeek-V4-Flash. Open source dans la collection officielle Hugging Face Le modèle lancé en tant que norme contextuelle 1M vise à faire de l'industrie une nouvelle norme.
1 million de jetons d'intelligence artificielle : limites de subventions
La capacité contextuelle de 1 million de jetons, l'une des innovations les plus remarquables de DeepSeek V4, est considérée comme l'un des plus grands sauts techniques jamais rencontrés dans les modèles d'intelligence artificielle. Alors que le jeton est défini comme l'une des plus petites unités qui peuvent être traitées à partir d'un texte, cela signifie que la capacité atteint 1 million; des centaines de documents de page peuvent être analysés à un moment de grandes bases de code ou de jeux de données multicouches.
Cette évolution crée un avantage sérieux, en particulier dans les tâches exigeant un contexte long. Par exemple, l'analyse de l'ensemble du texte d'une loi, des processus tels que le débogage dans des projets logiciels à grande échelle, ou une comparaison approfondie d'articles académiques peuvent maintenant être effectués de la manière la plus complète, et non des parties. Cela élimine considérablement le problème du modèle de continuité de la lumière.
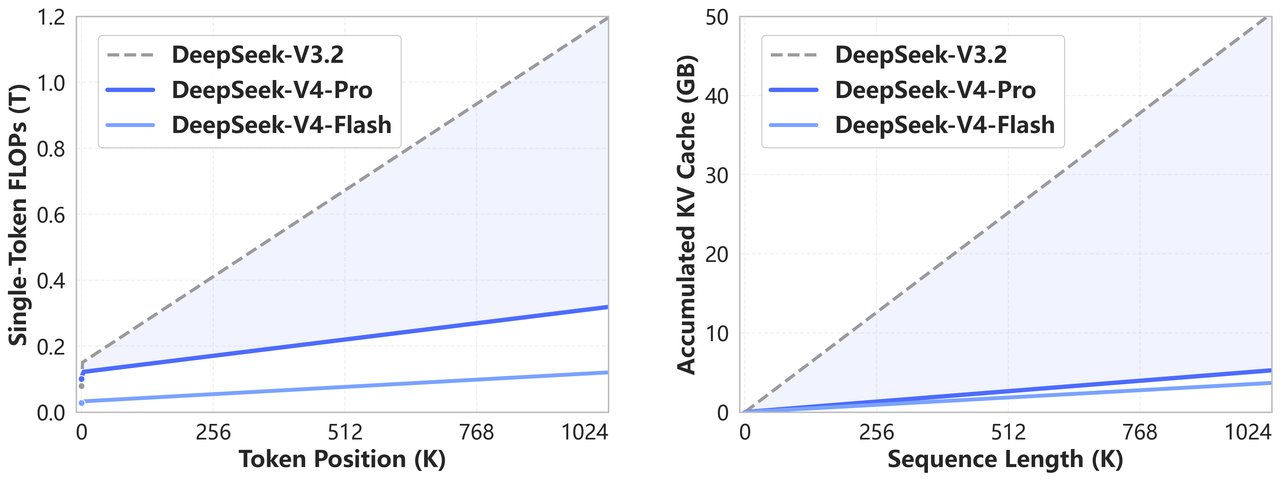
DeepSeek V4, Architecture de l'attention hybride Grâce à son long traitement de contexte, il offre de sérieux gains d'efficacité. Le modèle avec la combinaison de Compressed Sparse Attention (CSA) et de Heavily Attention Compressed (HCA) peut fonctionner avec des coûts de calcul beaucoup plus faibles que les générations précédentes. En particulier, l'utilisation du cache KV dans le scénario du jeton 1M est significativement réduite.
Mixture d'architecture d'experts: Approche de renseignement évolutive
L'architecture de mélange d'experts (MoE), située dans la colonne vertébrale technique de DeepSeek V4, se distingue comme le mécanisme de base, qui permet au modèle de fonctionner efficacement malgré le nombre élevé de paramètres. Cette architecture permet à l'ensemble du modèle d'être activé uniquement les sous-réseaux liés à "Special" pour certaines tâches au lieu de fonctionner en même temps.
Cette approche offre un avantage de calcul sérieux par rapport aux modèles intensifs classiques. Au lieu d'utiliser l'ensemble du modèle avec 1,6 billion de paramètres, seules les pièces nécessaires sont activées; à la fois réduire le coût de traitement et optimiser le temps de réponse. Cette situation se distingue particulièrement comme un facteur critique qui affecte directement l'équilibre coût-performance dans l'utilisation de l'API.
L'architecture du MoE offre également des taux de précision plus élevés, permettant au modèle d'être expert dans différents types de tâches. Ce qui rend DeepSeek V4 non seulement grand mais aussi un modèle à échelle intelligente.
Les modèles Pro et Flash de l'architecture DeepSeek V4 sont divisés en différents niveaux de paramètres actifs. DeepSeek-V4-Pro 1.6T fonctionne avec le paramètre actif 13B dans le paramètre total de 49B, DeepSeek-V4-Flash 284B. Cette structure est le principal avantage de l'architecture du MoEcalcul autant que nécessaireLe principe est directement appliqué.
La structure d'hyper-connections manifold-constrained (mHC) située dans l'architecture de DeepSeek V4, permet au modèle de protéger la puissance d'expression tout en stabilisant le flux d'information entre les couches. En outre, l'utilisation optimisée de Muon offre une convergence plus rapide et une dynamique d'apprentissage plus stable dans le processus éducatif.
Efficacité KV Cache: la force secrète de la connexion longue
Un autre élément essentiel à l'utilisation pratique d'une longue capacité de contexte est l'optimisation de KV Cache (Key-Value Cache). KV L'efficacité du cache développé dans DeepSeek V4 réduit considérablement la charge de traitement en permettant au modèle d'utiliser des jetons précédents sans recalcul.
Cette amélioration technique affecte directement les performances des applications qui nécessitent de longs dialogues et un flux continu de données. Par exemple, un système d'intelligence artificielle avec une interaction à long terme avec un utilisateur peut produire des réponses rapides et cohérentes sans avoir à retraiter toute l'histoire dans chaque nouvelle entrée.
L'optimisation de KV Cache joue également un rôle crucial en termes d'efficacité énergétique. Moins d'exigences de calcul signifie une consommation énergétique plus faible; cette situation affecte directement les coûts opérationnels dans les grands centres de données.
DeepSeek V4-Pro travaille avec environ 10% d'utilisation de cache KV dans le scénario de contexte 1M par rapport à DeepSeek-V3.2, inférence FLOPs côté offre également une structure plus efficace au niveau 27%. Cette optimisation offre une augmentation significative des performances, surtout dans les applications de longue durée et basées sur les agents.
DeepSeek V4 Pro Caractéristiques: Performance au niveau de l'entreprise
DeepSeek V4 Pro est positionné comme la version la plus forte de la famille de modèles et se concentre sur les scénarios d'utilisation d'entreprise en particulier. Des capacités de raisonnement avancées, une gestion de contexte longue et des taux de précision élevés rendent cette version idéale pour les projets nécessitant un traitement de données important.
Une des caractéristiques les plus importantes de la version Pro peut produire des résultats plus cohérents dans des tâches complexes. Très étape par étape la résolution de problèmes, la production de code de niveau avancé et les tâches d'analyse, la performance du modèle est importante. En outre, grâce à la structure flexible offerte par l'API, les entreprises peuvent intégrer le modèle en fonction de leurs besoins.
DeepSeek V4 Flash vs Pro: Rendement et solde des coûts
Les versions Flash et Pro incluses dans la famille DeepSeek V4 sont positionnées pour répondre à différents scénarios d'utilisation. Version Flash, tout en offrant moins de latence et d'avantage de coûts; la version Pro fonctionne avec une performance et une précision maximales.
Le modèle Flash est optimisé pour les applications en temps réel comme chatbots, service client et production de contenu rapide. Le modèle Pro correspondant est préféré dans les tâches plus lourdes et complexes. Cette distinction permet aux développeurs de choisir le bon modèle en fonction de leurs besoins.
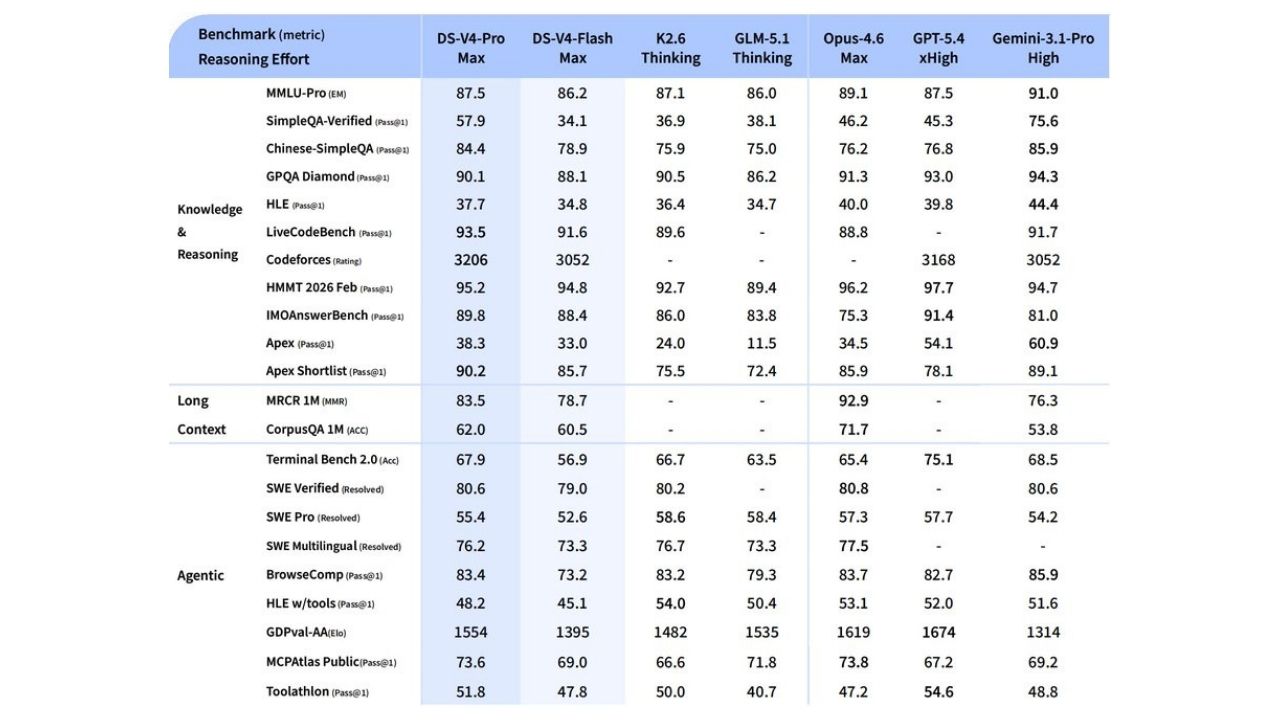
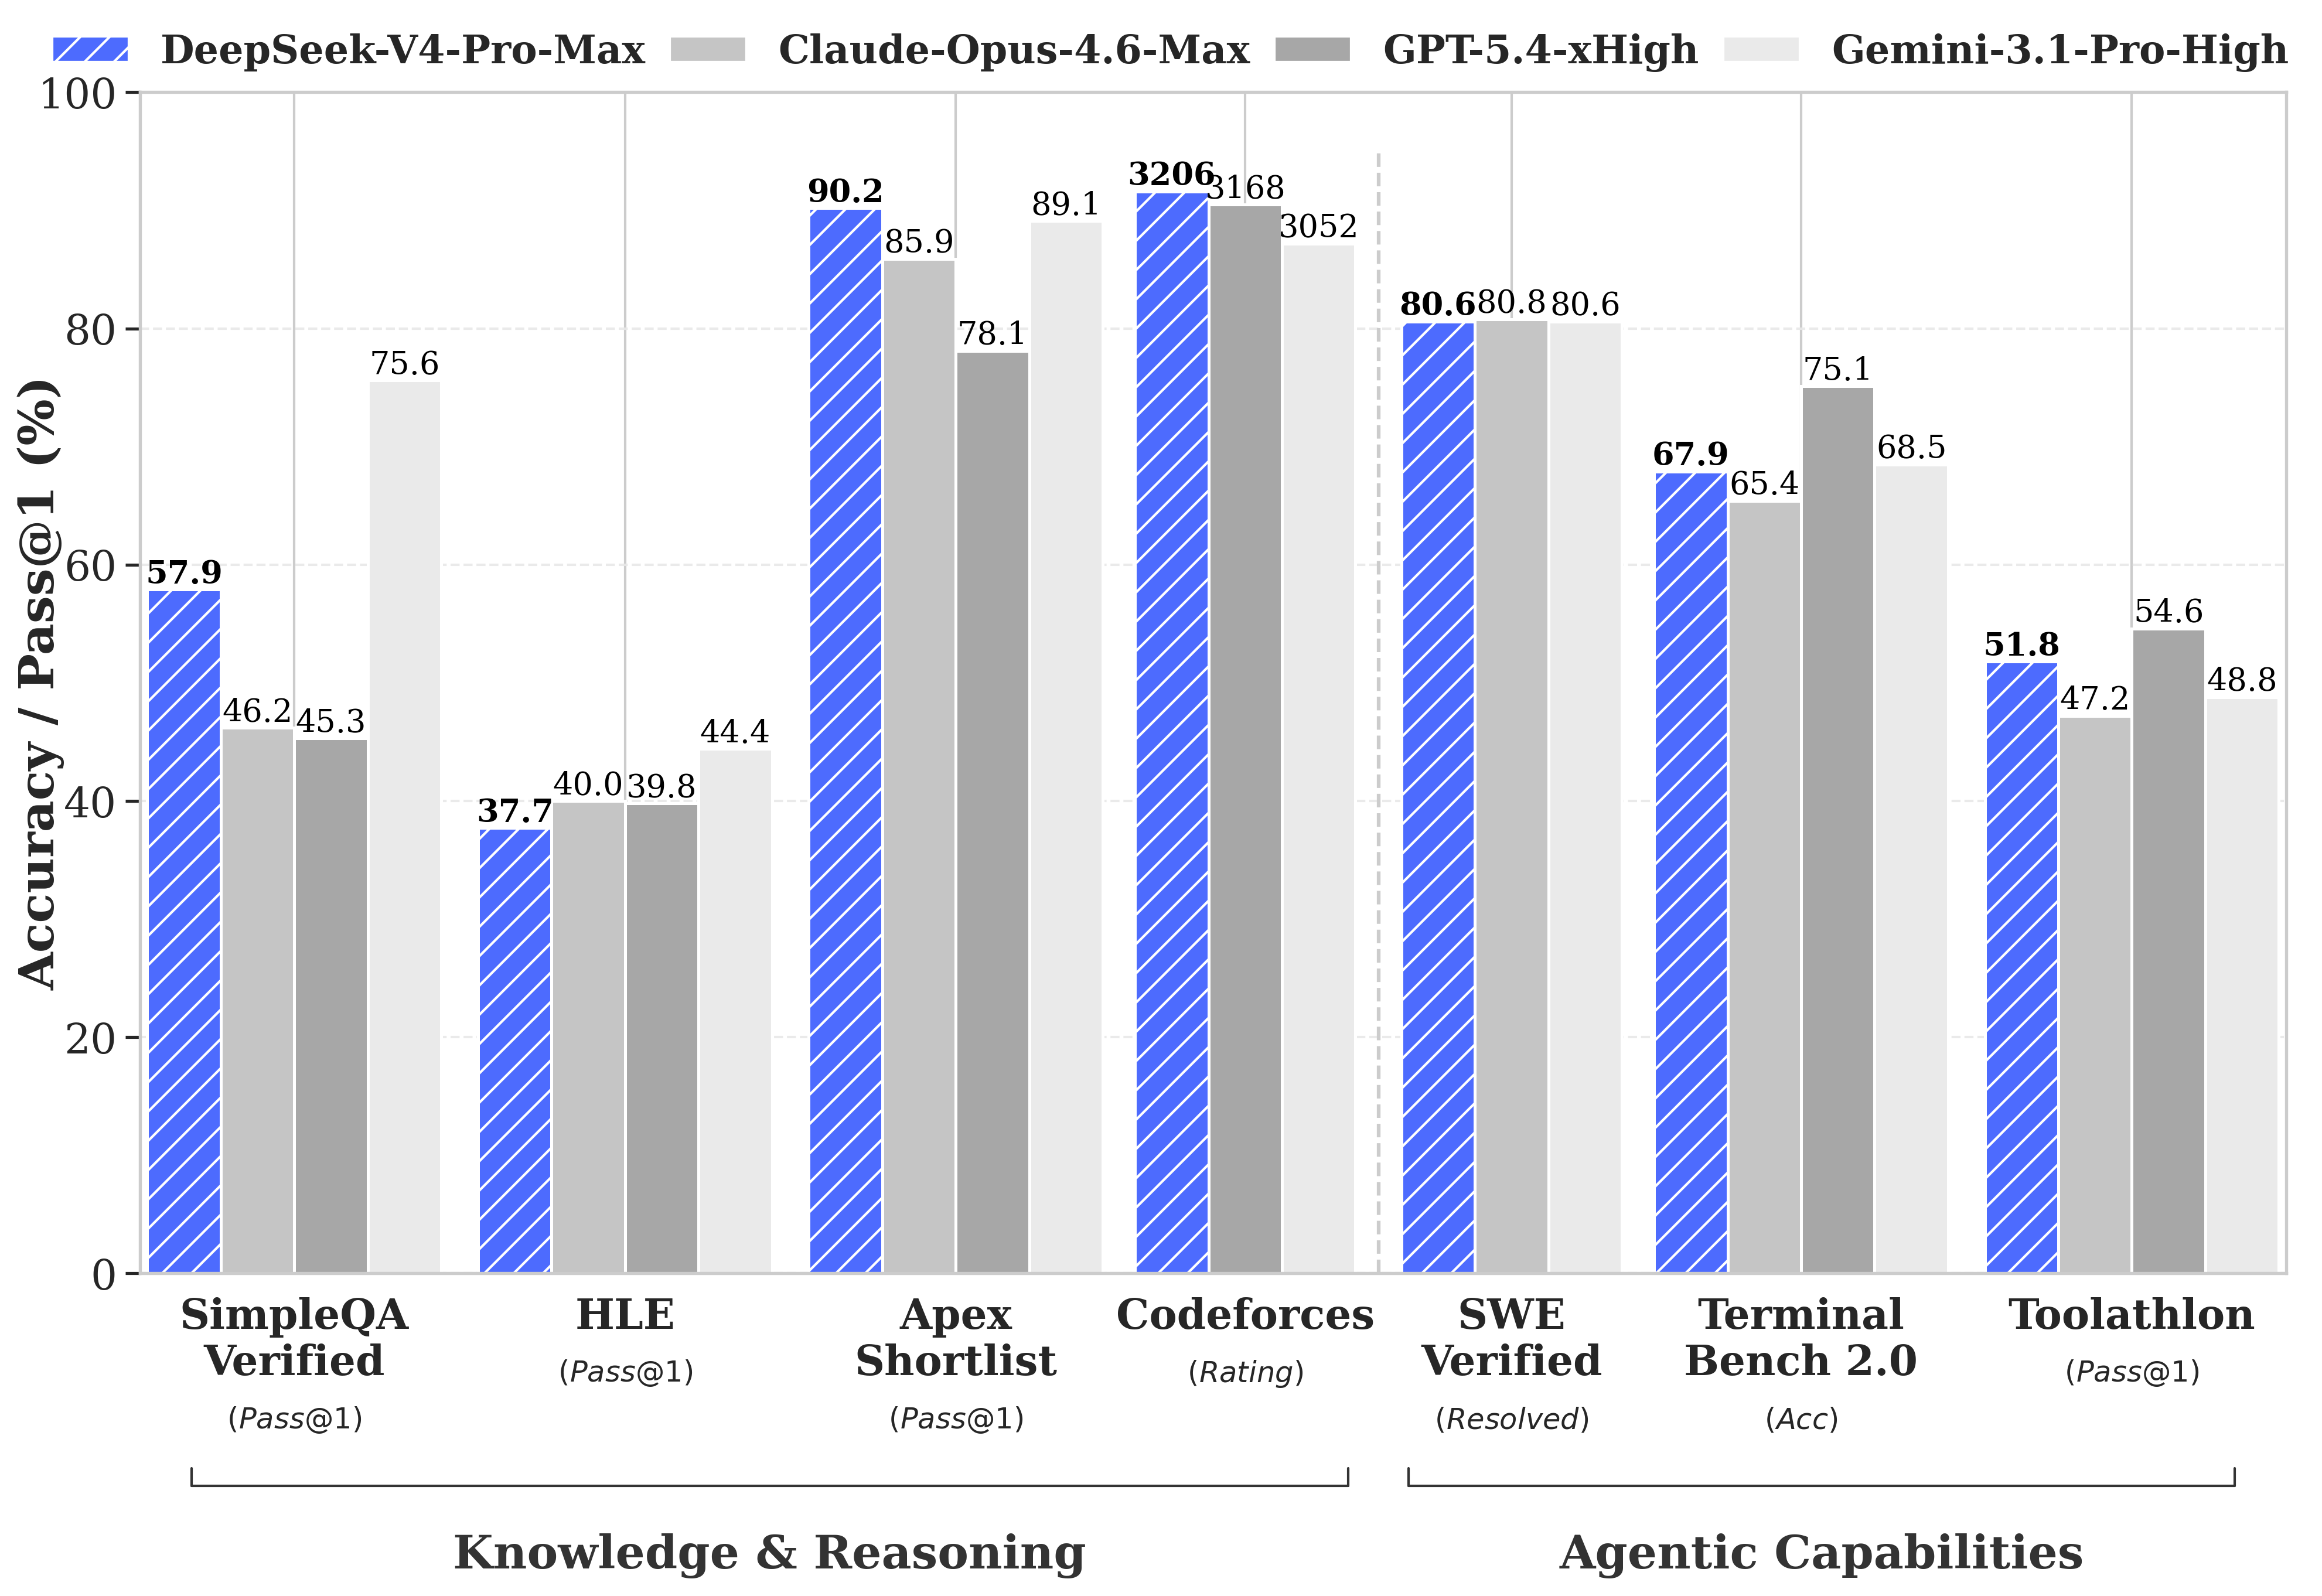
Le modèle Flash offre une latence plus faible grâce à sa structure de paramètre actif plus petite par rapport à la version Pro, tandis que les tâches d'agent simples peuvent effectuer près du niveau Pro. Le modèle Pro opposé est particulièrement complexe raisonnement, recherche claire pour le codage et les tâches de résolution de problèmes scientifiques de meilleurs résultats produire.
Prix de l'API DeepSeek V4 : Stratégie concurrentielle
Le prix de l'API DeepSeek V4 est évalué comme une stratégie de concurrence agressive, compte tenu de la capacité technique du modèle. En raison de son architecture MoE, les coûts de traitement réduits se reflètent comme une expérience API plus abordable pour l'utilisateur.
Cette situation se distingue comme un facteur qui affecte directement la concurrence avec les grands acteurs tels que OpenAI et Google sur le marché. Un contexte plus long, un coût moins élevé et une combinaison haute performance font que DeepSeek atteint une position forte dans la course mondiale de l'intelligence artificielle.
L'API DeepSeek V4 fonctionne avec OpenAI ChatCompletions et la structure compatible Anthropic. Les utilisateurs n'ont que le nom de modèle deepseek-v4-pro ou deepseek-v4-flash Elle peut s'intégrer dans les systèmes existants en changeant. Sommaire Mode de réflexion et de soutenir différents niveaux de raisonnement tels que le mode non-pensant.
Nouvel équilibre dans la course mondiale de l'intelligence artificielle
L'introduction de DeepSeek V4 n'est pas seulement un développement technique mais crée également un nouveau point d'équilibre dans la concurrence mondiale de l'intelligence artificielle. La progression rapide dans ce domaine des entreprises chinoises devient de plus en plus en colère contre les géants de la technologie américains.
Dans ce contexte, les performances des modèles développés sur les infrastructures NVIDIA attirent également l'attention. L'optimisation de l'intégration matérielle et logicielle est l'un des facteurs qui jouent un rôle décisif dans l'avenir de l'IA.
Échelle, efficacité et perspectives d'avenir
DeepSeek V4 est considéré non seulement comme des modèles plus grands dans l'intelligence artificielle; des systèmes plus efficaces, plus évolutifs et plus accessibles comme messager d'une nouvelle ère. Une capacité de contexte de 1 million de jetons, un paramètre de 1,6 billion et des optimisations architecturales avancées; ce modèle montre seulement que ce modèle façonnera les normes d'intelligence artificielle dans les années à venir.
Cette évolution n'apparaît pas seulement pour les entreprises technologiques de l'intelligence artificielle; une fois qu'elle devient une infrastructure stratégique pour tous les secteurs. Avec DeepSeek V4, le concept de modèle Biger laisse le modèle plus intelligent et plus efficace de paradig.
DeepSeek V4, en particulier dans la course mondiale d'IA un point de rupture important du côté open source créer. La publication du modèle à poids ouverts renforce le potentiel de création d'un écosystème alternatif aux systèmes fermés.
JP Morgan Raporu: İnsansı Robotlarda Dönüm Noktası
Robotlara Beyin Geldi: Gemini Robotics-ER 1.6 ile Tanışın!
Articles similaires



Commentaires (0)
Connecte-toi pour commenter.
Se connecter