Comment améliorer l'intelligence artificielle vocale avec ElevenLabs en temps réel ?
Traduit automatiquement
 Auteur
Dans les applications de l'intelligence artificielle, les interactions textuelles deviennent plus naturelles. Les systèmes d'IA vocale, que les utilisateurs peuvent effectuer directement au lieu d'écrire une commande, en particulier le service à la clientèle, la formation, les assistants numériques et les nouvelles installations d'utilisation dans les domaines de l'automatisation. Cependant, il ne se limite pas à convertir simplement du texte en audio que l'expérience est réussie. Il est également nécessaire de comprendre que l'utilisateur dit correctement, gère la file d'attente de la parole, réagit quand combiné et voix sans attendre la réponse.
ElevenLabs, Avec Onze modèles en temps réel développés pour ce besoin, Onze offre aux développeurs une nouvelle infrastructure qui peut créer des applications d'IA vocale en temps réel. Le système basé sur l'approche de la parole à la parole; la reconnaissance de la parole, le modèle de langue, la gestion de la séquence de la parole et la production audio. Ainsi, les développeurs visent à réduire le besoin de différentes technologies audio individuellement.
Qu'est-ce que ElevenLabs en temps réel?
ElevenLabs Le temps réel est une famille de modèles Speech-to-Speech conçue pour améliorer les agents d'IA vocale en temps réel. Dans les assistants vocaux traditionnels, la conversation utilisateur est convertie en texte d'abord, puis traitée par un modèle de langue et enfin le texte est traduit à nouveau en audio. Le temps de réponse total du système peut être un espace lorsque chacun de ces processus est exécuté par différents services.
Onze Realtime combine ces composants dans un système optimisé qui fonctionnera en harmonie les uns avec les autres. La reconnaissance de la parole, le traitement du langage naturel, la gestion de la séquence de la parole et la synthèse audio peuvent être configurés au moyen d'une seule sélection de modèles.
Le but principal ici est de brûler l'interaction entre l'utilisateur et l'intelligence artificielle plutôt qu'une conversation écrite. Par exemple, lorsque l'utilisateur demande un assistant de service à la clientèle, le système attendra la fin de toute la conversation d'abord, alors il n'a pas besoin de lancer une longue chaîne de trading. Il est possible de répondre au flux de la parole et de gérer des situations telles que couper le mot de l'utilisateur.
La nouvelle famille de modèles de ElevenLabs peut être intégrée dans différentes applications avec plus de 90 langues de support et plus de 17 000 options audio sur la plateforme.
Comment Onze fonctionne en temps réel?
Un des éléments importants qui déterminent la performance des systèmes d'IA vocale en temps réel est le temps de retard. Si l'utilisateur doit attendre longtemps le début de la réponse après avoir posé une question, le système ne suffit pas à produire des réponses techniquement exactes.
Onze temps réel vise à aborder ce problème en optimisant les composants de la chaîne de traitement de la parole.
Architecture de discours à discours
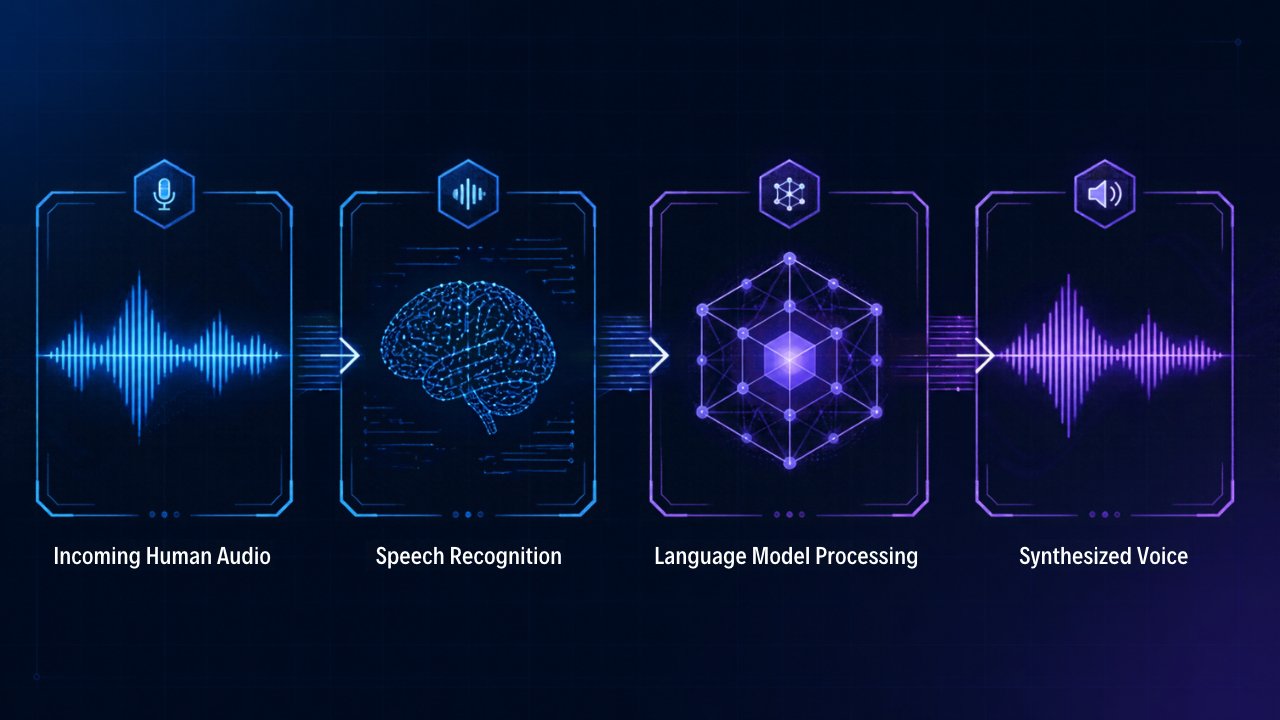
Speech-to-Speech fait référence à la création de la sortie vocale par le traitement de l'entrée vocale. Lorsque l'utilisateur parle au microphone, le système prend cette entrée, résout la parole, évalue le contexte de la requête et produit la voix de réponse appropriée.
Dans ce processus, quatre éléments de base se distinguent :
Discours au texte : Il convertit le contenu textuel en reconnaissant la parole de l'utilisateur.
Modèle linguistique (LLM): Il répond à la demande de l'utilisateur, aux conversations précédentes et aux instructions du système.
Tournage : Il gère quand l'utilisateur parle, quand il s'arrête et quand l'intelligence artificielle doit répondre.
Text-to-Speech : La réponse créée se convertit en parole via un audio sélectionné.
Une des caractéristiques importantes de Onze Realtime est que ces composants ne sont pas laissés comme des services indépendants et configurés au hasard. ElevenLabs exécute des composants avec une architecture optimisée de bout en bout.
Voici un détail technique important: Onze en temps réel, Toutes les étapes ne sont pas définies comme un modèle qui fonctionne dans un seul réseau nerveux intégré. Selon la description de ElevenLabs, le système utilise une architecture progressive (cascaded) où des composants séparés sont optimisés ensemble. Cette approche vous permet également de surveiller les inter-étapes du processus de parole.
Faible retard et flux de parole naturel
Le retard dans les applications d'IA vocale en temps réel est l'un des indicateurs de base de l'expérience utilisateur. En particulier, il peut perturber la nature de la parole même quelques secondes d'attente dans le service à la clientèle ou des applications d'assistant personnel.
Onze temps réel ne se concentre pas seulement sur l'accélération de la production sonore, améliorant l'ensemble du flux de la parole. La coupe de mots de l'utilisateur est parmi les interactions qui peuvent évaluer le système, comme penser pour un court laps de temps ou orienter une nouvelle question pendant la conversation.
Cette fonctionnalité révèle la différence entre les agents d'IA vocale plus avancés et les assistants audio traditionnels basés sur le script. Au lieu d'attendre un script spécifique de l'utilisateur, les systèmes mobiles basés sur le contexte de la parole peuvent créer des interactions plus flexibles.
Différences entre Onze temps réel v1 Mini et v1 Max
ElevenLabs offre une famille de modèles en temps réel avec deux options selon différents besoins. Les modèles Mini et Max partagent la même approche d'interaction vocale de base, ils sont divisés en complexité de processus et domaines d'utilisation cibles.
Onze Realtime v1 Mini: Talks naturels et rapides
Onze Realtime v1 Mini a été développé pour des applications nécessitant des expériences de langage naturel et à faible coût. En particulier, les assistants quotidiens de l'IA, les applications éducatives et les personnages interactifs font partie des domaines d'utilisation des cibles du modèle.
Les points forts du mini modèle sont:
Concentrez-vous sur le flux naturel de la parole.
Il peut gérer le flux de parole lorsque l'utilisateur entre.
Optimisé pour des interactions rapides.
Soutenir la parole dans plus de 90 langues.
ElevenLabs peut être utilisé dans la bibliothèque audio.
Dans les résultats de test partagés par ElevenLabs, le premier son pour v1 Mini est indiqué en 620 millisecondes. Le résultat de l'évaluation complète duplex est de 95,8 %. Le score de l'agent de discours Arena Elo est de 988.
Ce modèle crée un point de départ approprié pour les applications où les chaînes de trading complexes sont très rapides et la communication naturelle est importante.
Onze temps réel v1 Max: Intelligence artificielle vocale pour les tâches complexes
Onze Realtime v1 Max se concentre sur les agents d'IA vocale qui doivent suivre des instructions plus complexes et effectuer des opérations multi-étapes.
Le soutien à la clientèle ne suffit pas à comprendre seulement la conversation dans des applications telles que l'évaluation du client potentiel et la planification des rendez-vous. Le système doit compléter le processus en évaluant le but de l'utilisateur, en recueillant les informations nécessaires et en effectuant des appels de véhicules au besoin.
Le modèle max offre des capacités de raisonnement plus avancées pour de telles tâches.
Le premier temps de production sonore pour v1 Max selon les résultats de test annoncés par ElevenLabs 570 millisecondes. 98,8 pour cent de Big Bench Audio et 87,1 pour cent de résultat est atteint.
Les données de performance des modèles mini et Max sont basées sur différents critères d'évaluation. Par conséquent, il n'est pas vrai de dire que l'un d'eux est plus réussi dans n'importe quelle condition en comparant directement les résultats de deux modèles.
Quel modèle devrait être préféré?
Scénario d'utilisation | Modèle recommandé |
|---|---|
Assistants vocaux quotidiens | v1 Mini |
Applications d'éducation et d'apprentissage des langues | v1 Mini |
Caractères interactifs | v1 Mini |
Services à la clientèle | v1 Max |
Évaluation des clients potentiels | v1 Max |
Tâches en plusieurs étapes
v1 Max
Opérations nécessitant un appel de véhicule
v1 Max
Dans le choix des modèles, il est nécessaire d'être attentif non seulement à la vitesse de réponse, mais aussi au traitement attendu de la demande. Pour un assistant qui répond à des questions simples, le Mini peut être suffisant, tout en se connectant avec plusieurs systèmes et max peut être une option plus pratique pour un agent qui effectue des transactions.
Comment améliorer l'intelligence artificielle vocale avec ElevenLabs en temps réel ?
ElevenLabs propose aux développeurs d'utiliser la technologie en temps réel de deux manières différentes : la plateforme OnzeAgents et l'API en temps réel. Bien que ces deux méthodes bénéficient de capacités d'interaction vocale similaires, elles diffèrent dans les processus de développement et de distribution.
Créer Voice AI Agent à partir d'OnzeAgents
OnzeAgents offre une plateforme pour les développeurs qui veulent créer des agents d'IA vocale en réduisant autant que possible le processus de codage.
Dans cette méthode, les développeurs peuvent créer un nouvel agent ou modifier un agent existant. Vous pouvez alors identifier l'un des modèles de v1 Mini ou v1 Max en passant l'option temps réel des modèles.
Le processus de développement fondamental consiste à :
Le compte ElevenLabs est connecté à la plateforme OnzeAgents.
Un nouvel agent vocal est créé ou l'agent existant s'ouvre.
Le mode sonore de l'agent est déterminé en temps réel.
Le modèle Mini ou Max est sélectionné en fonction du but de l'utilisation.
Les instructions du système, la voix vocale et les outils nécessaires sont configurés.
L'agent est testé et publié dans les canaux de distribution appropriés.
Les agents développés via OnzeAgents peuvent être intégrés dans les canaux de communication tels que les sites Web, les systèmes téléphoniques et WhatsApp. Les caractéristiques requises dans l'environnement de production, telles que la base d'information, les règles de sécurité, les scénarios d'essai et la surveillance de la parole, font également partie des installations offertes par la plateforme.
Intégration avec l'API en temps réel
Les développeurs qui prévoient intégrer la technologie ElevenLabs dans une application d'intelligence artificielle vocale existante.
Une des caractéristiques remarquables de ElevenLabs, l'API en temps réel utilise un protocole compatible avec l'API en temps réel OpenAI. Ainsi, les développeurs avec l'intégration OpenAI en temps réel SDK peuvent essayer l'infrastructure ElevenLabs en modifiant l'adresse du lien et la configuration du modèle au lieu d'écrire l'application entière.
Mais il y a un détail important pour le fonctionnement sécurisé de l'intégration: la clé API ne doit pas être placée directement dans le navigateur. Une clé client de courte durée (secrète client) est créée par le serveur backend de l'application et ne doit être donnée au client qu'avec ces identifiants temporaires.
Aussi la connexion API existante de ElevenLabs fonctionne en temps réel via WebSocket. Le support WebRTC doit changer directement dans la couche de lien d'une application existante qui utilise WebRTC parce qu'il n'est pas encore disponible. Les opérations de capture et de lecture vocales via WebSocket devraient également être gérées par le développeur.
Où l'intelligence artificielle en temps réel peut-elle être disponible?
ElevenLabs Le temps réel offre une variété d'utilisations aux équipes qui veulent développer des applications basées sur la parole dans différentes industries.
Services à la clientèle et centres d'appels
Les agents d'IA vocale peuvent être utilisés pour répondre aux demandes des clients, répondre aux questions fréquemment posées et automatiser certains processus.
Par exemple, lorsque vous voulez apprendre l'état d'une commande d'utilisateur, vous pouvez recevoir des données de la base d'informations pertinente ou des systèmes connectés. Il peut guider l'utilisateur en appelant les outils nécessaires dans des processus plus complexes.
Éducation et pratiques d'apprentissage des langues
L'IA vocale en temps réel est capable de développer des applications éducatives que les étudiants peuvent pratiquer en parlant mutuellement avec une intelligence artificielle.
La pratique de la parole, les études de prononciation et les simulations de dialogue dans l'apprentissage des langues étrangères créent des domaines d'utilisation importants. Les élèves peuvent faire une conversation naturelle avec l'intelligence artificielle au lieu de choisir parmi les options pré-faites.
Assistants numériques et assistants personnels
Les agents d'IA vocale peuvent être utilisés dans des tâches telles que la gestion du calendrier, les demandes d'information, la création de rappels et divers processus numériques.
À ce stade, la fonction d'appel de véhicule est également importante. Il est nécessaire d'achever un processus en interagissant avec les systèmes autorisés, non seulement répond à l'intelligence artificielle.
Jeux et personnages interactifs
Les développeurs de jeux peuvent créer des expériences que les joueurs peuvent effectuer des conversations naturelles avec des personnages à l'intérieur du jeu.
Les personnages qui peuvent être issus de dialogues écrits antérieurement peuvent donner différentes réponses aux questions du joueur et au contexte de la parole. Cette approche offre de nouvelles possibilités de jeux de rôles, de simulations et d'expériences interactives.
Différence entre ElevenLabs API en temps réel et OnzeAgents
Une des choses que les développeurs devraient faire attention est que la plate-forme OnzeAgents n'est pas le même produit avec l'API en temps réel.
L'API en temps réel offre une connectivité et une infrastructure de modèle aux développeurs qui veulent intégrer les capacités d'IA vocale aux applications existantes. OnzeAgents offre une plateforme plus complète pour la création, la configuration et la publication dans différents canaux.
Par exemple, OnzeAgents peut être une option plus pratique pour une équipe qui a besoin de téléphone, WhatsApp, widget Web, base d'informations, règles de sécurité, tests et fonctions de suivi.
À son tour, les développeurs qui veulent gérer leur architecture et travailler avec OpenAI Realtime SDK peuvent choisir l'intégration d'API en temps réel.
Il est nécessaire de noter que deux produits fonctionnent séparément. Les fonctionnalités OnzeAgents ne sont pas disponibles directement via l'API en temps réel. Par conséquent, l'architecture du projet doit être évaluée à l'avance, quelles sont les spécifications requises.
Avantages et limites de l'utilisation de ElevenLabs en temps réel
La nouvelle famille de modèles de ElevenLabs offre une variété d'avantages qui peuvent faciliter le développement de l'IA vocale. Toutefois, avant de passer à l'environnement de production, il est nécessaire d'évaluer les limitations techniques et les coûts.
Avantages attendus:
Optimisez la reconnaissance vocale, le modèle de langue et la production audio ensemble.
Capacité à gérer le flux et les interruptions naturels de la parole.
Soutenir plus de 90 langues.
Bénéficiez d'une vaste bibliothèque audio.
compatibilité du protocole avec l'API OpenAI en temps réel.
Distribution sur différents canaux de communication via OnzeAgents.
Le véhicule de soutien exige des tâches complexes.
Limites à l'attention:
L'API en temps réel utilise actuellement la connexion WebSocket; le support WebRTC n'est pas disponible.
Les opérations de capture et de lecture vocale par WebSocket devraient être gérées par le développeur.
Les fonctionnalités OnzeAgents avec l'API en temps réel fonctionnent séparément.
Le choix du modèle influe sur le coût total du volume d'utilisation et de la consommation de jetons.
Les performances réelles de production peuvent varier selon les conditions du réseau, la qualité sonore et l'architecture de l'application.
Par conséquent, les développeurs doivent seulement regarder le décalage de bout en bout, la précision de réponse et les taux de réussite des tâches qu'ils obtiennent dans leurs applications, non seulement les valeurs de performance décrites dans le modèle.
Comment ElevenLabs fonctionne-t-il en temps réel?
Le coût en ElevenLabs L'utilisation en temps réel varie selon le modèle préféré et la durée de la connexion.
En relation avec l'API en temps réel, la durée du volume et les jetons d'entrée utilisés sont chargés. Le prix publié sur la page de prix de ElevenLabs est listé comme v1 Mini pour minutes audio supplémentaires 0,08 dollars. Les jetons d'entrée sont facturés à partir de 0,20 par million de jetons et plus de 6 dollars par million de jetons.
minutes audio supplémentaires sur le modèle v1 Max à nouveau 0,008. Mais les jetons d'entrée sont 1,80 dollars pour 1 million de jetons, les jetons de sortie sont indiqués comme 9 dollars pour 1 million de jetons.
En utilisation via OnzeAgents, les frais de jeton du modèle en temps réel sont appliqués en plus des frais de minute standard. Par conséquent, les coûts de deux méthodes d'utilisation devraient être calculés séparément.
Les prix et la portée du plan peuvent modifier l'application avant la production Page de prix de l'API ElevenLabs Accueil vérifié.
Que faut - il considérer en temps réel dans le processus de développement de l'intelligence artificielle?
Le succès d'une application vocal AI dépend non seulement de la production de sons rapides. Le système doit pouvoir réagir correctement dans des situations inattendues, qui sont protégées dans le contexte de la parole.
Les développeurs doivent se concentrer sur particulièrement trois sujets.
Premièrement, la tolérance aux erreurs est importante dans les interactions vocales. Le bruit de fond, les différents accents, la vitesse de la parole et les termes techniques peuvent affecter la performance de la reconnaissance vocale. Par conséquent, le système devrait être testé avec différents profils d'utilisateurs.
Deuxièmement, les processus relatifs à la sécurité des données et à la protection des renseignements personnels devraient être abordés au cours de la phase de conception. Les enregistrements vocaux, les castings et les informations personnelles peuvent contenir des données sensibles. Il est nécessaire d'informer les utilisateurs sur les données traitées et la durée de conservation. ElevenLabs déclare qu'il offre le chiffrement, le placement des données et diverses options de compatibilité pour l'utilisation de l'entreprise. Toutefois, il convient de tenir compte du fait que chaque modèle et chaque option de mise en page des données ont la même compatibilité.
Enfin, les processus des agents vocaux peuvent être limités clairement. En particulier, les contrôles d'autorisation et de sécurité sont essentiels pour les agents qui accèdent aux données des clients, forment un rendez-vous ou traitent des systèmes externes.
Masqot et ElevenLabs sont organisés en coopération "Sesle Produce: Le webinaire intitulé "Intelligence artificielle Assistant" de Voiceover avec ElevenLabs, Les technologies audio soutenues par l'IA aborderont les innovations présentées. Dans l'événement qui se tiendra avec la participation de l'ambassadeur ElevenLabs Güldem Turan, le processus s'étendant de la technologie voix-chat (Speech-to-Speech) à l'audio du texte (Speech-to-Speech) sera évalué, les solutions offertes par la plateforme ElevenLabs et les applications qui peuvent être développées avec ces technologies. Le webinaire, qui se tiendra en ligne le vendredi 13 novembre, sera ouvert aux participants qui veulent explorer le domaine de la production sonore avec l'intelligence artificielle et apprendre des merveilles sur le sujet.
Foire aux questions
Qu'est-ce que ElevenLabs en temps réel?
ElevenLabs Le temps réel est la famille de modèles Speech-to-Speech, présentée pour améliorer les applications d'IA audio naturelles et à faible latence. Il optimise la reconnaissance de la parole, le modèle de langue, la gestion de la séquence vocale et la production audio ensemble.
Quelle est la différence entre Onze Realtime v1 Mini et v1 Max?
v1 Mini est conçu pour des expériences de conversation rapides, naturelles et à moindre coût. v1 Max a été développé pour être utilisé dans des instructions complexes, des opérations en plusieurs étapes et des tâches nécessitant un appel de véhicule.
ElevenLabs En temps réel Quel soutien linguistique ?
ElevenLabs déclare qu'onze modèles en temps réel offrent une prise en charge vocale dans plus de 90 langues. Les sons disponibles peuvent être sélectionnés dans la bibliothèque audio de la plateforme.
ElevenLabs API en temps réel Gratuit?
L'utilisation de l'API en temps réel est payée. Charger via le temps audio connecté et les jetons utilisés. Les prix actuels peuvent être contrôlés à partir de la page de prix API de ElevenLabs.
ElevenLabs Support WebRTC en temps réel?
C'est pas vrai. Disponible La connexion API en temps réel fonctionne via WebSocket. Par conséquent, il y a un changement dans l'architecture de connexion d'une intégration basée sur WebRTC.
ElevenLabs en temps réel avec l'API OpenAI en temps réel Peut-on être utilisé ensemble?
ElevenLabs Realtime supporte la structure de protocole et d'événement compatible avec l'API OpenAI Realtime. OpenAI disponible Les intégrations SDK en temps réel peuvent être dirigées vers l'infrastructure ElevenLabs en modifiant les paramètres de connexion et de modèle appropriés.
Auteur
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter