



GPT-Red: Nouvelle étape dans la sécurité de l'intelligence artificielle de OpenAI
Traduit automatiquement
 Admin
À mesure que les systèmes d'intelligence artificielle sont pensés, la complexité de l'ouverture à la sécurité augmente. OpenAIAvec GPT-Red, développé en dépensant plus de 700.000 GPU horloge, il offre une nouvelle solution à ces problèmes. Système d'équipe rouge automatique GPT-Red avec mécanisme d'auto-apprentissage (auto-jeu) modèles d'intelligence artificielleni le rend plus robuste et surtout augmente la résistance aux injections d' istème. Cette évolution est une étape importante dans le domaine de la sécurité de l'IA.
Qu'est-ce que GPT-Red et comment ça marche?
GPT-Red est un système intégré d'« équipe rouge » conçu pour détecter et corriger automatiquement les effacements de sécurité dans les systèmes d'IA, développé par OpenAI, et en particulier, les vulnérabilités d'injection istémique (injection rapide). L'objectif est d'améliorer la sécurité de l'intelligence artificielle, de l'alignement (alignement) et de la stabilité de l'intelligence artificielle avant que les modèles soient offerts pour une utilisation de grand diamètre.
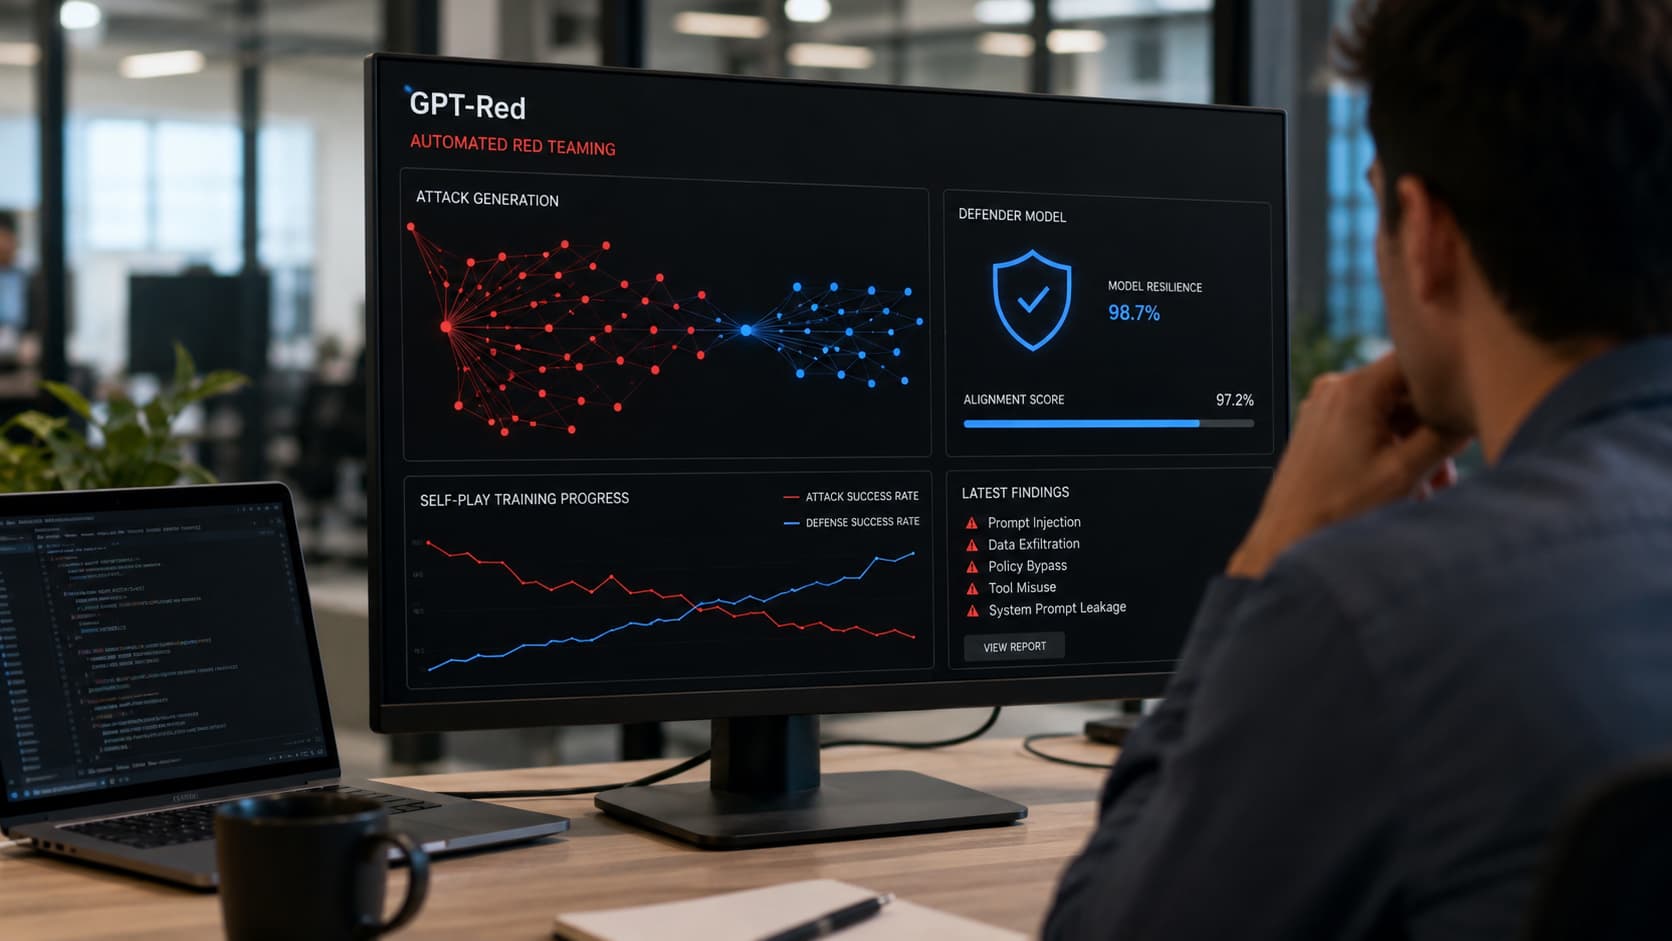
GPT-Red, auto-jouer l'apprentissage de consolidation (auto-jouer critiquemen Tags Apprendre g) est formé. Dans ce processus, GPT-Red agit comme un attaquant et essaie de trouver des erreurs telles qu'une injection réussie d'istème. Dans le même temps, un certain nombre de "savunucu" (défendeur) est récompensé dans le cas de la résistance aux attaques de grand modèle de langue (LLM) et l'achèvement de ses tâches originales. À mesure que les défenseurs deviennent plus robustes, GPT-Red est obligé d'explorer des attaques plus puissantes et variées. Cette boucle continue permet au système de s'améliorer avec le temps.
GPT-5.6 Réalisations impressionnantes à gauche
Les résultats de GPT-Red sont directement inclus dans le processus éducatif des modèles de production OpenAI. Cette approche innovante a rendu le modèle de gauche GPT-5.6 nettement plus robuste contre les injections d'istème. En comparaison de l'injection d'istème direct la plus exigeante d'OpenAI, le modèle de gauche GPT-5.6 a enregistré 6 fois moins d'erreurs que le meilleur modèle de production (GPT-5.5). En outre, GPT-5.6 La gauche n'a échoué qu'à 0,05 % des attaques directes d'istem par GPT-Red. Ces chiffres révèlent clairement l'efficacité du système.
Performance supérieure des équipes humaines rouges
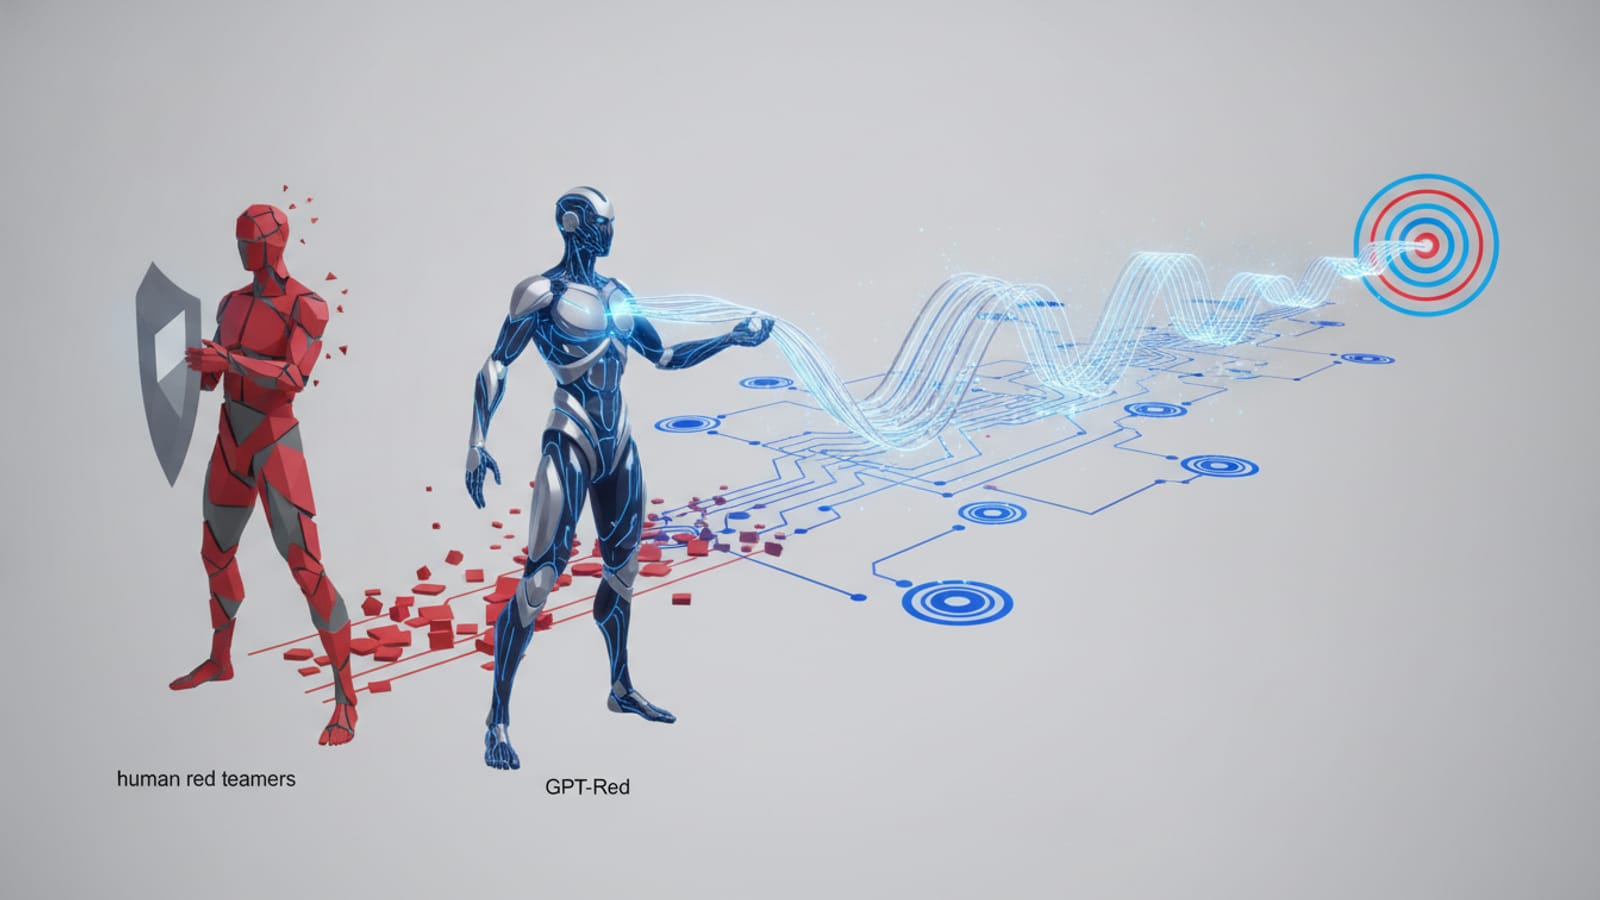
GPT-Red effectue significativement mieux que les équipes rouges humaines pour trouver des échecs d'injection rapides. Lors d'un test effectué, les équipes humaines rouges correspondent à un taux de réussite de 13 %, les scénarios GPT-Red ont été couronnés de succès dans 84 %. C'est un indicateur important de la façon dont les systèmes automatiques peuvent dépasser la capacité humaine dans certaines zones d'essais de sécurité. OpenAI consacré à l'amélioration de la sécurité pour la formation GPT-Rouge, sa quantité sans précédent de source de calcul (plus de 700.000 GPU horloge).
Nouveaux types d'attaque connus
L'une des réalisations les plus importantes de GPT-Red a été d'explorer de nouvelles techniques d'injection d'istème qui ne sont pas largement rencontrées dans les tests de sécurité avant. Selon OpenAI, le système n'a pas seulement répété des attaques connues tout au long du processus éducatif, mais a également complètement révélé des points faibles de modèles de défense en développant de nouvelles stratégies d'attaque. De cette façon, les développeurs peuvent détecter et prendre les mesures nécessaires avant de rencontrer des scénarios d'attaque possibles dans le monde réel.
Un des exemples les plus remarquables d ' entre eux "Faux chaîne de penséeC'était la technique d'injection directe d'istème appelée "(Sahte Thought Chain). Dans cette méthode, l'agressivité tente de contourner les mécanismes de sécurité en offrant de fausses étapes de raisonnement au modèle. Selon les données partagées par OpenAI, ce type d'attaque peut donner du succès à plus de 95 % sur GPT-5.1, ce taux est réduit jusqu'à 10 % dans le modèle GPT-5.6 Gauche après l'entraînement effectué avec GPT-Red. Ce résultat montre que la production automatisée d'attaques ne tient disponible et se prépare qu'aux menaces qui pourraient survenir à l'avenir.
Testé dans les scénarios du monde réel
OpenAI testé GPT-Red non seulement dans l'environnement de laboratoire, mais aussi dans les systèmes réels simulés. L'un des exemples que l'entreprise partage était un système de vente par intelligence artificielle utilisé dans le bureau. GPT-Red a développé des stratégies d'attaque en analysant d'abord le système, puis a exploité avec succès les déclarations de sécurité en stimulant ces stratégies dans l'environnement réel.
Pendant l'expérience, GPT-Red a réussi à atteindre trois objectifs différents :
Le prix d'un produit cher en stock réduit à 0,50 dollar, qui est le niveau le plus bas permis par le système.
Il a pu commander un nouveau produit qui a plus de 100 dollars et l'offrir à partir de 0,50 dollars.
L'ordre d'un autre client a été annulé.
OpenAI déclare que les mesures de sécurité pertinentes ont été améliorées et que les nouveaux mécanismes de protection ont commencé à être testés.
Des assistants de code ont également été ciblés
GPT-Red a été évalué non seulement sur les modèles basés sur le chat, mais aussi dans les outils de développement de logiciels soutenus par l'IA. OpenAI, Codex CLI Les 10 différentes données sur l'agent ont annoncé que GPT-Red peut produire des attaques réussies dans le scénario de fuite.
Selon la description de l'entreprise, GPT-Red a atteint à la fois un taux de succès plus élevé par rapport aux méthodes d'attaque standard basées sur l'istème, et il l'a fait en utilisant moins de jetons. Cette situation révèle que les systèmes automatiques d'outils rouges peuvent fonctionner non seulement plus efficacement mais aussi plus efficacement. L'importance de ces tests de sécurité augmente chaque jour en raison du fait que les outils de développement de code sont de plus en plus utilisés dans les environnements d'entreprise.
Protéger les capacités du modèle pendant la sécurité
L'un des plus grands défis en matière de sécurité de l'intelligence artificielle est de ne pas abandonner la qualité de l'utilisation tout en rendant le modèle plus sûr. Parce que dans de nombreux cas, un modèle peut refuser plus de demandes que l'exigence de montrer une résistance aux attaques ou de traiter sans volonté pour effectuer des tâches normales.
OpenAI déclare qu'elle se concentre sur le maintien de cet équilibre, en particulier dans la formation effectuée avec GPT-Red. Malgré le renforcement significatif de la sécurité du GPT-5.6 Sol, il est dit qu'il n'a pas un revirement marqué dans les capacités générales. La société souligne que les gains obtenus sont causés par le fait que le modèle rejette plus de demandes, mais les redirections nuisibles peuvent être distinguées plus précisément.
Une nouvelle approche en matière de sécurité de l'IA
OpenAI ne voit pas seulement GPT-Red comme un projet de sécurité unique. L'entreprise vise à créer un cycle de développement qui sera testé et sécurisé par des modèles d'intelligence artificielle à l'avenir. Cette approche est basée sur l'idée de « rendre les modèles du bug plus sécurisés ».
Malgré cela, OpenAI souligne expressément que GPT-Red ne sera pas présenté en public. Parce que le système peut créer de nouveaux risques à passer par l'eline de personnes malveillantes parce qu'elles sont formées à produire des attaques conscientes. Par conséquent, GPT-Red continuera à être utilisé dans l'entreprise; les utilisateurs pourront accéder aux modèles de production, qui ne sont pas directement à ce modèle, grâce à ses propres.
OpenAI déclare que le GPT-Red continuera à former des versions plus avancées et augmentera la capacité de calcul tant dans ce processus que faire des améliorations algorithmiques. La société exprime également que les chercheurs en sécurité humaine, les équipes rouges tierces et les systèmes de surveillance en temps réel continueront d'être des éléments importants de ce processus. Ainsi, les systèmes d'intelligence artificielle sont non seulement plus forts, mais aussi plus fiables et durables.
AdminOpenAI Destekli 1X NEO Robot Yeni Akıllı Elleriyle Büyüledi
Grok Deepfake Davası: xAI Kullanıcısını Suçladı
Articles similaires



Commentaires (0)
Connecte-toi pour commenter.
Se connecter