



Modèles turcs d'intelligence artificielle: BìLGE, Kumru, T3 AI et autres
Traduit automatiquement
 Auteur
Les grands modèles de langue ont un fait très basique qu'ils examinent tout en crochetant le monde: Peu importe le talent des modèles géants avec des sorties de vallée de silicone, le travail devient différent en ce qui concerne l'anglais. La plupart d'entre nous ont remarqué l'étrange traduction cochan phrases qui sont réunies lors de travailler avec ces modèles, sans signification des idiomes, ou simplement étendre un simple problème technique à un endroit inutile. Ici, à ce stade, les projets nationaux d'intelligence artificielle sont devenus une obligation technique et non seulement une fierté nationale.
Aujourd'hui, l'écosystème d'intelligence artificielle développé en Turquie n'est pas une interface simple devant les modèles OpenAI ou Anthropic. Une infrastructure solide est construite avec la contribution de communautés à source ouverte formées avec ses propres poids et axées directement sur la structure de pointe du turc.
Comment Denersin ?
Un bref tableau d'abord: comment accéder à ce modèle aujourd'hui et si le modèle est activé (14.10.2026).
Sommaire | Développeur | Comment y accéder ? | Extérieur / Intérieur |
|---|---|---|---|
Nouvelles | TUBITAK | Non encore ouvert à une utilisation générale; pour les projets pilotes © Copyright 2018. Tous droits réservés. via TUBITAK TICKET | Fermer |
Sommaire u | VNGRS | Sommaire démosu; Kumru-2B sur Hugging Face | 7,4B éteint, 2B ouvert (Apache 2.0) |
T3 AI | Fondation T3 et Baykar | Ouvert comme bêta à la plateforme sociale TEKNOFEST en 11.07.2025 | Cible open source; non partagé le poids téléchargeable |
Trendyol LLM | Sommaire | Visage bouillantTéléchargeable | Poids extérieur |
Sommaire | Université Bosphore TABILab |
Visage bouillantTéléchargeable
Utilisation scolaire ouverte et non commerciale à elle seule m
Sommaire
Sommaire
Privé aux institutions, plate-forme intégrée à l'institution
Fermer
Pourquoi les modèles mondiaux ne sont pas encore?
Alors que les IA mondiales sont formées avec des trilyons, une petite partie de ces données se composent de turc. Cette situation soulève deux grandes questions :
Déchets de jetons et facturation élevée :
les systèmes de jetons conçus selon l'anglais ne peuvent pas résoudre la racine et la logique supplémentaire du turc. Un mot simple divise 3-4 pièces (jeton). Cela ajoute les deux factures d'utilisation de l'API et prolonge le temps de génération de réponse système dans la barre.
Contexte culturel et juridique :
Il est assez risqué de prendre une analyse de contrat adaptée au code de commerce turc d'un modèle global ou de classer la plainte du client avec le bon sentiment. Parce que le modèle fait référence à la culture occidentale et à la logique du droit américain comme défaut.
Pour combler ce déficit, l'académie s'est concentrée sur le développement de modèles d'intelligence artificielle turque en combinant des initiatives publiques et indépendantes en Turquie.
Ce qu'il fonctionne sur le site? Modèles autochtones en vedette
Projets d'intelligence artificielle en Turquie Accueil; répond à différents besoins, des grandes infrastructures soutenues par l'État aux solutions agiles.
1. BÍLGE: Famille de modèles linguistiques étendus de TÜBÏTAK
L'étape la plus concrète et la plus complète du côté public est mise en œuvre par TÜBìTAK BìLGEM Nouvelles Le projet l'était. La plus grande revendication de BìLGE est d'utiliser le turc comme langue maternelle sans traduire d'une autre langue.
Différentes tailles pour différents besoins :
BìLGE n'est pas un modèle unique, une famille. Avec 1B conçu pour les appareils mobiles et terminaux, l'équilibre de performance et d'efficacité a été formé de 9B à zéro. BìLGE 27B a été développé avec la méthode de préformation continue avec des données turques. Conçu pour des tâches de raisonnement complexes, BìLGE 122B est encore en phase de développement.
Devasa Anglais Korpus:
La formation a commencé avec environ 1 billion de vocabulaire brut de données turques. 250 milliards de jetons de haute qualité ont été sélectionnés dans ce bassin et les données ont été enrichies de 500 milliards de données synthétiques. L'objectif est de saisir les idiomes, les applications et les termes techniques du modèle dans le contexte turc.
Faible consommation d'énergie et coût :
Il est destiné à dépenser moins de puissance de traitement parce qu'il utilise un jeton approprié au turc. Les institutions publiques sont conçues pour les applications ministérielles où la sécurité des données est essentielle.
Statut d'accès : Au 14.10.2026, le BìLGE n'est pas ouvert à l'usage général. Pour les projets pilotes selon le site officiel, TUBITAK TICKET peut être contacté. Les annonces relatives à l'accès n'ont été annoncées que par les canaux officiels de TÜBìTAK avec le Ministère de l'industrie et de la technologie.
2. Kumru AI: rapide, focalisé et léger
Dans le monde de l'aventure, les modèles se concentrent sur la fonctionnalité plutôt que d'entrer dans l'énorme course des paramètres. De Kumru AI, Une alternative LLM turque que les entreprises peuvent gérer sur leurs serveurs sans dépenser d'énormes budgets.
Texte abstrait, catégorisation des demandes des clients et établissement d'un dialogue naturel turc Modèle très réussifournit une grande vitesse de distractions sans supprimer les ressources matérielles.
VNGRS s'entraîne à partir de zéro pour les paramètres turcs Kumru 7,4 milliards et peut travailler sur un GPU avec 16 GB VRAM. Sommaire Vous pouvez essayer la démo dessus; 2 milliards de paramètres Kumru-2B est ouvert avec la licence Apache 2.0 sur Hugging Face. Pour les détails techniques et les limites Kumru AI guide Nouvelles Regardez.
3. T3 AI: Source ouverte et puissance communautaire
T3 AI développé dans Baykar association d'affaires avec Turkish Technology Team Foundation (T3 Foundation) représente la taille communautaire du travail. Dans le modèle 11.07.2025, TEKNOFEST a été ouvert à l'utilisation avec version bêta dans la plateforme sociale. Au cours de l'annonce, il a été annoncé de contribuer au projet de 1 792 bénévoles de 67 provinces.
Le projet dit qu'il a été développé comme open source; mais le nombre de paramètres et de poids du modèle n'étaient pas encore partagés où à télécharger. Si les poids sont ouverts, il peut être facile de former des modèles spéciaux dans des domaines tels que le droit ou la médecine.
4. Initiatives sur la colonne vertébrale universitaire et le poids extérieur
L'écosystème de la Turquie ne se limite pas à trois noms :
Trendyol LLM:
La première version de Trendyol LLM (2024) a été formée avec 10 milliards de jetons sur le modèle LLaMA 2 7B de Meta. Les prochaines versions ont passé les bases Qwen 2.5 7B, Qwen 3 8B et Gemma 3 12B. Trendyol-LLM-Aure-12B partagé en février 2026 peut également fonctionner et se fixer pour les tâches de commerce électronique, comme l'abstraction, question-cevap. Les modèles sont principalement partagés sur Hugging Face.
TOURNE :
TURNA, développé par TABIBAB à Boğaziçi University Computer Engineering Department, est un encodeur de 1,1 milliard de paramètres basé sur le cadre UL2, un modèle de langue turque. Conçu pour les tâches de compréhension et de production de texte et partagé pour la recherche universitaire non commerciale sur Hugging Face.
Patrimoine de Zemberek :
Open source Bibliothèque de traitement de langue naturelle anglaise SommaireUn des outils qui ont été appliqués pendant de nombreuses années dans des travaux de base tels que la solution root-ex.
5. GPT PRINCIPAL (HAVELSAN): Cerveau de défense autochtone et sécurité des entreprises
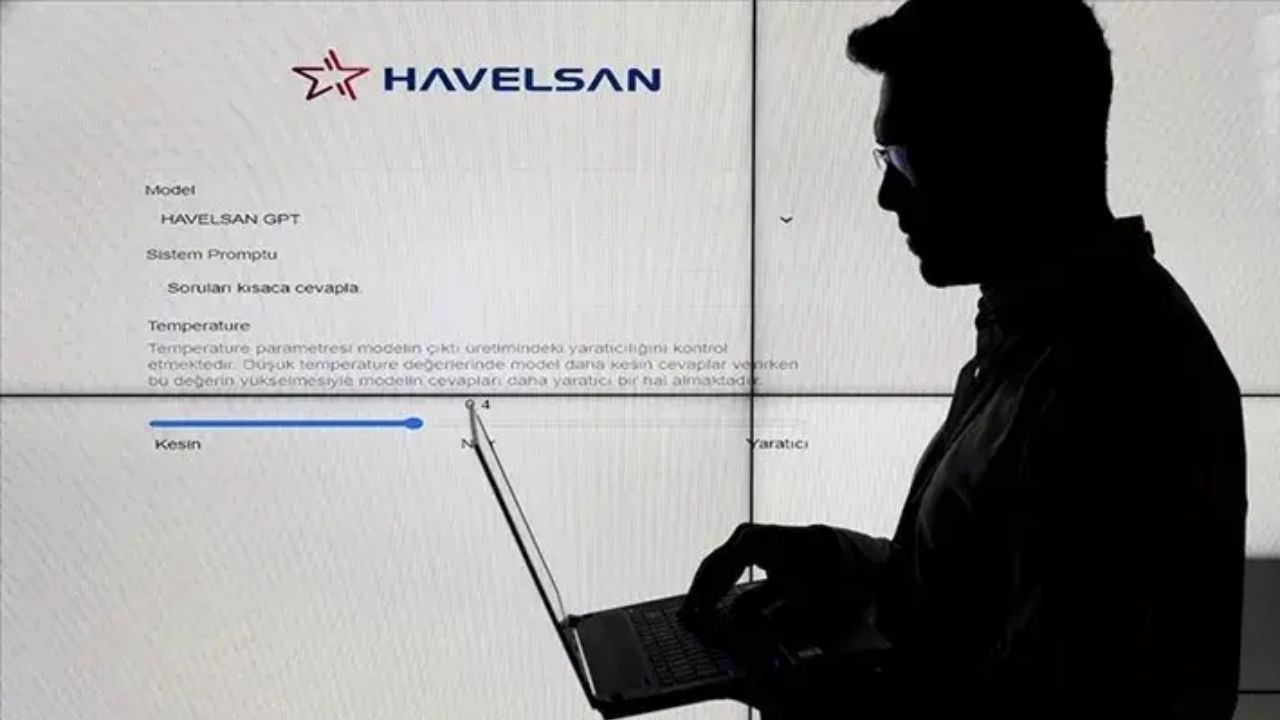
L'un des pieds les plus critiques des mouvements d'IA domestiques est jeté du côté de l'industrie de la défense et de la sécurité publique. Développé pour protéger la sécurité interne des données et des normes de confidentialité élevées par HAVELSAN GPT PRINCIPAL DE HAVELSAN Il se distingue comme l'une des infrastructures d'IA d'entreprise qui peut fonctionner hors de Turquie.
La racine (Multi Artificial Intelligence Network) promue au 01.02.2024 de Havelsan, est une plate-forme où les institutions peuvent établir un assistant d'intelligence artificielle basé sur leurs données. Le circuit fermé est conçu pour fonctionner; le but n'est pas de laisser les données à l'extérieur de l'établissement. Dans un premier temps, les œuvres basées sur le texte; l'abstraction de contenu est capable de traiter les informations à partir de données open source et de l'écriture de code.
6. Aigency: Initiative de modèle de langue turque à terme
Şanlıurfa-based eCloud Software Technologies a commencé à se développer en 2022 Aidese présente comme l'un des premiers modèles linguistiques nationaux en Turquie. D'après les informations sur la presse locale, Meta.LLaMA est basé sur 3 modèles et se concentre sur la production de texte turc, l'analyse de contenu et les processus de communication d'entreprise. Une évaluation indépendante du modèle n'a pas encore été publiée.
Aperçu des modèles:
Sommaire | Développeur | Échelle/approche | Objectif de base | Plus grand Plus |
|---|---|---|---|---|
Nouvelles | TUBITAK | 1B, 9B, 27B (122B est développé) | Domaine public, corporatif, numérique | 1 pool de données brutes trilyon, altyap domestique |
Kumru AI | VNGRS | 7,4B d'entraînement à zéro; 2B ouvert | Traitement des documents internes (B2B), résumé |
Faible coût du serveur, temps de réponse rapide
T3 AI
Fondation T3 et Baykar
Nombre de paramètres non divulgué
LLM turc basé sur la communauté
Ensemble de données volontaires, cible de l'écosystème open source
Trendyol LLM
Technologie Trendyol
7B - Poids extérieur 12B
Commerce électronique et dialogue avec les clients
Intégration directe dans des scénarios pratiques
HOME GPT
Sommaire
Modèle de langage intégré et isolé
Défense, sécurité des données publiques et d'entreprise
Fonctionnement en circuit fermé (sur site)
Aide
Logiciel eCloud
Architecture linguistique en début de phase
Production de texte et communication d'entreprise
Initiative à court terme axée sur la production de textes turcs
Pourquoi important pour les développeurs et les entreprises?
Choisir un modèle de langue maternelle n'est pas seulement l'idée de « nous soutenons la technologie de base » ; accueillir directement les avantages des entreprises intéressées par leurs processus de poche et juridiques :
KVKK et sécurité des données :
Un sérieux mal de tête dû à la réglementation d'une banque, d'un hôpital ou d'un site de commerce électronique pour recevoir les données des utilisateurs et les envoyer à une API à l'étranger. Les modèles locaux ne quittent pas les données de l'institution car ils peuvent travailler directement sur leur serveur (sur site).
Moins de matériel, plus de vitesse :
Au lieu de centaines de milliards de paramètres en vrac modèles, vous pouvez facilement exécuter sur un seul segment intermédiaire GPU, un 7B ou 14B modèle compact formé pour un travail spécifique. C'est pourquoi les coûts du serveur et de l'électricité sont sérieusement réduits.
Dépendance en cas de rupture :
Les sociétés mondiales d'intelligence artificielle peuvent doubler les prix de l'API la nuit ou restreindre l'accès à votre entreprise pour s'arrêter. Poids extérieurs Visage bouillant modèles natifs que vous pouvez télécharger à partir de plates-formes comme, vous permettent de garder votre architecture logicielle complètement dans votre propre contrôle.
Avec l'ouverture de ressources nationales comme TRUBA et la réalisation de l'expérience logicielle acquise dans l'industrie de la défense (ASELSAN, HavelsAN), la production d'intelligence artificielle en Turquie s'étend rapidement à la base. Maintenant, il ne s'agit pas seulement d'imprimer du texte, de créer des systèmes autonomes qui comprennent vraiment notre culture et notre langue maternelle. Les modèles autochtones repoussent également complètement la colonne vertébrale de cette indépendance.
Écrire l'avenir avec notre propre code
La race de l'intelligence artificielle est maintenant mesurée non seulement avec qui a une plus grande ferme de serveurs, mais aussi avec quel degré de réalisme elle touche les besoins locaux de cette technologie. Les modèles développés en Turquie; au lieu de copier les moules prêts à l'emploi, il est placé dans une ligne qui presse beaucoup plus de pieds, se concentrant sur la résolution des subtilités du turc, fournissant la sécurité des données et réduisant les coûts opérationnels des entreprises. Ce point, du pouvoir d'entreprise de TICGE, Kumru AI et T3 AI, montre qu'une infrastructure technologique indépendante qui pense et produit dans sa propre langue n'est plus un appel, mais une réalité tangible. Pour construire l'avenir avec nos propres codes au lieu de consommer avec d'autres algorithmes, l'étape la plus critique nous pouvons sauter à l'ère numérique.
Certaines des entreprises derrière ces modèles Les entreprises turques d'IA qui se démarquent en 2026 Home On est dans l'article. Pour les détails techniques de Kumru Guide Kumru AI regardez les personnes travaillant sur des modèles de langue turque Communautés Masqot Tu peux te rencontrer.
AuteurDario Amodei'den Yapay Zeka Uyarısı: Sektör Yalan Söyledi
Gemini Ücretli mi? Ücretsiz Sürüm ve Tüm Planlar (2026)
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter