



Nouvelle révolution de Meta: Sam Audio Artificial Intelligence Model!
Traduit automatiquement
 Admin
Meta AI est un grand écho dans le monde du traitement d'images "Modèle de segmentEn stimulant l'architecture de "(SAM) dans le monde du son, il a lancé un nouveau paradigme dans l'écosystème de l'IA. SAM Audiovise à modifier les normes numériques de traitement audio à partir de la racine avec la capacité d'identifier, séparer et isoler les objets audio dans des environnements acoustiques complexes. Ce modèle est traité comme un "obje" indépendant de chaque élément audio dans un enregistrement audio, tout comme il peut choisir chaque objet sur une photo.
Qu'est-ce que SAM Audio?
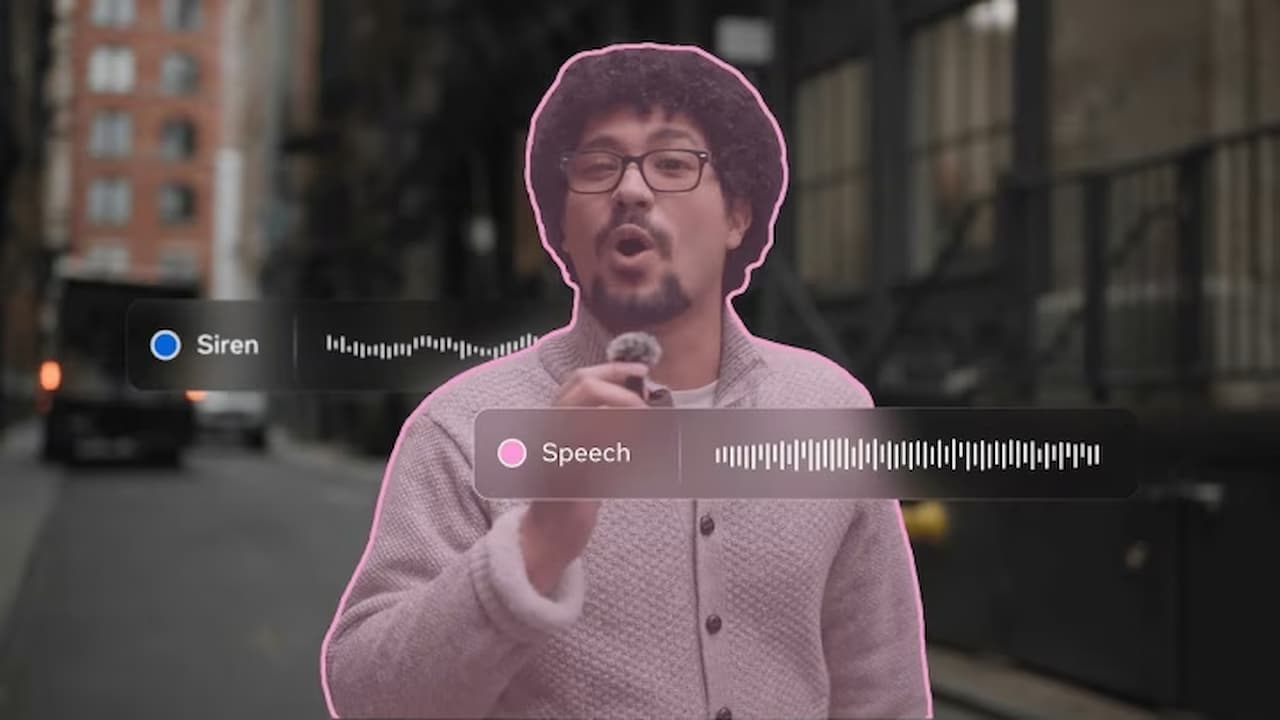
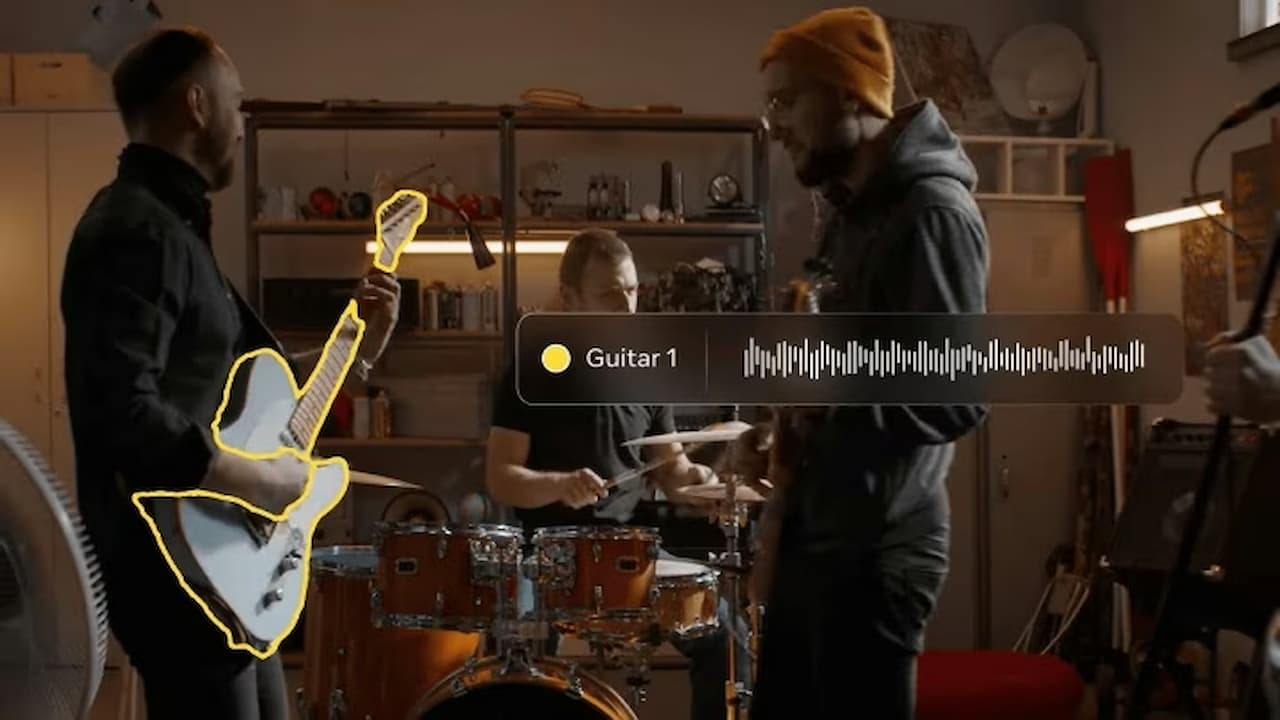
SAM AudioChaque source audio (voix humain, instrument, voix animale, bruit mécanique, etc.) est un modèle de base de l'intelligence artificielle qui identifie indépendamment comme un « objet visuel » et les distingue parfaitement les uns des autres. Contrairement au logiciel d'édition audio traditionnel, ce modèle sonne non seulement comme une forme d'onde, chacun voit la combinaison de parties avec différents caractères. Cette situation donne aux utilisateurs la liberté de couper et coller des parties d'une photo comme sur un enregistrement sonore.
Capacité technique et analyse concurrentielle Accueil
Derrière le succès de SAM Audio, Meta Transformateur architecture basée et formation sur une énorme bibliothèque audio. Le son des ordinateurs est normalement composé de fréquences complexes à l'intérieur. Mais SAM Audio résout ce problème avec :
- Analyse de la signature acoustique : Le modèle sait que chaque voix a un "empreinte digitale". Ils comprennent la différence tactique du son du fil d'une guitare avec un fil vif et les placent en couches séparées.
- Zéro exemple d'apprentissage : Ce terme signifie que même une voix que le modèle n'a jamais rencontrée auparavant, il peut être perçu comme un « danger et un son séparé ». Par exemple, la voix d'un aspirateur nouvellement produit peut séparer le son de la télévision sur le fond même si ce n'est pas dans l'ensemble de formation.
AI audio actuels (OpenAIÉtiquettes ElevenLabs etc.) "Le texte à la parole" est concentré; c'est-à-dire prend un texte et le convertit en voix humaine. Mais SAM Audio, un "Ses segmentation et manipulation" modèle. Cela l'amène à une position « mimar », plutôt qu'un « producteur » qui peut séparer et réorganiser les parties de l'univers sonore.
Objection de la voix
Des modèles comme ElevenLabs produisent le son en un seul et même ensemble. SAM L'audio définit chaque élément dans un fichier audio (par exemple le bruit de climatisation en arrière-plan, la voix de souffle de l'enceinte et l'écho sur la pièce) comme des objets indépendants.
Différence: Tandis que d'autres modèles essaient d'imprimer du bruit, SAM Audio bruit "slow". Cela peut enlever seulement partie indésirable avec une précision chirurgicale sans endommager le son original du tout.
Nature et sensibilisation acoustique
Bien que OpenAI Les modèles de voix offrent une grande naturalité, ils donnent souvent les meilleurs résultats dans des environnements stériles en studio. La supériorité technique de SAM Audio, son acoustique spatiale Accueil Compris.
Émo Tonification : SAM Audio analyse non seulement la fréquence de la voix, les accents émotionnels à l'intérieur et s'arrête comme "anlamsal". Il a la capacité de traitement en distinguant le son des vibrations (micro-hythmes) qu'une voix a peur ou applaudit.
Faible délai et efficacité
SAM Audio, Meta "Un segmenteur efficace" Construit sur l'architecture. Au lieu de lire tout le fichier pendant le traitement des données audio, cette architecture fait fonctionner simultanément en séparant la voix en petit « jeton ».
Avantage technique: Alors que les opérations complexes d'autres modèles (le clonage ou le nettoyage de la voix) prennent des périodes plus longues sur les serveurs cloud, SAM Audio fonctionne avec beaucoup moins de latence grâce à sa structure optimisée. C'est elle. Postes en direct et traductions en temps réel pour une avance sur ses concurrents.
Capacité et flexibilité Zero-Shot
Les modèles OpenAI et ElevenLabs nécessitent généralement une formation intensive sur certaines langues et tonalités audio. SAM Audio peut instantanément identifier et isoler une voix (par exemple un outil de musique très rare) avec sa capacité de "Zero-shot". Cela prouve que le modèle ne pilule pas dans les catégories prédéfinies.
Comment utiliser?
Meta, SAM Audio Depuis que le modèle (comme au stade de la découverte) n'a pas encore été ajouté à des applications telles que WhatsApp ou Instagram pour le dernier utilisateur. Mais il y a deux façons principales d'utiliser cette technologie :
Pages de démonstration et de recherche Meta AI
Meta, de nouveaux modèles sont souvent Recherche sur l'IA Meta Le site offre des démos interactives.
- Étape 1: Allez sur le site officiel de Meta AI.
- Étape 2: Télécharger un fichier audio dans la section démo.
- Étape 3: Cliquez sur la région que vous voulez séparer sur le Specogramme (carte visuelle audio) ou tapez un script comme "il suffit de laisser la voix humaine" dans la zone de texte.
- Étape 4: Écoutez et téléchargez les couches audio que le modèle ne sépare pas.
Pour les développeurs et les utilisateurs techniques
SAM Audio est un modèle de base avec code open source. Si vous connaissez Python au niveau de base, ou si vous êtes un programmeur:
- Accès au code : Meta GitHub Vous pouvez télécharger les poids et les codes du modèle de la page à votre ordinateur.
- Hugging Face : Ces modèles sont optimisés par la communauté Hugging Face Vous pouvez tester directement sur le navigateur.
- Utilisation de l'API : Pour améliorer vos propres applications, vous pouvez ajouter la bibliothèque du modèle à votre projet.
Utilisations et effets quotidiens
SAM Audio est un outil pratique et puissant au-delà d'un succès théorique avec la possibilité de séparer les données audio en parties:
- Accessibilité : Solves "Kokteyl Party Problème" dans les appareils auditifs. Dans des environnements bruyants comme le café ou le restaurant; des objets singuliers comme le fourk-byek et le tourbillon font le son du haut-parleur cible seulement.
- Production: Minimise les erreurs de tournage dans le cinéma et la production de contenu. Une ambulance ou un son de vent qui remonte sans perturber le dialogue dans les tirs externes peut être retiré du disque "comme tiré avec pince à pince". Müzisyens peut séparer les anciens disques en quelques secondes de voix et d'instruments.
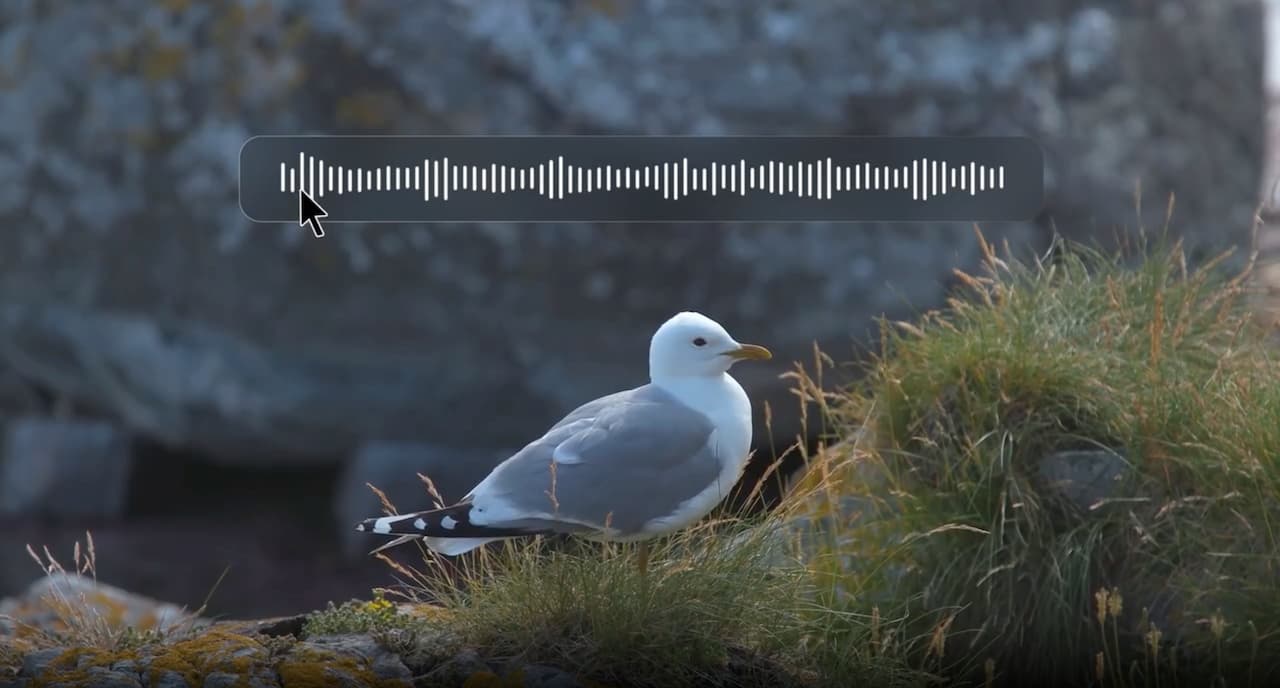
- Sécurité et science : Détecte instantanément des sons spécifiques tels que des fractures de verre ou des cris en sécurité urbaine. Dans le domaine des sciences de la nature, il facilite le suivi écologique en isolant le son d'un seul type vivant grâce à un relevé forestier complexe.
La manipulation parfaite des sons de ce, la contrefaçon numérique (profonde) et le risque de violation de la vie privée. Mais Meta place ce modèle comme une technologie plus créative et accessible.
Ce modèle dans un proche avenir Systèmes d'exploitation smartphone intégré. Cela signifie l'édition instantanée du bruit environnemental dans les appels téléphoniques sans le besoin de logiciels professionnels de couches audio dans les vidéos capturées.
Comment utiliser dans un avenir proche?
Lorsque la technologie est devenue la dernière, elle va entrer dans notre vie de cette manière sans exiger une connaissance technique spéciale:
Meta SAM Audio La technologie convertit le son en objets numériques pouvant être contrôlés à partir de données simples. Téléphones intelligents Contrairement au blocage de bruit standard, le son fait une intervention chirurgicale par opposition. Dans un appel téléphonique, le bébé qui pleure au dos ou dans la rue est complètement séparé du haut-parleur; les sons externes sont détruits par la précision du studio et seule une voix claire est transmise du côté opposé.
Médias sociaux et montage vidéo Le modèle donne à l'utilisateur une « gomme visuelle » en séparant le canal audio en morceaux comme un puzzle. Dans la phase de chargement vidéo, les sons indésirables des sons définis automatiquement tels que le vent, les oiseaux ou le trafic peuvent être supprimés par un seul clic. SAM Audio vous permet de produire un contenu de qualité professionnelle en remplissant la cavité audio supprimée d'un silence naturel.
Aides auditives dans le champ, "Kokteyl Party Problem". Grâce au "Mode Solving" les utilisateurs peuvent coder et jalouse comme "objet non désiré" sur la table latérale. Cette technologie améliore l'interaction sociale depuis la racine, permettant à l'appareil de transmettre uniquement les sons ciblés dans le cristal transparent.
AdminHIX AI: Çok Yönlü İçerik Üretim Platformu Rehberi
Stream Ring: Yapay Zeka ile Güçlendirilmiş Akıllı Yüzük Satışa Açıldı!
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter